因果图为何必要——以及为何它常常缺席
反事实问题听起来很简单:“如果患者接受了另一种治疗会怎样”,“如果我们提价,需求会如何变化”。难点在于,这些问题的答案无法仅从观察到的相关性中推导出来。我们需要一个关于变量之间如何相互影响的模型——也就是因果结构。
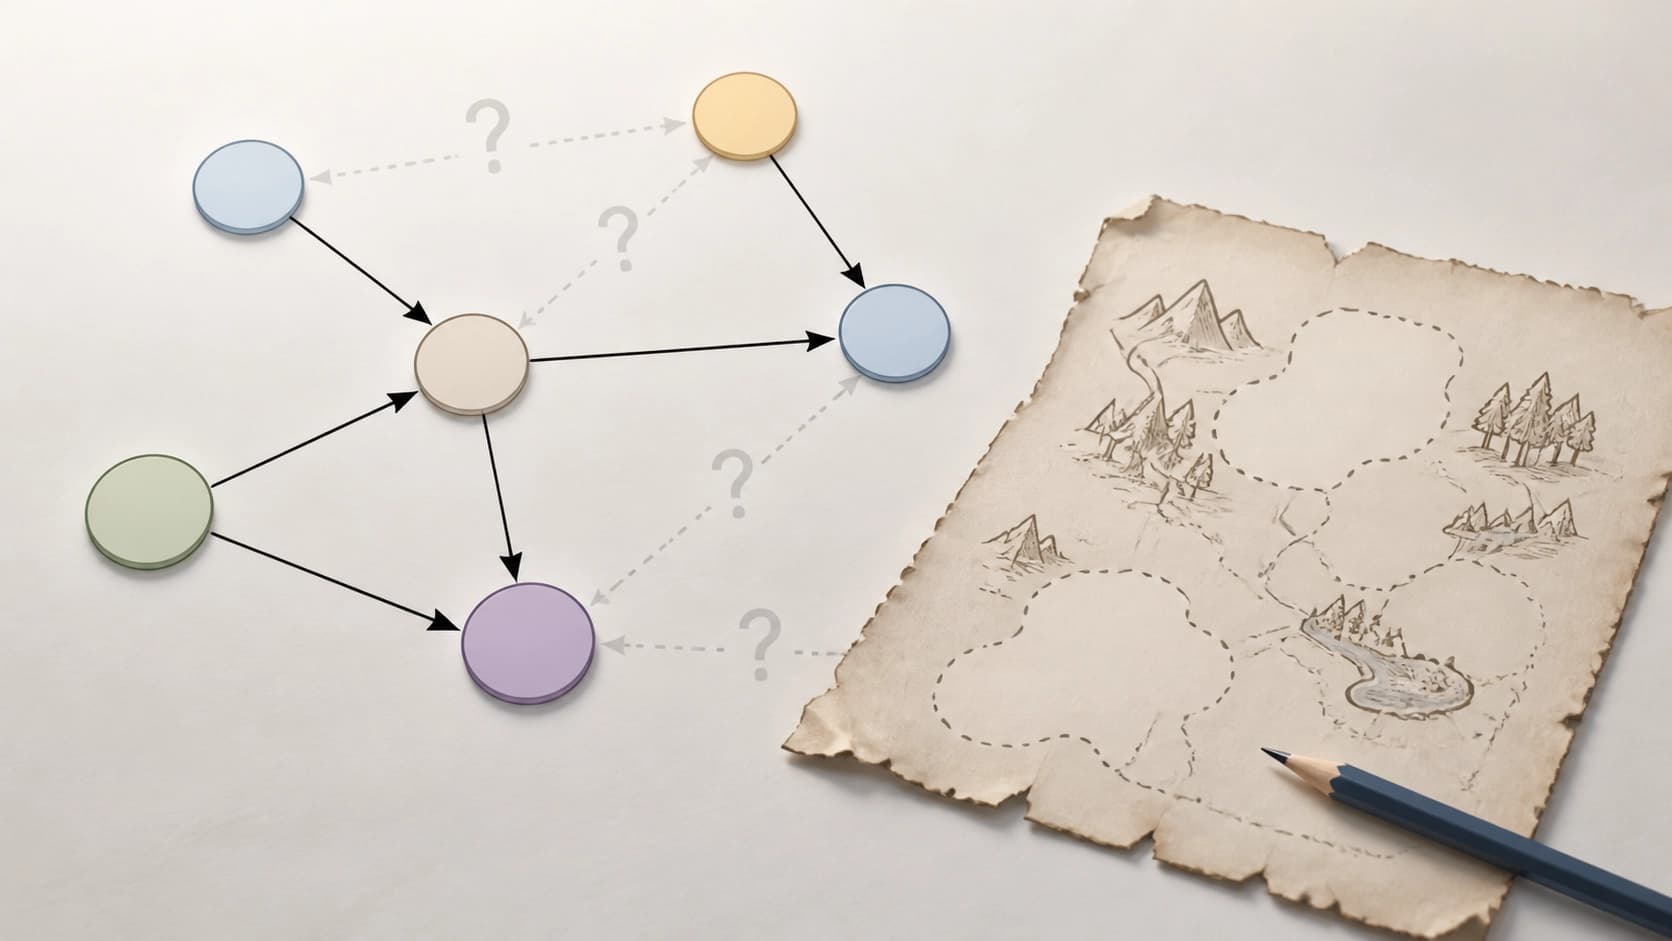
非参数识别文献中的经典方案是这样的:取一个完全指定的因果图,加入关于机制形式的假设——然后计算感兴趣的量的取值或其允许范围。这种方法可靠,但依赖于一种分析师几乎从不拥有的奢侈条件。领域知识只被部分了解,部分关联存在争议,部分变量根本无法测量。在这种情况下,完整的图不是起点,而是遥不可及的理想。
正是这种理论与实践的落差,Eric Rossetto 和 Alessandro Antonucci 在论文 Partial Identification under Causal Orders by Linear Programming(arXiv:2608.24427)中试图弥合。他们的做法不是“随便把图补全”,而是彻底放弃将其作为输入的要求。
查询本身会提示结构
作者的核心观察可以这样表述:反事实查询不是一个中立的问题,而是一个具有内在逻辑的对象。当我们问“如果变量 X 取值为 x 会怎样”时,我们其实已经在隐含地把变量置于某种关系之中:一个先于另一个,一个依赖于另一个,第三个则保持为背景条件。
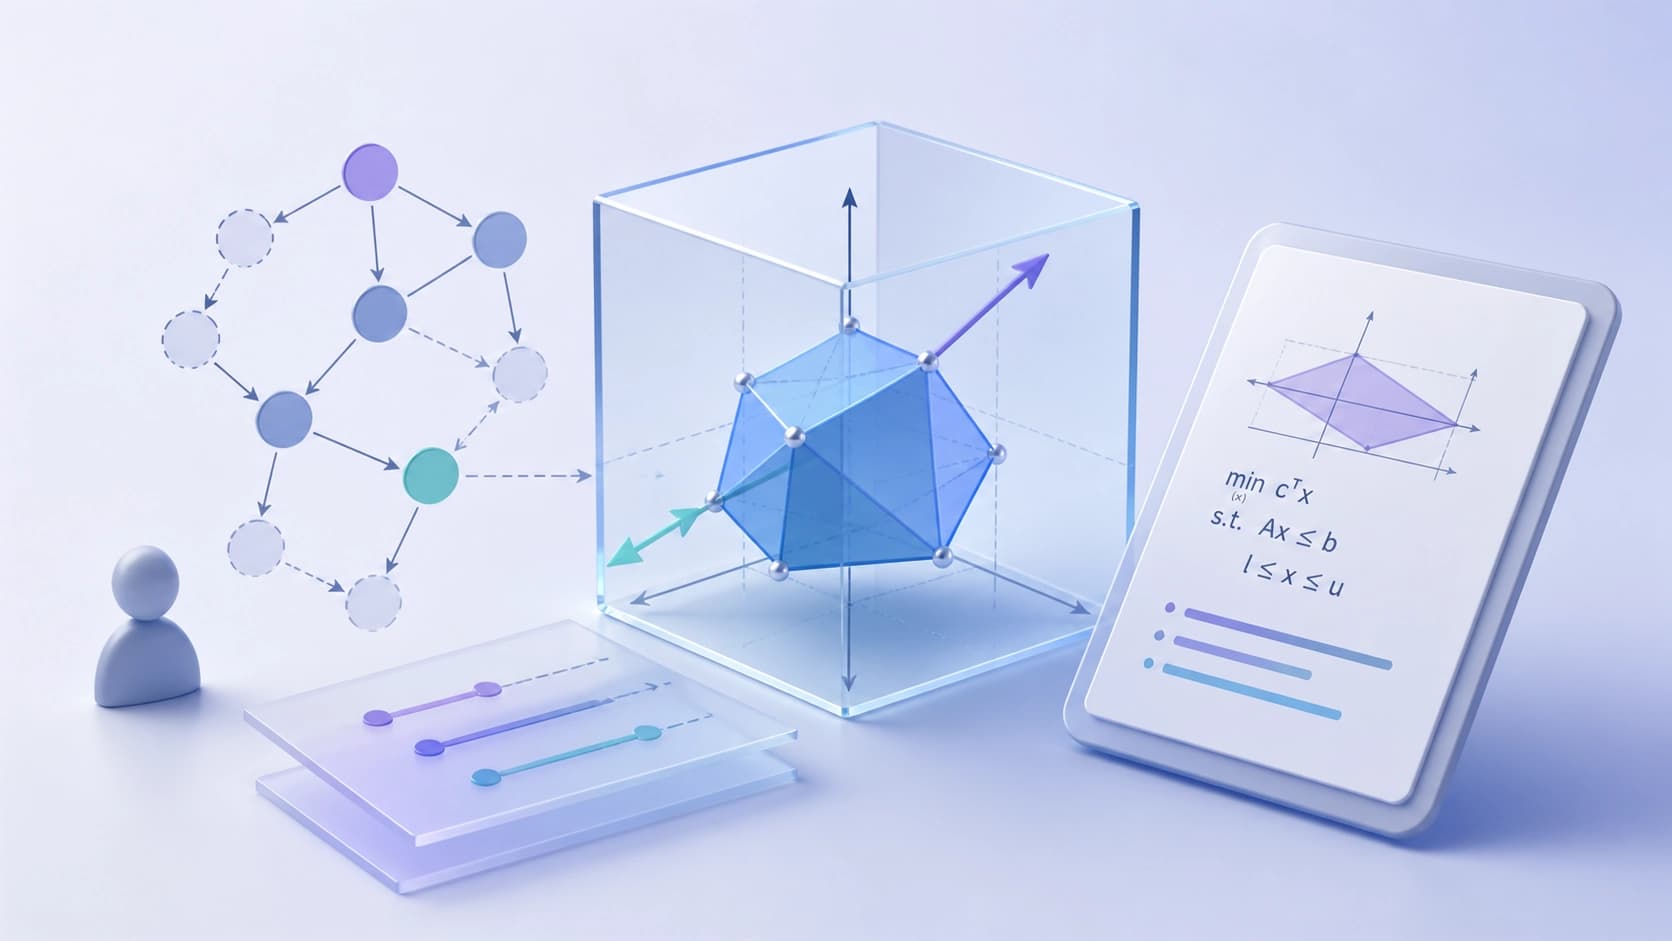
这一点通过拓扑序来形式化。在通常的因果图中,这种序是完全且唯一确定的:如果存在从 A 到 B 的箭头,那么 A 就在前。但对于识别而言,完全有序并不必要。偏序就足够了——即一组“先于”关系,它们并不覆盖所有变量对。其余变量对只是保持无序,而这并不妨碍工作。
该工作的核心结果是:任何反事实查询都会在其涉及的变量上生成恰恰这样——一般情况下是偏序的——拓扑序。而且这个序不需要猜测或手动引入:它可以从问题本身的表述中提取出来。领域专家不再需要回答“画出整个图”这个令人为难的问题;只需认可从问题设定中自然得出的内容即可。
从序到线性规划
接下来是技术部分,也是这一切的初衷所在。有了序,就可以把查询写成显式的参数化形式。这里的参数不是任意的,而是受结构约束的:它们描述分布和机制,使其既与观测数据一致,也与推导出的序一致。
经过这样的重参数化之后,识别问题不再是关于函数的问题,而变成了关于数值的问题。具体来说——变成了一个线性规划:需要在线性约束所定义的集合上最小化和最大化一个线性泛函。最小值和最大值就给出了感兴趣量的下界和上界。
这一转化之所以有价值,不仅在于其优雅。线性规划是一个研究充分的领域,拥有可靠的求解器,而把问题转化为这种形式意味着边界可以被真正计算出来,而不仅仅是证明其存在。该方案适用于任意反事实查询,包括嵌套查询:即假设情景本身内部还包含另一个假设情景的情况。嵌套一直是现有方法的痛点,因为它要求同时处理世界的多个“层次”。
边界有多窄
得到某种边界并不难——问题在于它们是否有用。如果区间几乎覆盖了所有可想象的取值,那它的价值就不大。
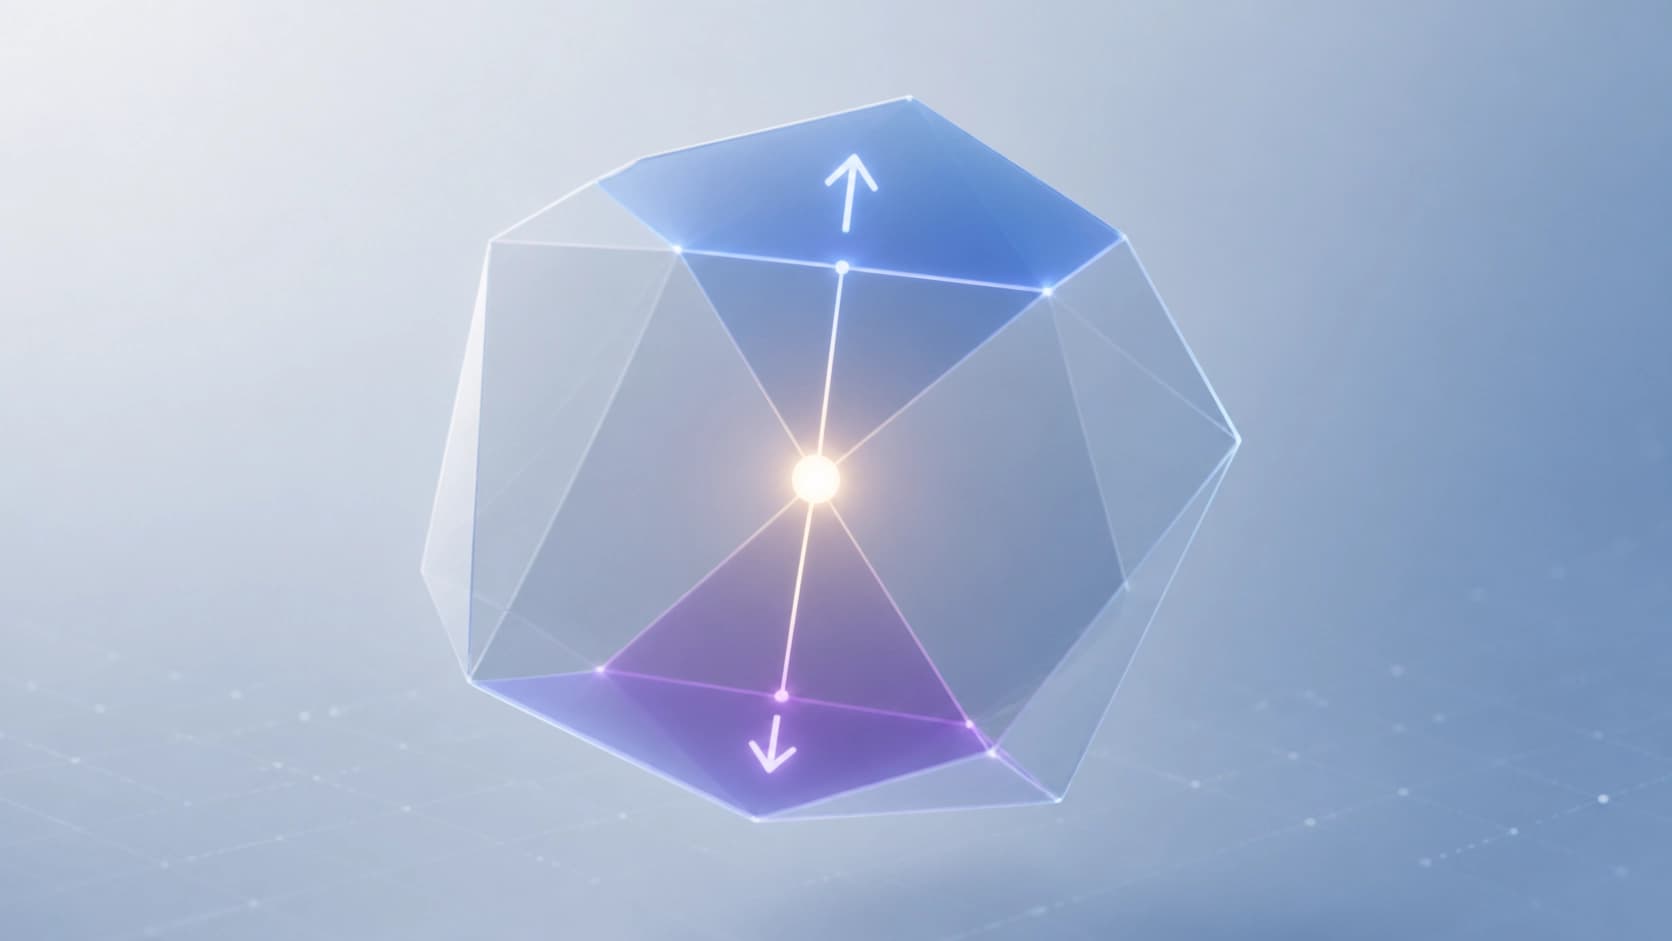
作者通过精确性证明来回应这一点。构造思路是:对每个边界都构造一个能达到它的结构因果模型。这样的模型必须同时与两件事相容——观测到的数据分布,以及查询所隐含的那个序。如果模型存在,就说明边界不是人为的:在不失去与可用信息一致性的前提下,无法把它向内移动。因此,在给定假设下,这个区间已经窄到了可能的极限。
这是结果地位上的一个重要转变。这里说的不是“粗略的拍脑袋估计”,也不是“最坏情况下什么都可能”。这里说的是对不确定性的诚实描述:这就是所能断言的全部,一步也不能再多。
与经典框架的联系
该工作被定位为对 Tian 和 Pearl 于 2000 年提出的因果概率方法的推广。那个框架也能给出区间而非点估计,但它绑定于特定类别的量,并要求已知结构。新结果扩展了查询类别,并取消了必须知道完整图的要求。记住这种传承是有益的:我们面对的不是从零开始的发明,而是对已经过时间检验之物的审慎扩展。
在熟悉的例子上验证
为了表明该方法并非奇技淫巧,作者回到文献中此前分析过的几个案例,并将它们跑一遍自己的流程。实验条件很严格:完全不输入因果图。取而代之的,只是从查询表述中得出的那个序。
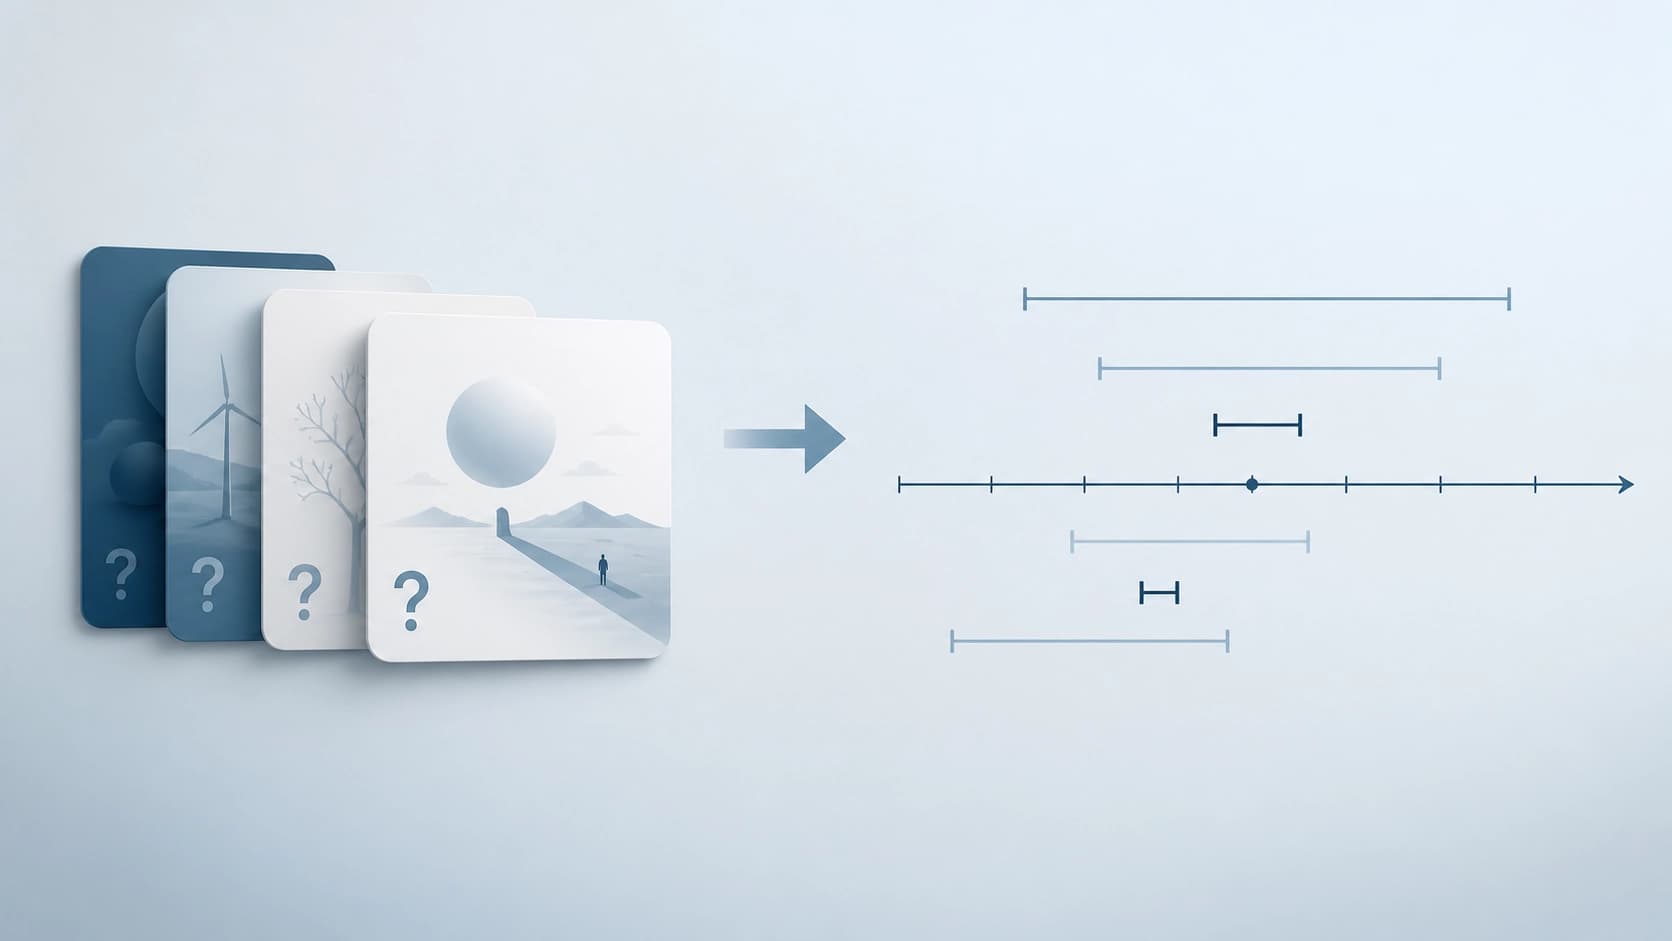
研究者报告的结果是:所得到的区间仍然具有信息量。换言之,放弃完整图并不会把结论变成毫无内容的“一切皆有可能”。这或许是这篇文章最实用的结论:无知的代价比人们通常以为的要低。
这对实践意味着什么
其实践价值可归结为几点。
- 降低了入门门槛。 不需要描述整个系统——只需认可问题设定本身已经隐含的那个序即可。
- 不确定性变得可见。 分析师得到的不再是背后隐藏着任意假设的点估计,而是一个区间,并明白其知识边界究竟在哪里。
- 有了工具基础。 归约为线性规划意味着计算可以用标准工具自动化,而不必为每一类查询单独编写求解器。
- 可接受的问题类别扩大了。 此前需要单独理论的嵌套反事实构造,如今被纳入统一框架。
该方法不承诺什么
也应当指出其边界。首先,偏序仍然需要被正确地提取:如果从查询表述中推导出了错误的前驱关系,边界的合理性就会丧失。其次,区间的宽度直接取决于观测数据有多丰富、能确定多少关系:序越稀疏,答案就越宽。该方法并不取代领域知识——它让你能够用领域知识的片段来工作,而不是面对缺失的整体。
论文篇幅为 15 页正文,另附三个附录、三张图和三个表格,因此证明的技术细节被放在正文之外,可单独查阅。对于那些在系统描述存在缺漏的真实数据上做因果推断的人来说,这或许比又一个带有未说明假设的点估计更值得关注。