
OpenAI обещает: её чип Jalapeño окажется быстрее и экономичнее решений конкурентов
В компании утверждают, что разработанный с Broadcom процессор для инференса обходит ускорители Nvidia по энергоэффективности и скорости ответа в тестах на нескольких ИИ-моделях. Развернуть чипы в небольших объёмах планируют уже до конца года, но полностью заменять парк Nvidia не собираются.
OpenAI делает ставку на чип Jalapeño: быстрее, экономичнее и уже почти в продаже
Когда речь заходит о развертывании больших языковых моделей, инженерам постоянно приходится искать компромисс: либо система отвечает очень быстро, но с трудом выдерживает поток запросов, либо она способна переваривать огромные нагрузки, но ценой заметных задержек. В OpenAI уверены, что нашли решение, которое снимает это противоречие. Собственный чип компании, получивший название Jalapeño, по заявлению разработчиков, демонстрирует одновременно и низкую задержку, и высокую пропускную способность. По словам вице-президента OpenAI по аппаратному обеспечению Ричарда Хо, новинка предлагает «лучшее из двух миров».
Jalapeño — это не универсальный процессор, а заказная интегральная схема (ASIC), созданная в партнерстве с Broadcom. Чип заточен под конкретную задачу — инференс, то есть непосредственный запуск обученных моделей для выполнения задач и работы агентов. Анонсированный еще в июне, сейчас он впервые получил официальные результаты тестов, которые компания не стесняется называть революционными.
Что показали тесты производительности
Для оценки возможностей чипа в OpenAI использовали собственную бенчмарк-платформу InferenceX. В качестве эталона для сравнения брались лучшие зафиксированные результаты на суперчипах Nvidia GB200 и GB300. Испытания проводились на трех популярных моделях: GPT-OSS 120B, DeepSeek R1 и Kimi K2.5 1T.
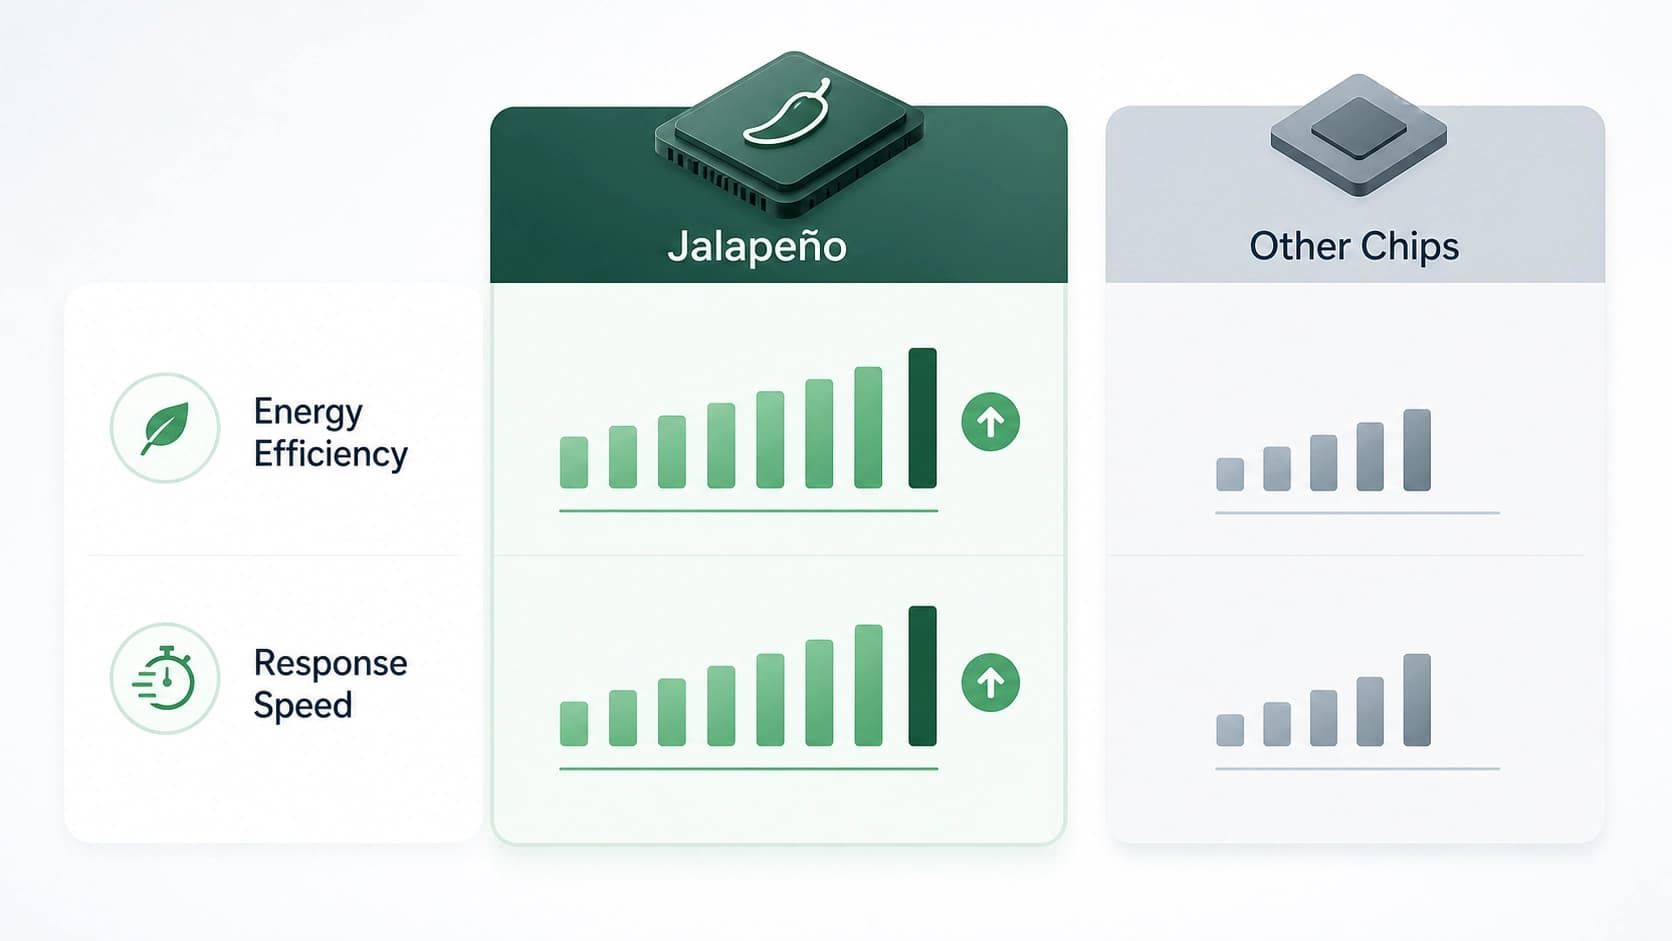
Компания заявляет, что результаты оказались впечатляющими. В зависимости от модели, Jalapeño продемонстрировал в 1,5–1,9 раза больше вычислений на ватт, чем системы конкурентов. Проще говоря, это означает, что на каждый затраченный киловатт энергии новый чип совершает значительно больше полезной работы. Это критически важно в эпоху, когда счета за электричество для дата-центров становятся одной из главных статей расходов.
Еще более заметна разница в скорости отклика. Сквозная задержка на трех протестированных моделях оказалась в 1,7–3,6 раза ниже по сравнению с эталонными системами на чипах Nvidia. На практике это выражается в более быстрых ответах ассистентов, более отзывчивых действиях ИИ-агентов и стабильном доступе к сервисам даже при пиковых нагрузках. Чем быстрее модель обрабатывает запрос, тем меньше пользователю приходится смотреть на индикатор "печати" ответа.
Стратегия: не замена, а дополнение
Несмотря на столь радужные показатели, в OpenAI не собираются отказываться от сотрудничества с Nvidia. Ричард Хо подчеркивает, что общая вычислительная стратегия компании предполагает использование широкого круга партнеров, и Nvidia остается одним из ключевых. Jalapeño не заменит существующий парк чипов, а скорее станет важным элементом масштабирования инфраструктуры.
Первое поколение чипа планируют развернуть в «небольших объемах» уже до конца текущего года. Полномасштабное наращивание мощностей начнется в 2027 году. Компания намеренно не раскрывает точное количество чипов, которое планирует задействовать в следующем году. При этом работа уже идет над вторым и третьим поколениями Jalapeño, что говорит о долгосрочности этого направления — в отличие от многих экспериментов, которые так и не доходят до практической стадии.
Успех этого проекта может существенно снизить зависимость операторов больших ИИ-моделей от ограниченного числа поставщиков чипов. Собственные ASIC позволяют точнее подгонять архитектуру под конкретные алгоритмы и рабочие нагрузки OpenAI, экономя ресурсы и ускоряя вывод новых продуктов на рынок.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Канонические полиномиальные инварианты в диагностике сбоев RL-симуляторов: где они действительно полезны
Работа проверяет, оправдано ли включение физических законов в обучаемые модели динамики: инварианты, извлечённые из траекторий и приведённые к каноническому виду через базисы Грёбнера, дают скромный выигрыш в прогнозах, но оказываются сильны в диагностике — они позволяют локализовать нарушенное ограничение и выявить конкретный ошибочный параметр.
10 ноября 2026
AURA-Eval: как проверить, что LLM-агент распознал риск и изменил следующий шаг
Фреймворк оценивает поведение LLM-агентов не по финальному вердикту, а по реакции на риск в ключевых точках: траектории вызовов инструментов прерываются, после чего модель должна продолжить рассуждение и действие, а панель LLM-судей разбирает обнаружение риска, характер и безопасность шага. На 1249 заданиях, собранных из 157 траекторий R-Judge, у 20 моделей небезопасные действия учащаются при отсутствии безопасного пути, а снятие надзора до выполнения переводит 52,3% изначально безопасных случаев в небезопасные.
10 ноября 2026
Память резервуара Черна — Саймонса: самостоятельная динамика связности и перенос плотности
В статье разбирается, как резервуар сохраняет историю входных сигналов одновременно в распределении плотности и геометрических степенях свободы. Сравнение четырёх механизмов показывает, что ток создаёт отдельную компоненту связности, меняющую последующий отклик плотности, а учёт всех измеренных признаков даёт небольшой прирост в декодировании порядка импульсов.
10 ноября 2026