
Os sinais de trânsito são controlados pelo modelo VLA VLALight: geração de ações diretamente a partir de vídeos de câmaras rodoviárias
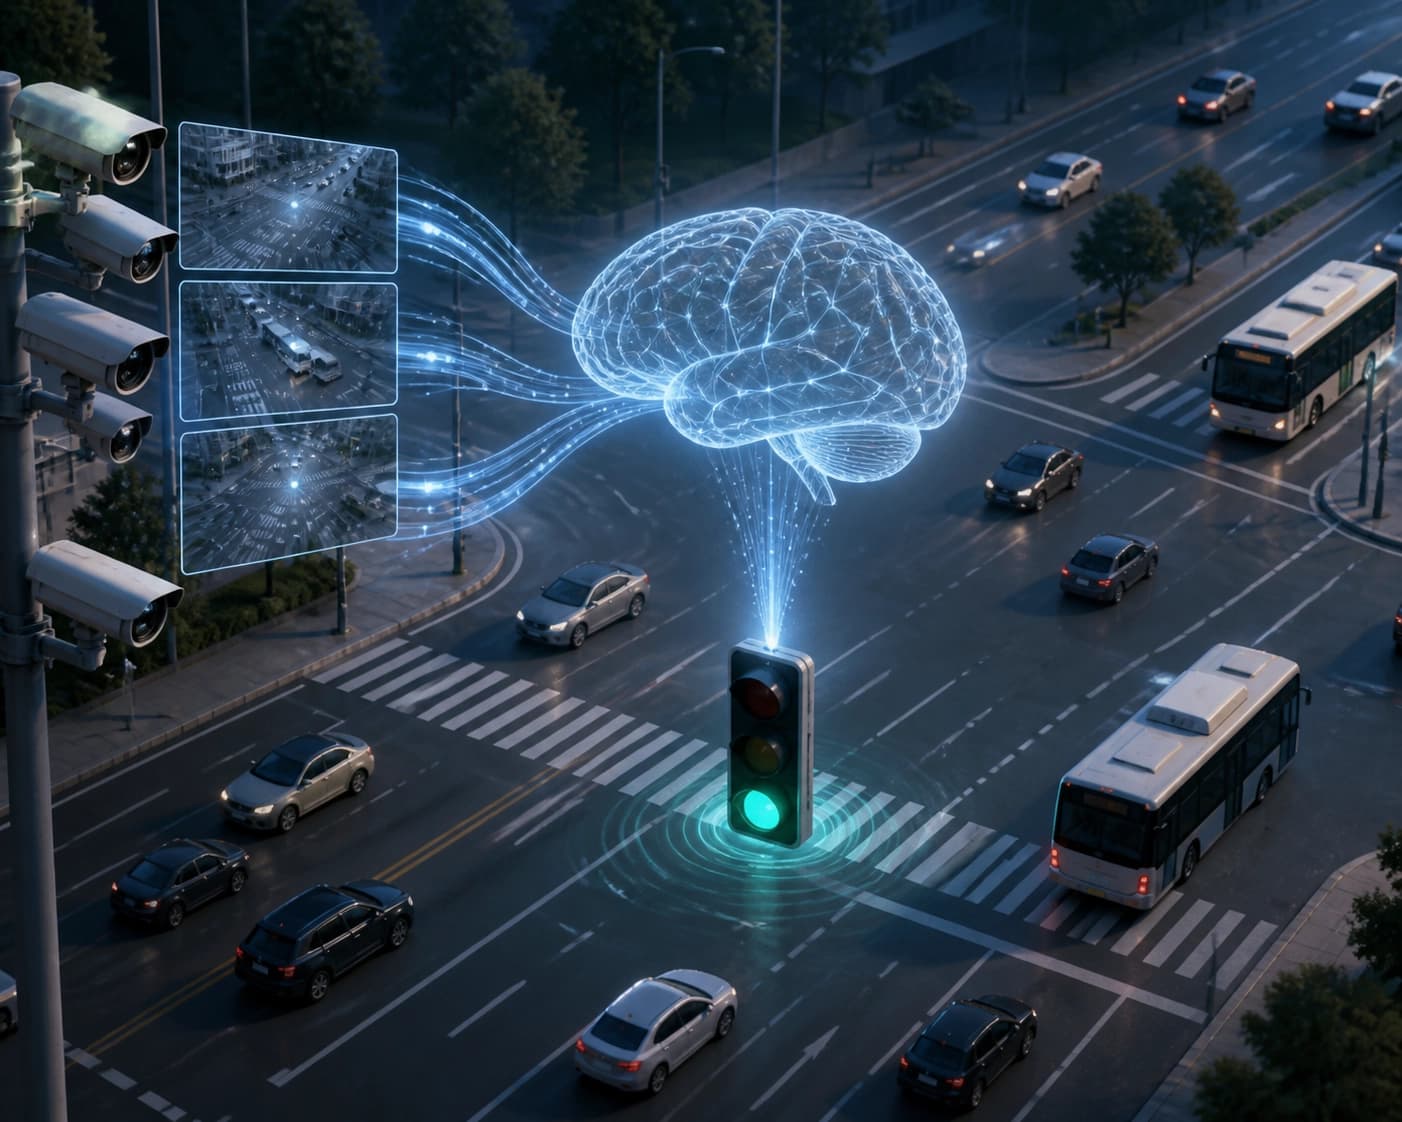
Os autores apresentam o VLALight — um modelo de ponta a ponta da classe «visão — linguagem — ação», que converte diretamente gravações de várias câmaras de um cruzamento em mudanças nos sinais, sem recorrer a estados do fluxo de tráfego definidos manualmente. A abordagem combina perceção que tem em conta a topologia do cruzamento, aprendizagem por reforço à escala da rede urbana e seleção adaptativa entre raciocínio rápido e aprofundado; em sete conjuntos de dados reais de três cidades, a solução superou as linhas de base baseadas em modelos de tráfego, aprendizagem por reforço e LLM/VLM.
O que é um modelo VLA para o controlo de semáforos
VLALight é um modelo de visão-linguagem-ação para o controlo de semáforos. Autores: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu. O artigo foi submetido a 29 de setembro de 2026. Este é o primeiro modelo VLA para o controlo de semáforos de ponta a ponta com base em vídeos multivista de câmaras instaladas à beira da estrada.
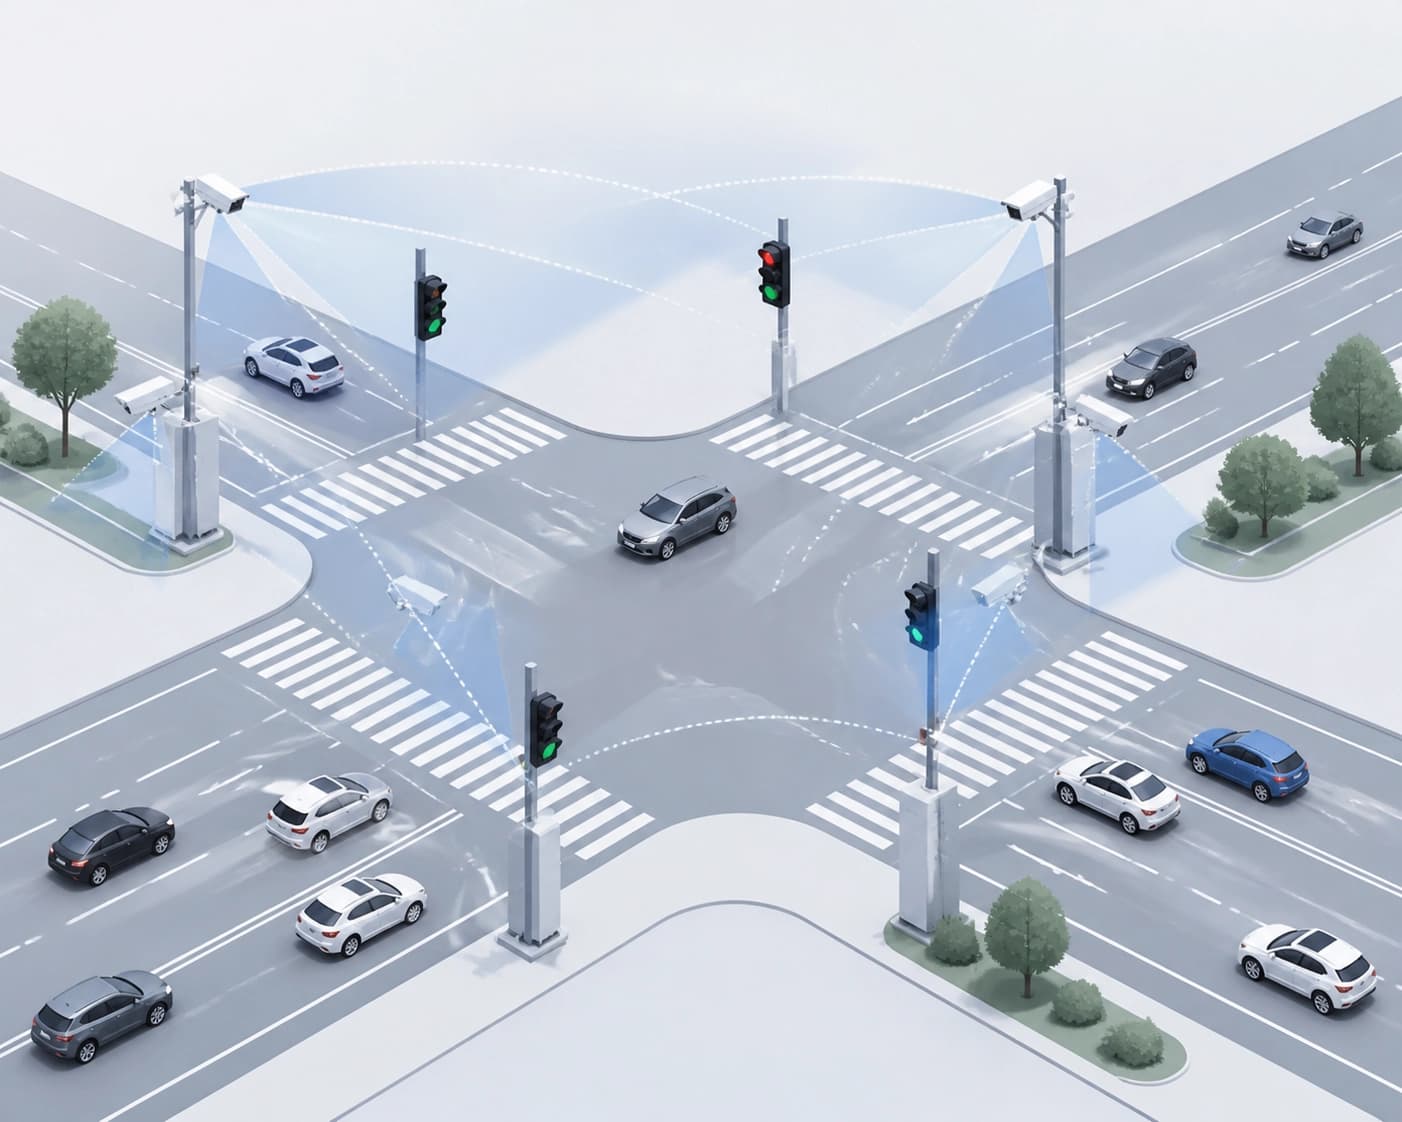
O modelo transforma diretamente observações visuais em ações coordenadas dos semáforos. Utiliza raciocínio espaciotemporal sobre múltiplos objetivos. Também tem em conta topologicamente a perceção conjunta nos cruzamentos.
Principais características da abordagem:
- Inferência de ponta a ponta: as observações visuais são convertidas em ações dos semáforos.
- Vídeos multivista: os dados provêm de câmaras instaladas à beira da estrada.
- Raciocínio espaciotemporal: o modelo tem em conta múltiplos objetivos.
- Consideração topológica: perceção conjunta nos cruzamentos.
Critério de escolha: a abordagem VLA combina perceção e controlo num único modelo. Isto distingue-a das abordagens em que estas tarefas estão separadas. A ligação de ponta a ponta entre vídeo e ações é o critério principal.
Como o VLALight é treinado: duas etapas
O treino do VLALight inclui uma estratégia em duas etapas. Primeiro, aplica-se o supervised cold-start. Este desenvolve a compreensão visual da situação rodoviária e a tomada de decisões sobre os sinais. Depois, aplica-se o cooperative agentic reinforcement learning.
A segunda etapa otimiza conjuntamente o controlo local e a eficiência global da rede de transportes. A primeira etapa ocupa-se da compreensão da cena e dos sinais. A segunda etapa otimiza o controlo local e a rede.
| Etapa | Tarefa | O que otimiza |
|---|---|---|
| Supervised cold-start | Compreensão visual da situação rodoviária e tomada de decisões sobre os sinais | Competências iniciais do modelo |
| Cooperative agentic reinforcement learning | Otimização conjunta | Controlo local e eficiência da rede |
Critério de escolha: verificar se a abordagem inclui otimização conjunta ao nível da rede. As decisões locais sem contexto de rede limitam o efeito. As duas etapas separam o treino da perceção da otimização da interação.
Modos de raciocínio adaptativos e custo de inferência
O VLALight utiliza modos adaptativos de raciocínio rápido e lento. O raciocínio mais profundo só é aplicado quando oferece benefícios suficientes para o controlo. O modelo utiliza rollouts adaptados ao modo equilibrados e otimização da vantagem relativa. O modelo aprende a encontrar um equilíbrio entre a qualidade das decisões e o custo de inferência.
| Modo | Condição de ativação | Efeito |
|---|---|---|
| Rápido | O raciocínio profundo não oferece benefícios suficientes | Menor custo de inferência |
| Lento | O raciocínio profundo oferece benefícios suficientes | Decisões de maior qualidade |
Critério de escolha: equilíbrio entre a qualidade das decisões e o custo de inferência. Os modos devem alternar com base nos benefícios para o controlo. Operar sempre no nível máximo de profundidade aumenta o custo.
O que os experimentos demonstraram
Os experimentos foram realizados em sete conjuntos de dados sobre fluxos de tráfego reais. Abrangem três redes urbanas. O VLALight superou os métodos de referência. Entre estes encontram-se modelos de transporte, aprendizagem por reforço e LLM/VLM.
| Classe de métodos de referência | Papel na comparação |
|---|---|
| Modelos de transporte | Referência de base |
| Aprendizagem por reforço | Referência de base |
| LLM/VLM | Referência de base |
Os estudos de ablação confirmaram a eficácia da perceção conjunta, da otimização ao nível da rede e do raciocínio adaptativo. Os autores assinalam o potencial dos modelos VLA para o controlo de sistemas de transporte físicos reais.
Critério de escolha: verificar a composição dos métodos de referência e a existência de estudos de ablação. Os experimentos abrangem tráfego real e três redes urbanas. O contributo de cada componente deve ser confirmado separadamente.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Anotação híbrida de imagens: a automatização acelera o treino de modelos de visão por computador
O artigo descreve como a pré-anotação por algoritmos reduz o trabalho manual e melhora a qualidade dos conjuntos de dados de treino, bem como por que motivo a verificação por amostragem humana continua a ser necessária. São abordadas as limitações do método em condições difíceis de captura e em tipos de objetos raros.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026