
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
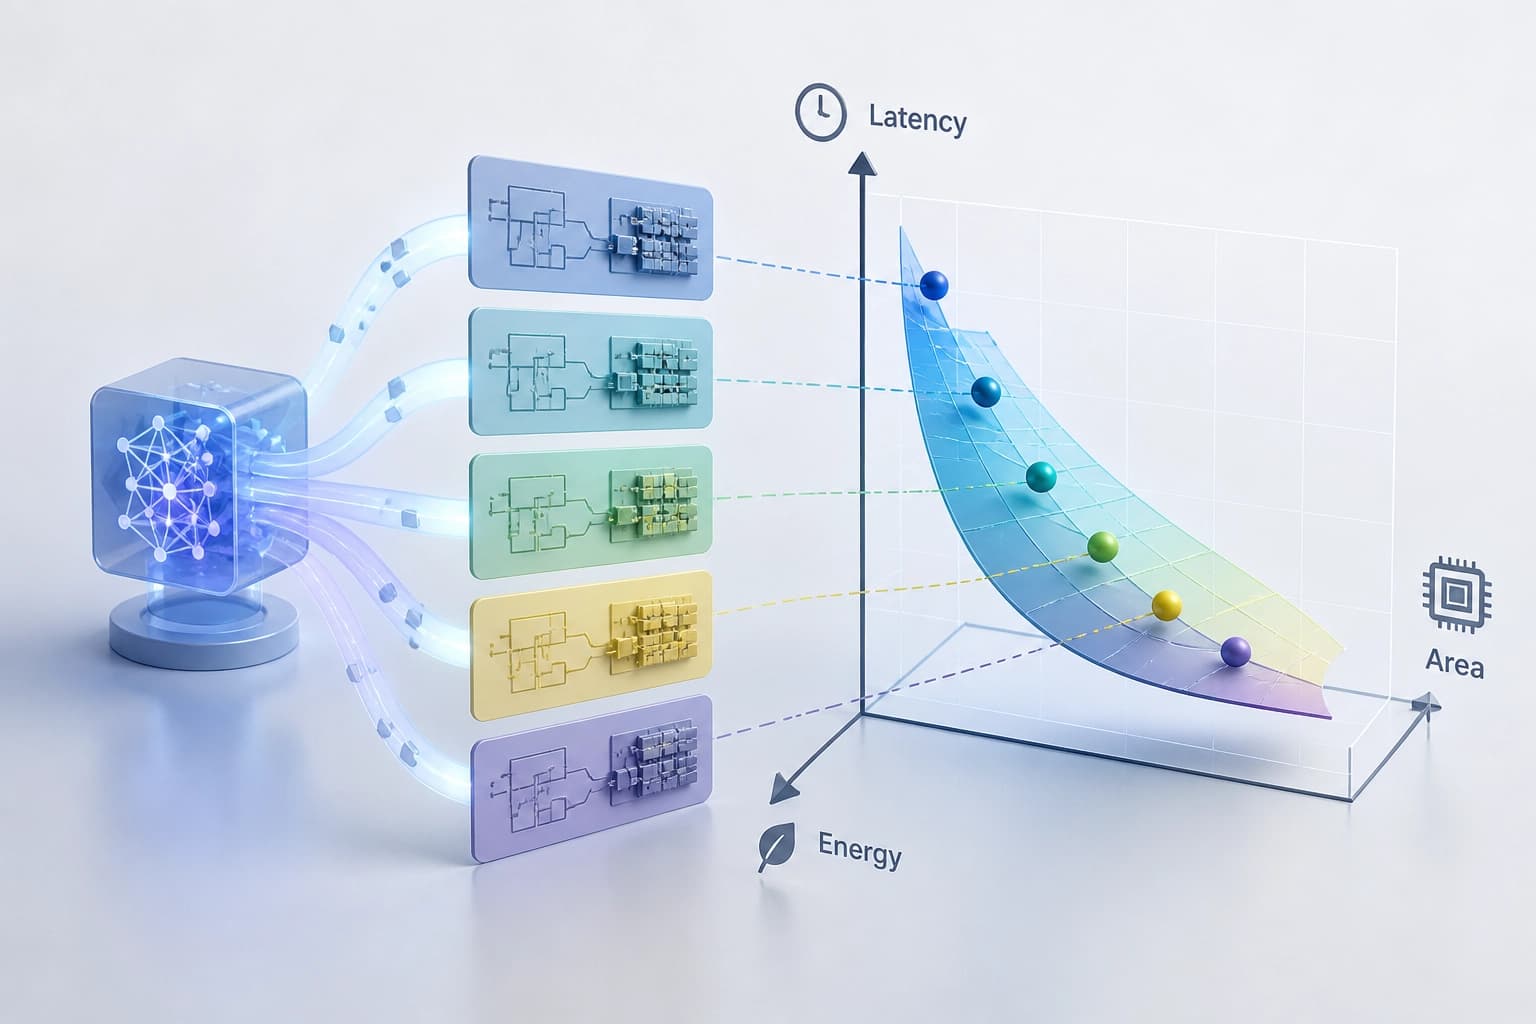
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
Trabalho e estado
- Título: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- Autores: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- Data de submissão: 16 de outubro de 2026.
- Estado: os comentários indicam que o trabalho foi aceite na COLM 2026.
O preprint está disponível como arXiv:2610.26904. O trabalho aborda a geração de RTL com modelos de linguagem de grande dimensão. O método treina o modelo para produzir não um único circuito, mas um conjunto de candidatos. Esse conjunto é avaliado no espaço PPA.
Conclusão: o trabalho foi aceite na COLM 2026 e propõe uma abordagem multiobjetivo para a síntese de RTL com LLMs. Para escolher uma abordagem, é importante a própria mudança de objetivo — de um único circuito para um conjunto.
O problema da recompensa escalar
As abordagens existentes combinam vários objetivos numa única recompensa escalar. Isso dificulta a obtenção simultânea de soluções diversificadas e ótimas de Pareto. Torna-se difícil alcançar diferentes compromissos entre baixo consumo de energia, baixa latência e pequena área. A recompensa escalar fixa a importância dos objetivos antes da geração.
A importância relativa dos objetivos depende dos requisitos do produto e das restrições do projeto. Uma recompensa definida antecipadamente não se adapta a esses requisitos. Por isso, é necessário um conjunto de candidatos com diferentes compromissos.
| Abordagem | O que otimiza | Quando é escolhido o compromisso |
|---|---|---|
| Recompensa escalar | Um circuito com base na soma dos objetivos | Antes da geração |
| Abordagem multiobjetivo | Um conjunto de circuitos na fronteira de Pareto | Depois da geração |
Conclusão: a recompensa escalar fixa o compromisso antes da geração. A formulação multiobjetivo transfere a escolha para a etapa posterior à geração.
O que o método otimiza
O método otimiza a qualidade e a diversidade do conjunto completo de circuitos. O conjunto é produzido por várias gerações. A avaliação é feita no espaço de objetivos PPA: Power, Performance, Area. O método não tem como objetivo otimizar a qualidade de um único circuito.
Os objetivos PPA envolvem compromissos. Diferentes circuitos oferecem combinações distintas de baixo consumo de energia, baixa latência e pequena área. Por isso, o método treina o modelo para cobrir diferentes pontos da fronteira de Pareto. O projetista obtém vários candidatos.
Conclusão: o método visa cobrir a fronteira, não encontrar uma única melhor resposta.
Dois elementos do método
Pipeline de treino baseado em gerações
O pipeline transforma a melhoria da cobertura de todo o conjunto de soluções de Pareto numa tarefa sequencial de geração de circuitos. O treino decorre por etapas. A tarefa de geração adquire uma estrutura sequencial.
Recompensa baseada na contribuição para o Hypervolume
A função de recompensa HVC mede a contribuição do circuito gerado para a fronteira de Pareto. A recompensa reflete não a qualidade absoluta de um circuito individual, mas o aumento da cobertura. A HVC liga o treino à cobertura da fronteira.
Conclusão: o pipeline define a sequência e a HVC fornece um sinal de recompensa pela contribuição para a cobertura.
Resultados no RTLLM v2
A avaliação no benchmark RTLLM v2 mostrou um aumento do Hypervolume relativo. Em relação à variante de referência sem otimização PPA, o aumento foi de +13,3 p.p. Em relação ao método de RL de objetivo único, foi de +14,4 p.p. Os autores também relatam maior diversidade de circuitos.
| Comparação | Aumento do Hypervolume relativo |
|---|---|
| Variante de referência sem otimização PPA | +13,3 p.p. |
| Método de RL de objetivo único | +14,4 p.p. |
Conclusão: no RTLLM v2, o método melhora a cobertura da fronteira e a diversidade. Os valores dizem respeito ao Hypervolume relativo, não à qualidade absoluta de cada circuito.
Critério prático de escolha
A abordagem é escolhida com base no momento em que o compromisso é definido. A recompensa escalar exige que a importância dos objetivos PPA seja definida antes da geração. A abordagem multiobjetivo transfere a escolha para a etapa posterior à geração. Esta fornece um conjunto de candidatos com diferentes compromissos.
A avaliação do método limita-se ao benchmark RTLLM v2. É necessária uma validação própria para outro fluxo de projeto. Não se devem extrapolar os valores de melhoria para outras condições sem validação.
Conclusão: se os requisitos de PPA variarem de produto para produto, a abordagem multiobjetivo é adequada à tarefa de escolha após a geração. Se a importância dos objetivos for conhecida e fixa, a recompensa escalar é adequada ao caso em que o compromisso é definido antecipadamente.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026
Modelo de mundo para agentes em LLMs proprietários: correção nos pontos de risco
É proposto o PAWM — um preditor externo que não duplica a observação passo a passo, mas é acionado quando há probabilidade de falha e afasta o agente de uma ação errada. Após SFT em cenários sintéticos e co-treinamento GRPO, o método apresentou um aumento de 24,3% no ScienceWorld e de 7,7% no WebArena-Lite para o Claude Sonnet 4.5.
4 novembro 2026