
Fragmentação de tokens em transformadores multimodais: quando a atenção preserva a contribuição da representação
O estudo determina em que condições a divisão da representação de entrada num maior número de elementos não altera a sua contribuição, desde que se preservem o conteúdo, a posição, o contexto visível e a massa total. Para kernels de atenção positivos com um multiplicador local da massa não decrescente, a invariância só é alcançada quando este é linear; no Qwen2.5-Omni-7B e em benchmarks de vídeo, a ponderação pela massa reduz o desvio e aumenta a precisão durante a compressão.
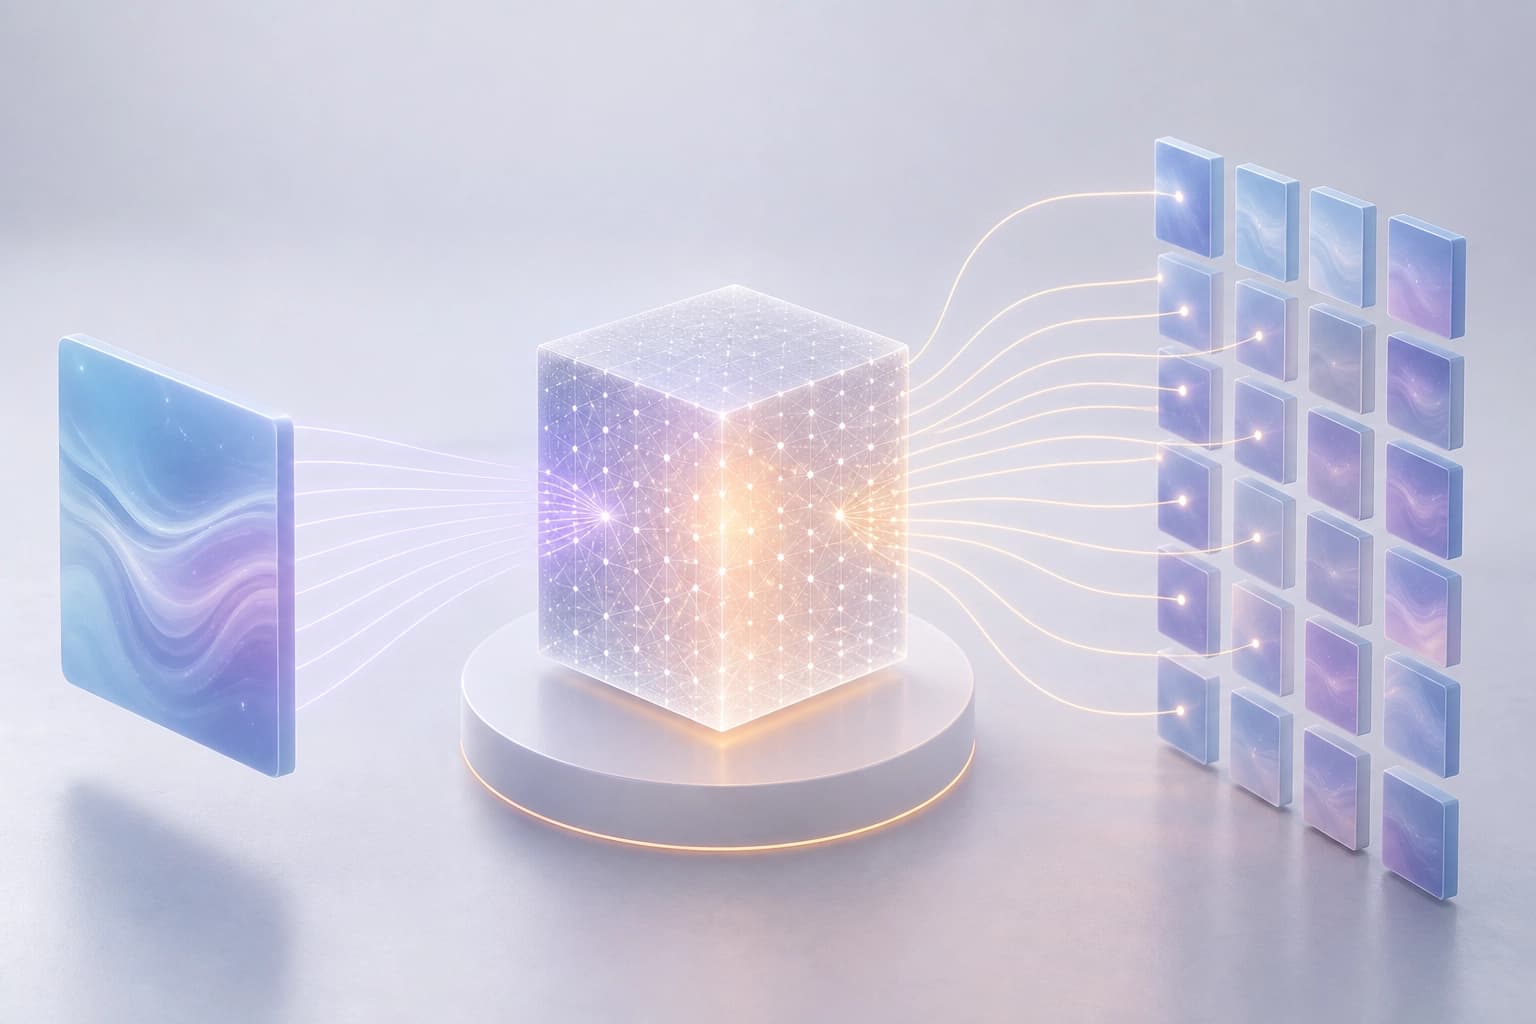
Simetria de refinamento: o que verifica o princípio
O número de pesos de atenção depende do número de tokens. A mudança da representação do sinal altera esse número. Por isso, a divisão da entrada afeta a mecânica da atenção.
O artigo «Refinement Symmetry in Multimodal Transformers» (Yuhao Du, Shunian Chen) foi submetido a 26 de setembro de 2026. Introduz a simetria de refinamento como condição para preservar o contributo.
A divisão da representação preserva o contributo se forem mantidas quatro propriedades:
- conteúdo;
- posição;
- contexto visível;
- massa total.
Critério prático: antes de alterar a segmentação dos tokens, verifique estas quatro propriedades. A perda de qualquer uma delas elimina a garantia de preservação do contributo.
Linearidade do multiplicador local de massa
Os autores baseiam-se na atenção proporcional e na atenção por quadratura. A conclusão é que a invariância à divisão exige um multiplicador local de massa linear. A condição aplica-se a qualquer núcleo de atenção positivo fixo. Além disso, o multiplicador não diminui.
Deste requisito decorrem três verificações:
- um multiplicador não linear altera o contributo quando há divisão;
- a linearidade preserva o contributo;
- a monotonicidade restringe o conjunto de esquemas admissíveis.
Critério prático: verifique a linearidade do esquema de ponderação antes de dividir. A não linearidade prevê uma alteração do resultado.
Conjugação física e limites do erro de atenção
A conjugação física aplica-se a representações alteradas. Limita o erro de atenção. Este limite distingue duas fontes:
- alteração das características;
- redistribuição dos pesos.
Critério prático: analise as duas fontes separadamente. Assim, é possível perceber o que corrigir — as características ou os pesos.
Teste no Qwen2.5-Omni-7B: respostas do MVBench
No Qwen2.5-Omni-7B, triplicar metade dos tokens visuais altera 255 respostas em 3 586 no MVBench. Este é o resultado da atenção padrão. A ponderação por medida preserva todas as respostas. A visibilidade permanece comparável.
| Esquema | Respostas alteradas | Visibilidade |
|---|---|---|
| Atenção padrão | 255 em 3 586 | — |
| Ponderação por medida | nenhuma | comparável |
Conclusão: a discrepância não é causada pela divisão em si, mas pela forma como a massa é contabilizada.
Critério prático: ao dividir os tokens visuais, passe a usar ponderação por medida. Esta mantém as respostas com o mesmo contexto visível.
Reamostragem de fotogramas e deriva da distribuição
Na reamostragem natural de fotogramas, a ponderação por medida reduz a deriva da distribuição. O efeito vai além da preservação de respostas individuais.
Critério prático: ao alterar a frequência de fotogramas, acompanhe a deriva da distribuição, e não apenas a precisão. A ponderação por medida reduz essa deriva.
Compressão de vídeo: ganhos medidos
A avaliação foi realizada com a junção dupla de codificações de vídeo congeladas. Foram usados cinco valores iniciais aleatórios. O aumento da precisão foi positivo para todas as partições.
| Esquema de base | Aumento da precisão |
|---|---|
| Ponderação global pelo número de tokens (massa média do grupo) | 1,04 pontos percentuais |
| Atenção padrão | 0,93 pontos percentuais |
A vantagem em relação à ponderação global pelo número de tokens também se verifica no WorldSense. Depende do orçamento de compressão.
Critério prático: em caso de compressão de vídeo intensa, tenha em conta o orçamento. O ganho da ponderação por medida não é constante.
O que o princípio de representação oferece
Os autores apresentam o resultado como um princípio de representação com um ganho medido de robustez às partições. Não se trata de ajustes pontuais, mas de uma regra para lidar com a divisão.
Critério prático: primeiro, fixe a representação e a sua massa; depois, ajuste os pesos. Assim, a divisão deixa de alterar as respostas.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026
Modelo de mundo para agentes em LLMs proprietários: correção nos pontos de risco
É proposto o PAWM — um preditor externo que não duplica a observação passo a passo, mas é acionado quando há probabilidade de falha e afasta o agente de uma ação errada. Após SFT em cenários sintéticos e co-treinamento GRPO, o método apresentou um aumento de 24,3% no ScienceWorld e de 7,7% no WebArena-Lite para o Claude Sonnet 4.5.
4 novembro 2026
Camada de classificação sobre o SpeechLLM: onde supera a geração de rótulos no reconhecimento de emoções
Com base nos conjuntos de dados IEMOCAP e MELD, comparam-se a geração de rótulos emocionais e um classificador linear aplicado às representações ocultas de uma SpeechLLM compacta. O ganho de desempenho do classificador não é universal: depende do corpus e de serem usadas transcrições de referência ou resultados de ASR.
4 novembro 2026