
Modelo de mundo para agentes em LLMs proprietários: correção nos pontos de risco
É proposto o PAWM — um preditor externo que não duplica a observação passo a passo, mas é acionado quando há probabilidade de falha e afasta o agente de uma ação errada. Após SFT em cenários sintéticos e co-treinamento GRPO, o método apresentou um aumento de 24,3% no ScienceWorld e de 7,7% no WebArena-Lite para o Claude Sonnet 4.5.
Problema: falta ao agente conhecimento sobre o ambiente
Os agentes avançados baseados em LLM do tipo «caixa negra» lidam bem com raciocínios de longo prazo e com a geração precisa de ações. Não possuem, porém, conhecimento adquirido sobre a evolução do ambiente para uma tarefa específica do agente. O artigo arXiv:2610.29139, submetido em 21 de outubro de 2026, descreve esta lacuna.
Um modelo do mundo fornece ao agente conhecimento sobre um ambiente específico. Prevê a reação do ambiente a uma ação que o agente se prepara para executar. Este modelo acrescenta informação sobre a tarefa.
Critério prático: verificar a ligação entre o modelo do mundo e o ambiente-alvo. O conhecimento geral sobre raciocínio não colmata a lacuna na compreensão de uma tarefa específica.
Modo de correção: não em cada passo, mas nos pontos de risco
Os modelos do mundo anteriores para agentes LLM preveem sobretudo a observação seguinte em cada passo. Este modo é dispendioso e pouco informativo. As observações individuais fornecem orientações limitadas e relacionadas com a tarefa. Não é necessário antecipar em cada passo.
Um estudo-piloto mostrou que as orientações do modelo do mundo são mais úteis quando este antecipa armadilhas num futuro limitado de vários passos. Assim, a correção deve ser ativada nos pontos de risco, em vez de funcionar continuamente.
| Opção | O que se sabe |
|---|---|
| Previsão passo a passo | Prevê a observação seguinte em cada passo; é dispendiosa e pouco informativa. |
| Antecipação de armadilhas | Antecipa armadilhas num futuro limitado de vários passos; fornece as orientações mais úteis. |
Critério prático: escolher um modo que seja ativado perante uma potencial armadilha e não gaste a capacidade de antecipação em cada passo.
Como funciona a antecipação de armadilhas
Os autores apresentaram o Pitfall Anticipation World Model (PAWM). O modelo funciona através de três elementos:
- intervém seletivamente quando surge uma potencial armadilha;
- prevê uma falha iminente;
- afasta o agente da armadilha no ponto de risco.
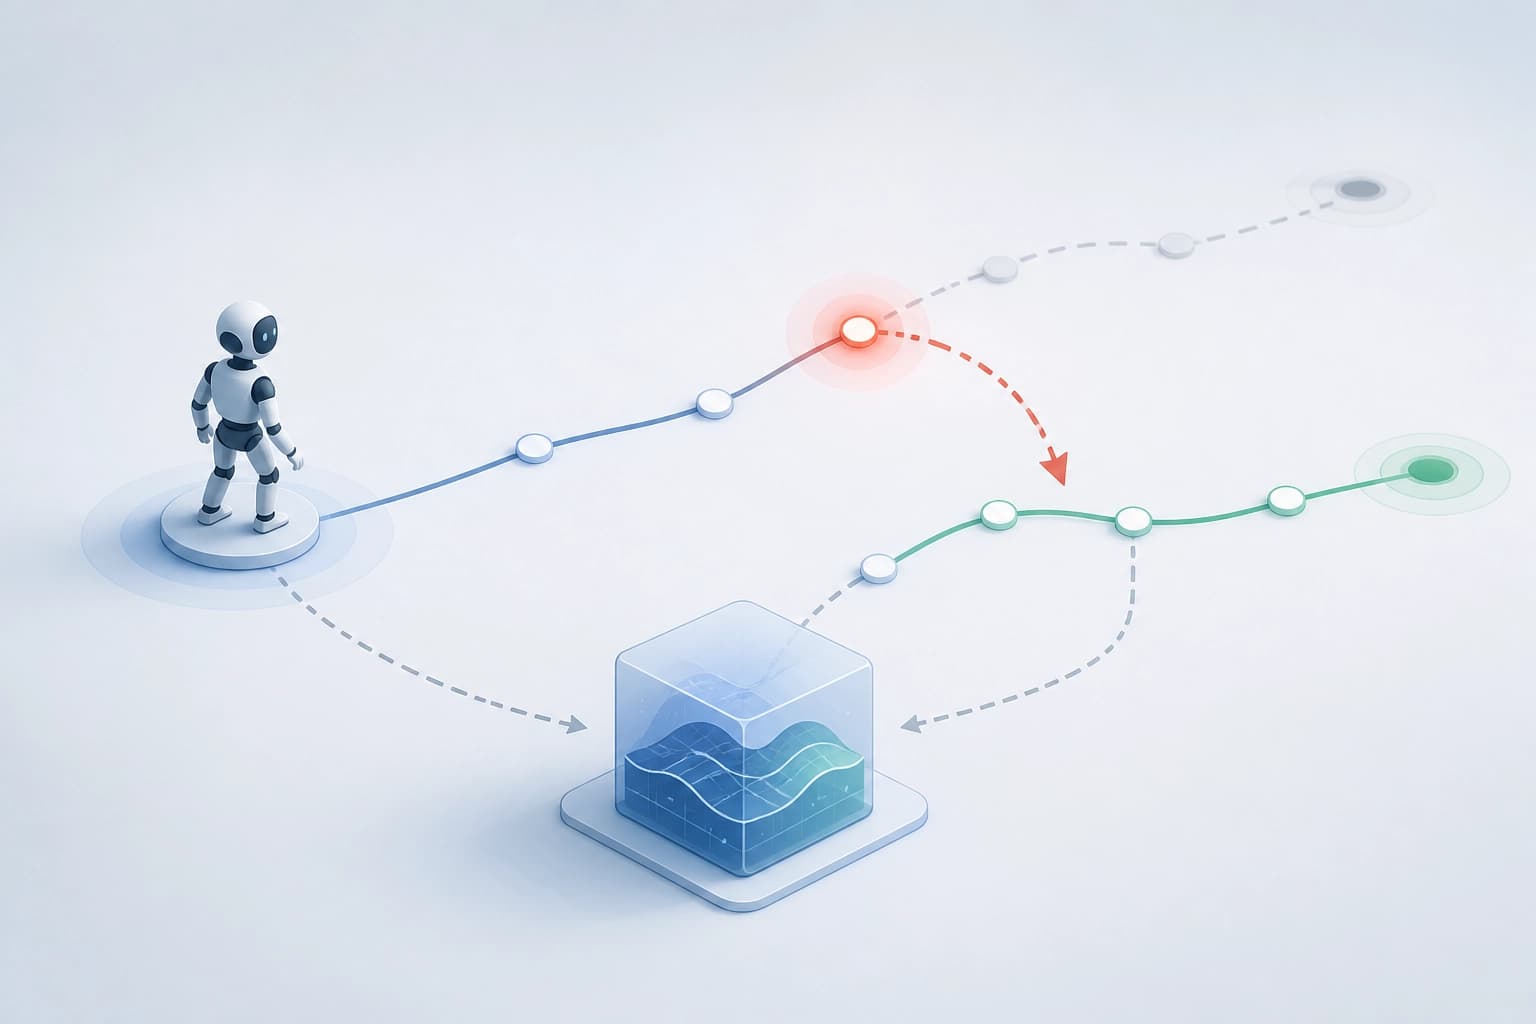
Critério prático: o acionador da correção deve basear-se numa potencial armadilha e numa previsão de falha iminente.
Treino do modelo em duas etapas
Os autores treinam o Pitfall Anticipation World Model (PAWM) em duas etapas.
- Supervised Fine-Tuning (SFT) com dados sintéticos. Os dados sintéticos incluem anotações de armadilhas para os agentes.
- Co-training com GRPO e um LLM do tipo «caixa negra». Otimiza o modelo no ambiente-alvo.
Critério prático: verificar as duas etapas — a anotação de armadilhas e o co-training no ambiente-alvo.
Avaliação: onde observar os ganhos
O método melhora os resultados do Claude Sonnet 4.5 em 24,3% no ScienceWorld e em 7,7% no WebArena-Lite.
| Ambiente | Ganho para Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24,3% |
| WebArena-Lite | 7,7% |
Os autores também indicam que o modelo supera vários métodos de referência. Critério prático: observar os ganhos no ambiente-alvo e compará-los com os métodos de referência. A transferência dos resultados entre ambientes exige uma verificação específica.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026
Camada de classificação sobre o SpeechLLM: onde supera a geração de rótulos no reconhecimento de emoções
Com base nos conjuntos de dados IEMOCAP e MELD, comparam-se a geração de rótulos emocionais e um classificador linear aplicado às representações ocultas de uma SpeechLLM compacta. O ganho de desempenho do classificador não é universal: depende do corpus e de serem usadas transcrições de referência ou resultados de ASR.
4 novembro 2026
Das pontuações individuais aos conjuntos admissíveis: decodificação global sob restrições DDI
O artigo compara a seleção global exata de um conjunto compatível de medicamentos, implementada através de programação linear inteira mista, com vários esquemas locais de resolução de conflitos de DDI, usando pontuações FLAME fixas no MIMIC-III. Na amostra de teste, a abordagem global apresenta uma vantagem pequena, mas consistente, em termos de Jaccard, que aumenta quando as restrições são mais rigorosas e atinge +0.0064 em relação ao método de base local mais forte.
4 novembro 2026