Problema: código que roda, mas faz outra coisa
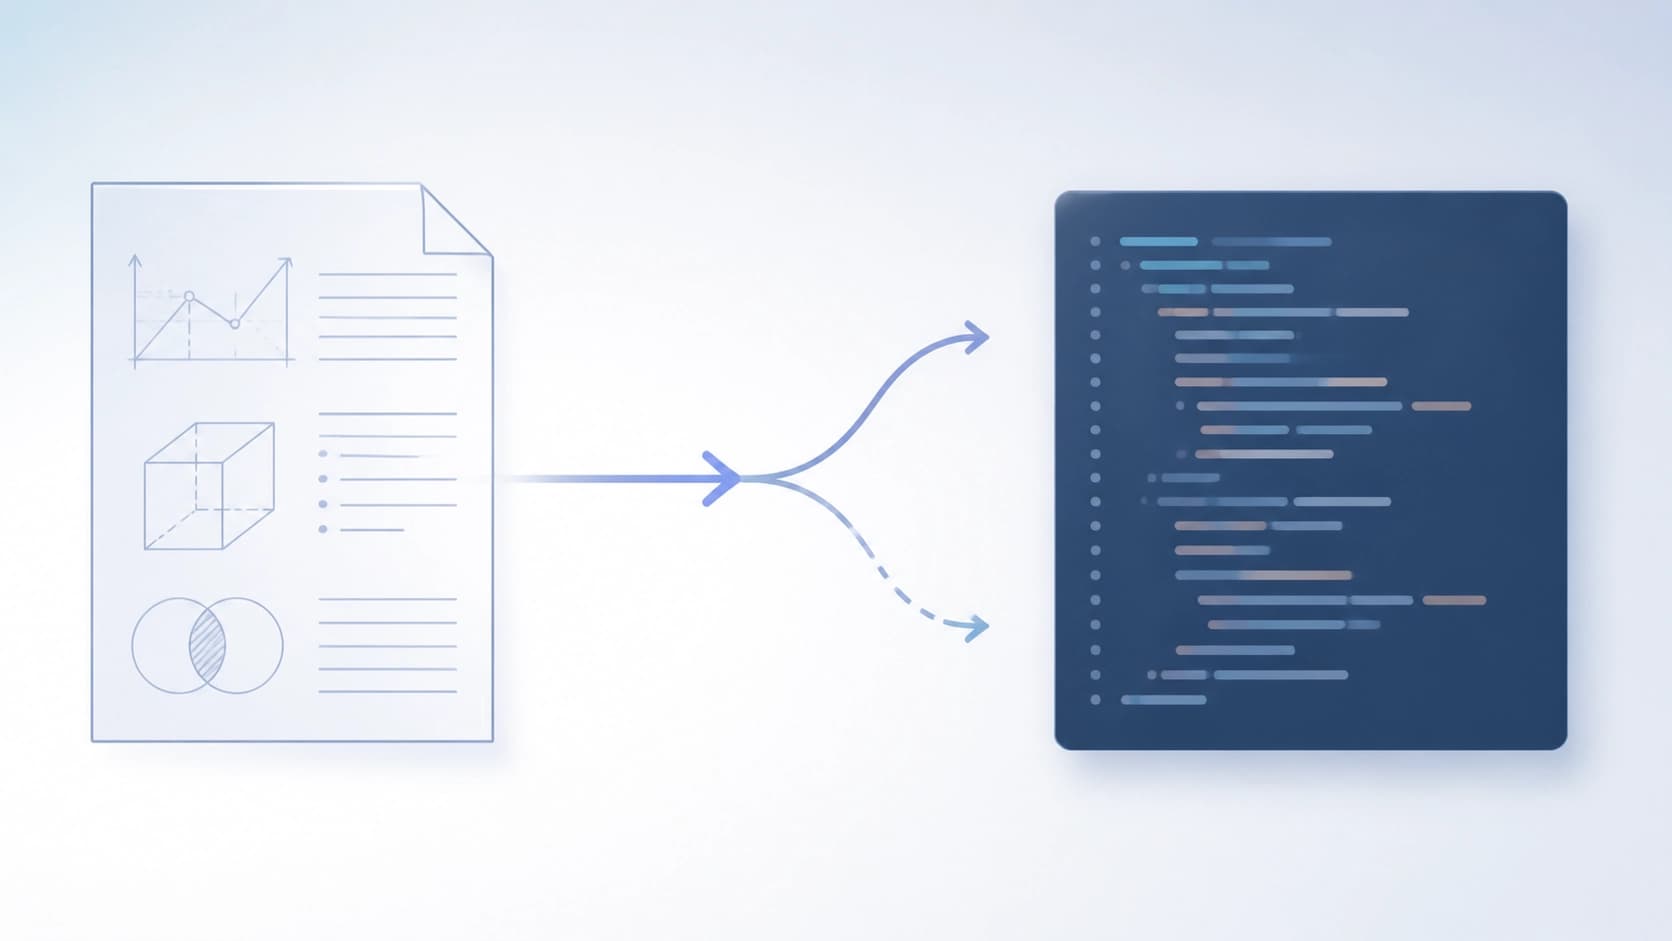
Agentes baseados em grandes modelos de linguagem já conseguem pegar um artigo científico e produzir um repositório funcional a partir dele. O problema é que "funcional" e "reprodutível" não são sinônimos. O script pode passar com sucesso em todos os testes, treinar o modelo e imprimir uma métrica bonita, mas internamente a ordem das etapas pode ter sido sutilmente trocada, um fator multiplicativo pode ter se perdido na função de perda ou um stub pode ter sido colocado no lugar de uma etapa não trivial.
É justamente esse modo de falha que os autores do novo trabalho chamam de deriva semântica (semantic drift): o código gerado se afasta silenciosamente do que está descrito na especificação do artigo. O erro não salta aos olhos — ele vive nos detalhes que ninguém verifica automaticamente. O resultado é uma reprodução que, formalmente, aconteceu, mas que cientificamente não confirma nada.
O que é o SA-Bench
Para medir a deriva, é preciso primeiro torná-la observável. É disso que se ocupa o SemanticAlign-Bench, abreviado como SA-Bench — um benchmark diagnóstico descrito no artigo arXiv:2608.24252 (aceito no Findings of EMNLP 2026, autores: Xue Hu, Zewei Pan, Zeli Su, Zhou Liu e Wentao Zhang).
O material abrange 30 trabalhos das conferências ICLR, ICML e NeurIPS de 2025 e está distribuído em cinco áreas de aprendizado de máquina. O que se avalia não são as "impressões" sobre o código, mas um conjunto de afirmações verificáveis. No total, o benchmark reúne 1.491 dessas afirmações.
Semantic Alignment Units: os átomos da especificação
A ideia metodológica central é decompor a descrição do artigo nos menores elementos que podem ser verificados manualmente no repositório. Esses elementos são chamados de Semantic Alignment Units (SAU). Cada unidade é uma afirmação separada sobre a implementação: um hiperparâmetro específico, uma fórmula, uma ordem de operações, uma condição de parada, um esquema de divisão dos dados.
Essa abordagem granular é importante porque elimina a binariedade "deu certo / não deu certo" da avaliação. Em vez de uma única marcação por artigo, surgem centenas de pequenas perguntas, e fica visível onde exatamente a implementação falhou.
Quatro dimensões da deriva
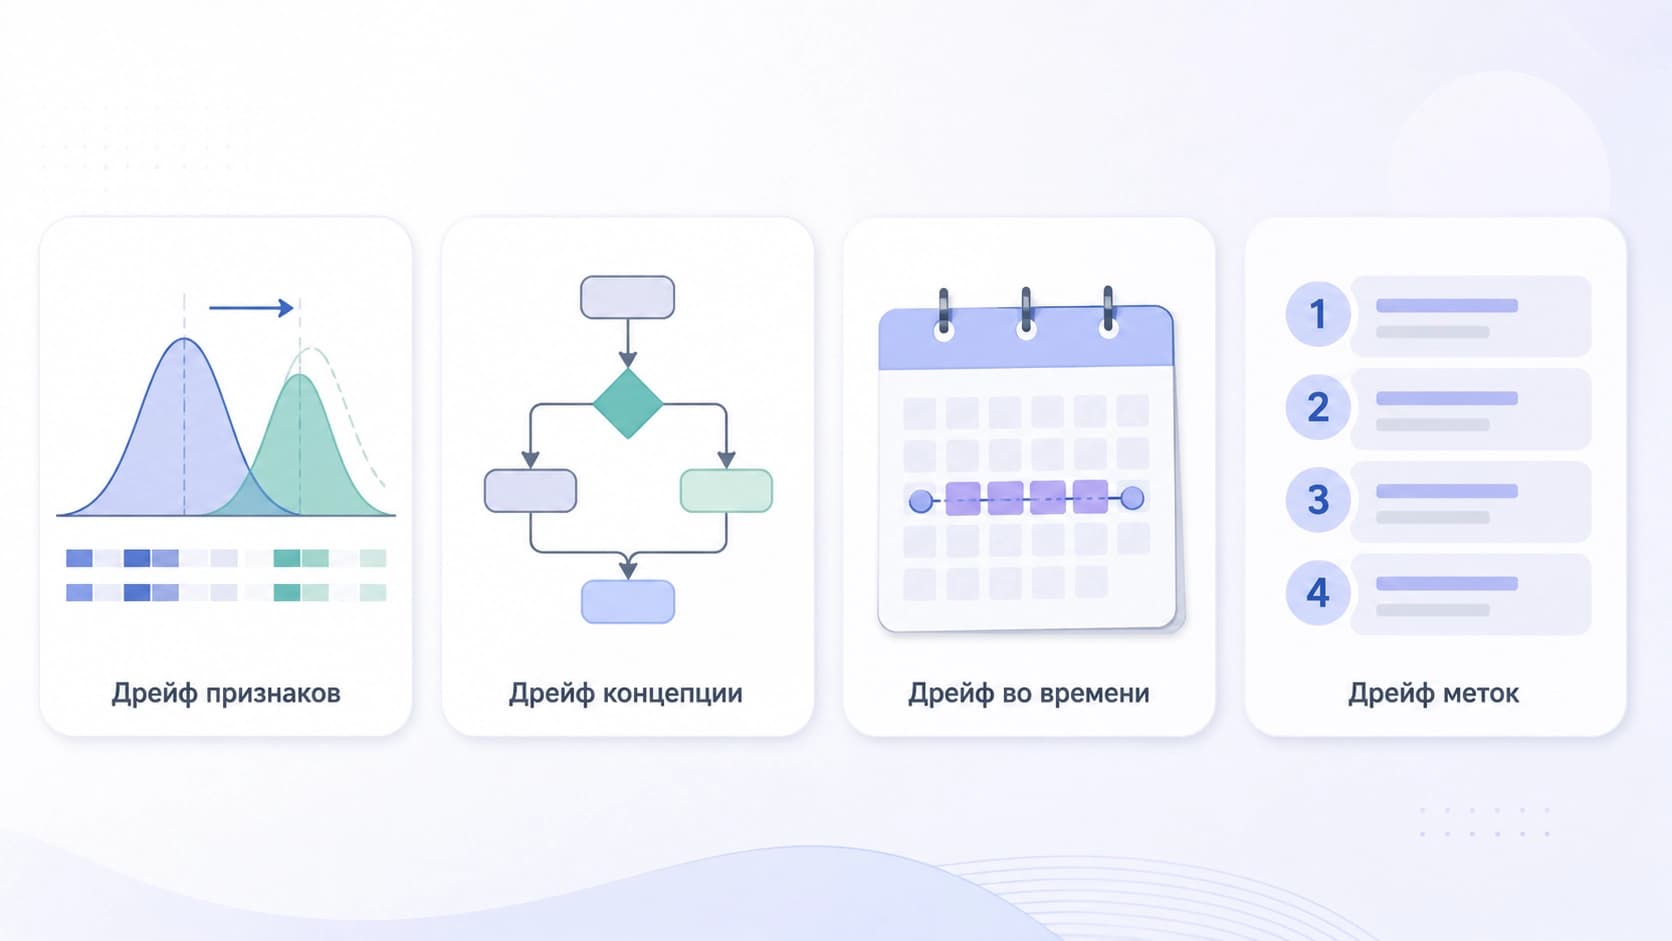
Cada repositório é avaliado segundo quatro eixos diagnósticos:
- deriva numérica — valores de coeficientes, dimensionalidades, limiares e outras grandezas não coincidem com a especificação;
- deriva metodológica — o próprio procedimento de treinamento ou cálculo está estruturado de forma diferente do que foi concebido no trabalho;
- deriva de protocolo — o esquema do experimento está violado: divisão da amostra, condições de comparação, regulamento de avaliação;
- deriva de ordem — as etapas são executadas em sequência incorreta, e isso altera o resultado.
A separação dos eixos traz um benefício prático: o desenvolvedor vê não um abstrato "a qualidade está baixa", mas um tipo concreto de falha.
Resultados: 0,301 como teto
Os autores testaram 12 configurações de geradores — quatro modelos combinados com três scaffolds. Cada avaliação foi medida em frações de uma unidade.
Os números foram sóbrios. O melhor resultado foi da combinação Claude e PaperCoder — em média 0,301 de pontuação SAU de 1,0 possível. A pontuação média geral em todas as 360 avaliações foi de 0,221.
Em outras palavras, mesmo a configuração mais forte executa corretamente menos de um terço do que a especificação exige. Ao mesmo tempo, os modelos não ignoram os requisitos: a taxonomia de falhas mostra que os agentes geralmente tentam cobrir a maioria dos pontos, mas os implementam incorretamente. A maior parte das afirmações zeradas vem de dois cenários — incompatibilidade entre implementação e concepção (implementation mismatch) e stubs, ou seja, lugares onde, em vez da lógica real, foi deixada uma formalidade vazia.
Esse perfil de erros revela algo importante: não se trata de preguiça do agente nem de ele "não ter lido até o fim" o artigo. Trata-se de ele reproduzir com confiança uma versão plausível, porém incorreta.
Executabilidade não é o mesmo que fidelidade científica
Uma conclusão separada do trabalho diz respeito a como os scaffolds modernos são estruturados. Aqueles otimizados para executabilidade — para que o código simplesmente rode e não quebre — oferecem um ganho limitado para a reprodução científica. Isso faz sentido: uma execução bem-sucedida verifica a sintaxe e a presença de dependências, mas não diz nada sobre se a lógica coincide com a concepção dos autores.
Para reduzir a lacuna, são necessários scaffolds de outra classe — aqueles que colocam em primeiro lugar a verificação das especificações semânticas. Em termos simples, o agente precisa não apenas escrever e executar o código, mas conferir cada um de seus passos com a afirmação do artigo e ser capaz de provar que há correspondência.
O que isso muda na prática
O SA-Bench não é uma competição de modelos, mas uma ferramenta diagnóstica. Seu valor está em deslocar a discussão sobre reprodutibilidade do plano "funciona / não funciona" para o plano "quão precisamente corresponde". O benchmark, as anotações e o pipeline de avaliação estão disponíveis em acesso aberto, de modo que a metodologia pode ser aplicada também a tarefas próprias — por exemplo, para verificar pipelines internos de geração de código a partir de especificações técnicas, e não apenas de artigos científicos.
Para quem constrói agentes, a conclusão soa assim: aumentar a "inteligência" do gerador sem uma camada separada de verificação esbarra em um teto. A deriva semântica não é um bug de um modelo específico, mas uma propriedade da abordagem em que ninguém verifica a correspondência semântica. E enquanto essa camada não existir, a reprodução de código de pesquisa continuará sendo uma tarefa em que o humano ainda precisa ler cada linha.