Produto escalar como gargalo
Quase todas as arquiteturas de atenção modernas funcionam da mesma forma: a consulta (query) e a chave (key) são combinadas por meio de um produto escalar (ou de sua versão normalizada), o resultado é convertido em pesos, e a saída é montada como uma soma ponderada dos valores. A técnica é universal, mas tem um custo — a geometria do espaço de características nesse esquema é definida de forma rígida: a similaridade é medida "em linha reta", sem levar em conta que direções diferentes no espaço podem ter importância e escala diferentes.
É justamente para essa limitação que aponta o trabalho arXiv:2608.24462 "Mahalanobis-Based Multi-Head Attention for Complex State Propagation" (autor — Xiaohe Li; seção cs.AI). Em vez do produto habitual, ele utiliza um kernel RBF construído sobre a distância de Mahalanobis. Em termos simples, a similaridade entre elementos de uma sequência não é calculada "de forma direta", mas com correção para a estrutura de covariância dos dados — como se o espaço, antes da comparação, fosse levemente esticado e rotacionado para que direções correlacionadas não fossem consideradas independentes.
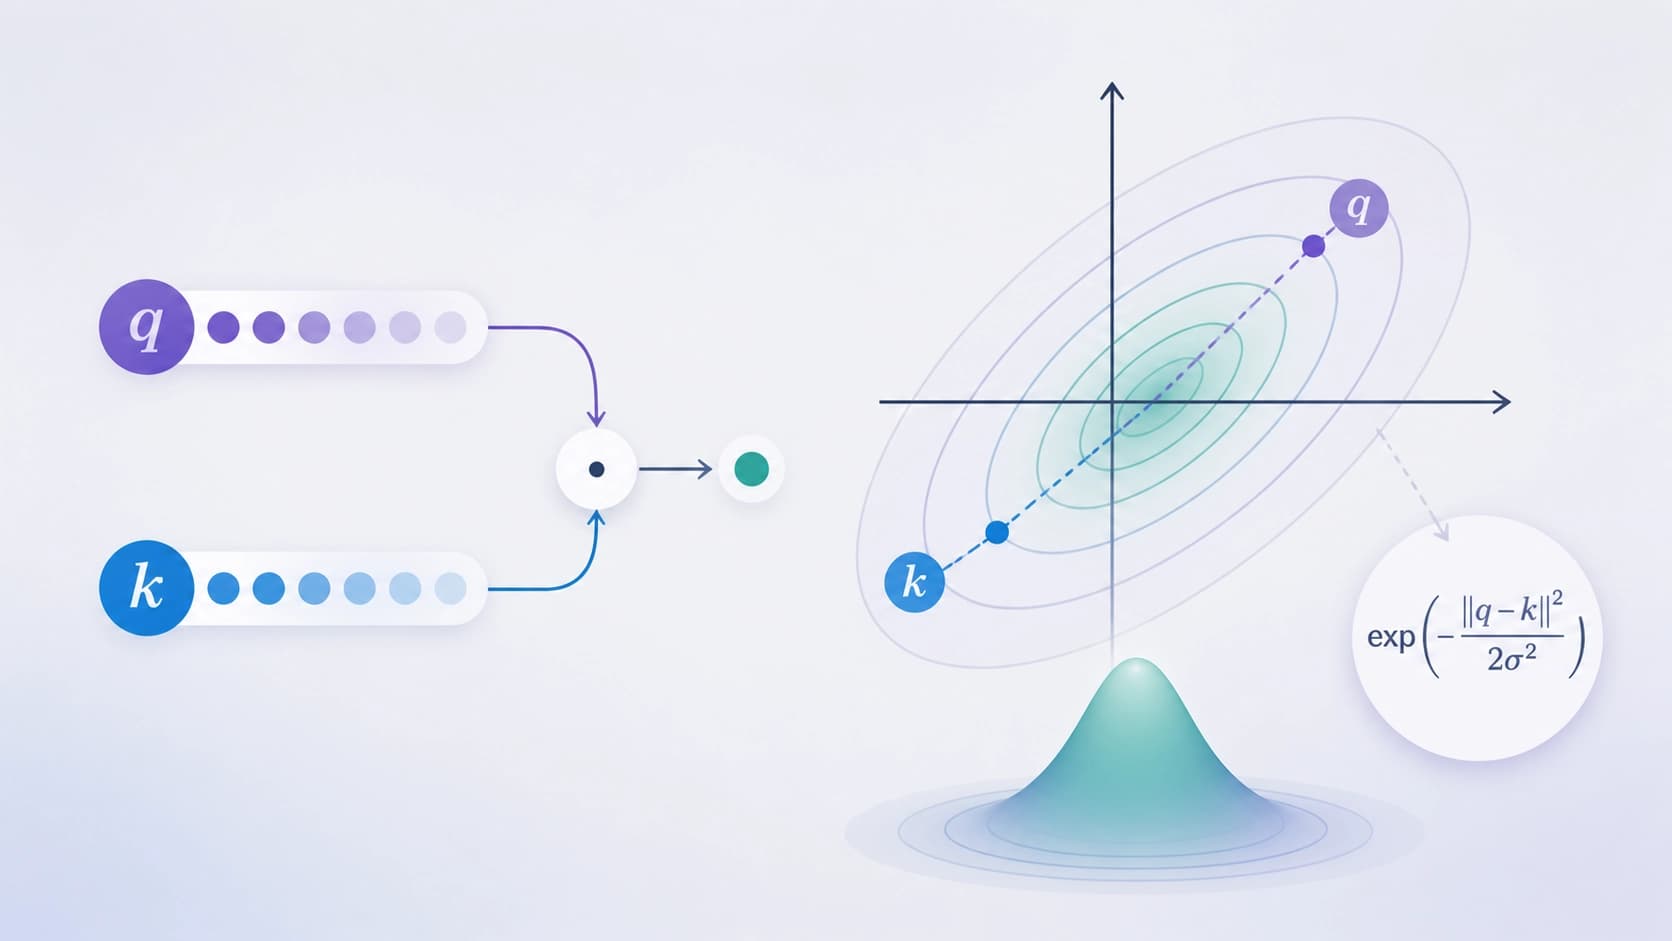
O que a distância de Mahalanobis proporciona
Atenção em espaço de dimensão infinita sem crescimento de parâmetros
A afirmação central do autor: o kernel RBF sobre a distância de Mahalanobis permite calcular a atenção como se ela vivesse em um espaço de características de dimensão infinita, mas sem que o número de parâmetros treináveis cresça. Isso não é mágica, mas consequência do fato de que o próprio kernel já define um mapeamento não linear — não é necessária uma camada separada para expandir as características. Na prática, isso significa exigências mais modestas de memória e otimização, o que, na era dos modelos gigantescos, soa quase provocativo.
Definitude positiva e Tree Attention
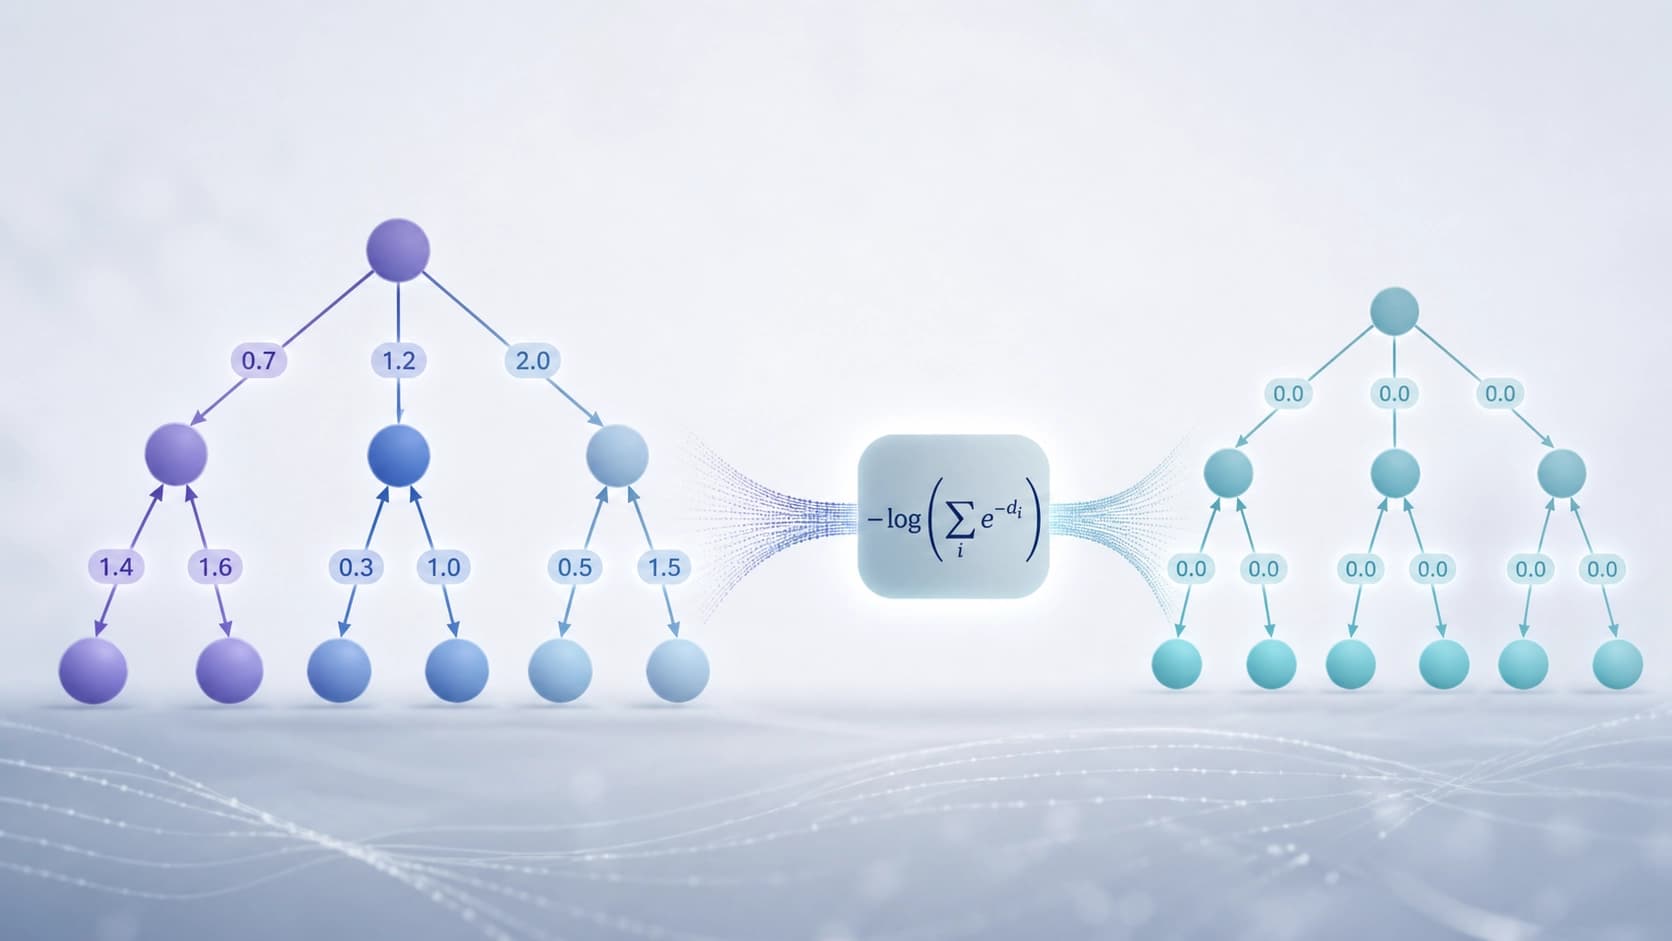
A segunda camada da ideia apoia-se em uma propriedade matemática da distância de Mahalanobis: ela é positiva definida. A partir disso, é possível construir diretamente o que o artigo chama de Tree Attention — as pontuações de atenção são construídas não a partir de similaridades "brutas", mas de distâncias acumuladas ao longo de uma árvore. Para que tais acumulações não se desviem numericamente, aplica-se uma correção via LogSumExp: subtrai-se da distância o logaritmo da soma das exponenciais ao longo das arestas. Em essência, é uma forma de conciliar as contribuições de diferentes caminhos na árvore sem perder seu peso relativo.
Para o leitor não familiarizado com os detalhes, uma analogia útil é esta: em vez de somar "similaridades" de qualquer maneira, o modelo as normaliza cuidadosamente à medida que avança pela estrutura. Isso está mais próximo de contabilidade do que de intuição — mas é justamente essa precisão que permite ao raciocínio permanecer estável em cadeias longas de dependências.
Attention meshing: as cabeças começam a conversar entre si
Normalmente, a atenção multi-cabeça é organizada como um conjunto de especialistas quase independentes: cada cabeça calcula o seu, e a mistura ocorre apenas na saída, por uma projeção linear. No MHA-CSP, as matrizes de distância de Mahalanobis são reutilizadas — com base nelas, constrói-se o mecanismo de "attention meshing", que faz os kernels de diferentes cabeças interagirem diretamente. O autor alega duplo benefício: tanto maior precisão quanto treinamento mais eficiente, já que o mesmo trabalho computacional não é duplicado.
Experimentos: 119K parâmetros contra grandes modelos de base
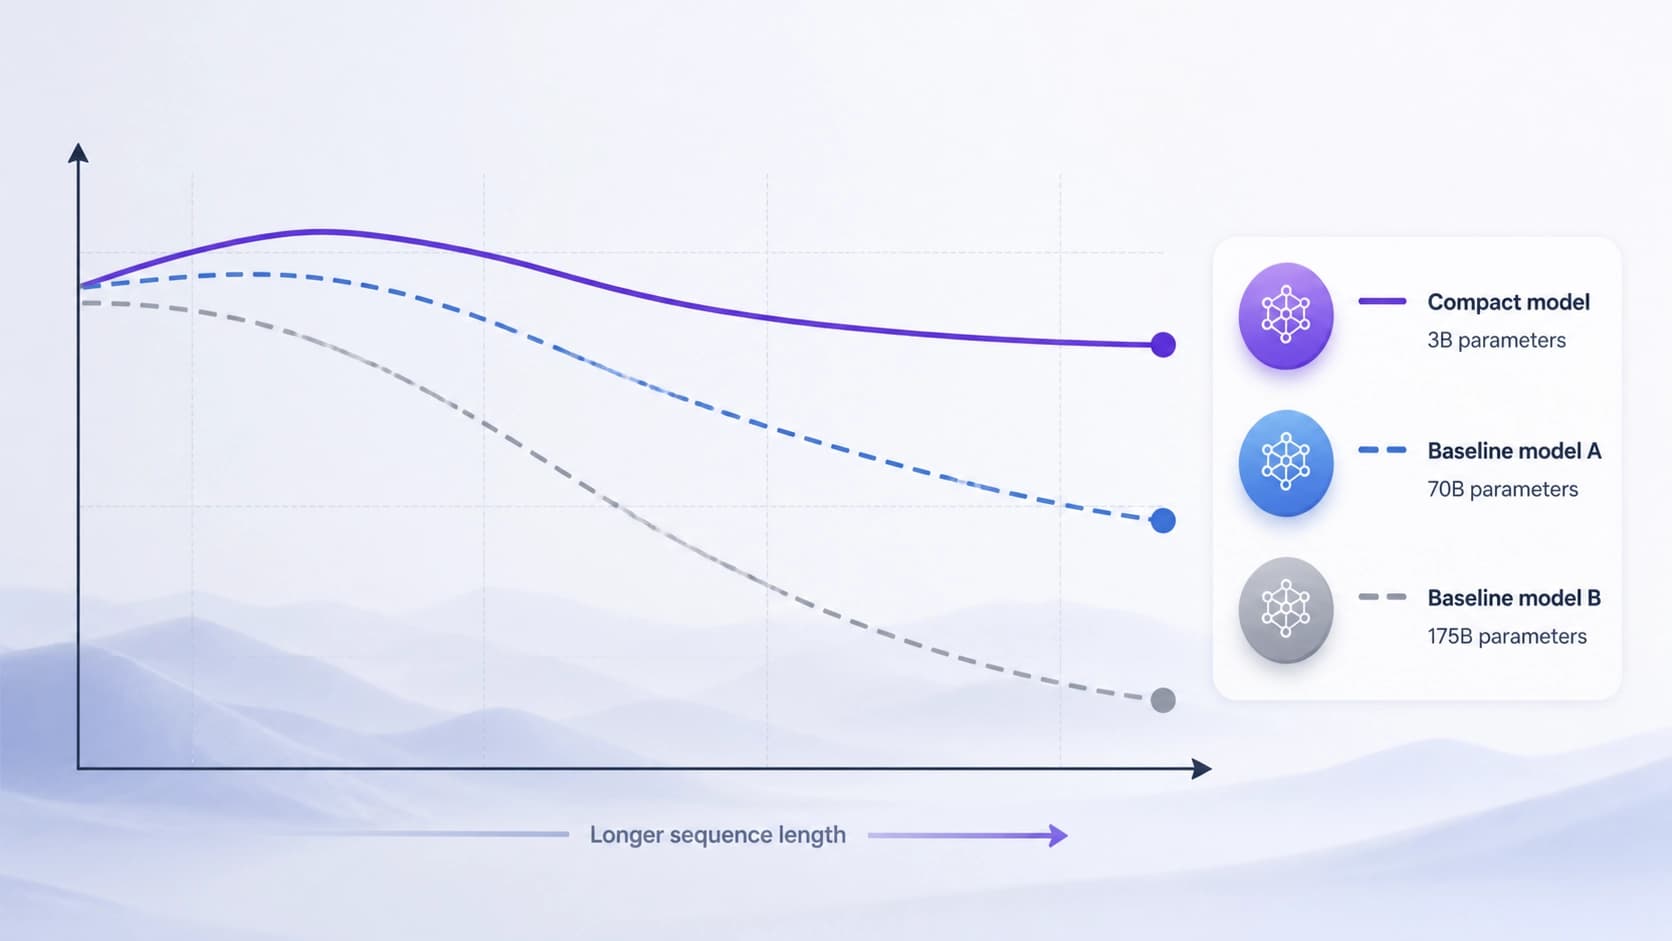
A parte mais chamativa do trabalho é a comparação. O MHA-CSP, com apenas 119 mil parâmetros, é comparado com transformadores de base e redes convolucionais em grafos treinados do zero em condições idênticas. A tarefa é o rastreamento de estados em sequências longas. Além disso, o teacher forcing foi aplicado exclusivamente no estado oculto final, ou seja, o modelo não recebeu dicas a cada passo, como frequentemente se faz em treinamentos mais didáticos.
Segundo o autor, o MHA-CSP supera consistentemente os concorrentes. Os modelos de base, por sua vez, apoiam-se ou na atenção densa (transformador), ou na propagação de informação pelo grafo (GCN), enquanto o MHA-CSP alcança raciocínio estruturado por meio da correção sintética de distâncias e de uma travessia econômica da informação, herdada do backbone CSP.
Vale enfatizar: não se trata de uma pequena modelo "alcançar" os grandes em tudo. Trata-se de uma classe específica de tarefas — sequências longas com estrutura simbólica interna, nas quais importa não apenas memorizar o contexto, mas manter seu estado. É justamente aí que a geometria das distâncias e a normalização em árvore começam a funcionar.
O que isso muda na prática
A principal conclusão do trabalho é formulada assim: a propagação de estados com valores complexos (complex-valued state propagation), em combinação com a correção multi-cabeça conjunta, revela-se uma ferramenta funcional para capturar estruturas simbólicas. E estabelece um novo compromisso entre eficiência e qualidade para tarefas de raciocínio estruturado.
Visto de forma mais ampla, percebe-se aqui uma tendência dos últimos anos: em vez de aumentar parâmetros, os pesquisadores buscam vieses indutivos mais adequados — ou seja, incorporam à arquitetura suposições corretas sobre a natureza dos dados. O produto escalar era uma suposição conveniente, mas bastante grosseira. Substituí-lo por um kernel com métrica de covariância é uma tentativa de dizer ao modelo: "nem todas as direções no espaço são iguais, leve isso em conta desde o início".
Um olhar cauteloso de fora
Há razões para não sair reescrevendo pipelines. Em primeiro lugar, os resultados foram obtidos em um conjunto específico de tarefas de rastreamento de estados; transferi-los para geração de texto, multimodalidade ou cenários de diálogo sem verificação separada não é aconselhável — no resumo, tais experimentos não existem. Em segundo lugar, o autor único e a primeira versão do preprint (v1, submetida em 25 de agosto de 2026) significam que ainda não vimos replicação independente: o arquivo de 377 KB está disponível em PDF, HTML e fontes TeX, mas a reprodução é outra história.
E ainda assim a direção parece produtiva. O abandono do produto escalar, o trabalho direto com a geometria das distâncias, a reutilização de cálculos entre cabeças — são exatamente os movimentos que reduzem o custo do modelo sem sacrificar a expressividade. Se os resultados se confirmarem em outros domínios, as redes "pequenas, mas bem construídas" ganharão mais um argumento de peso.