Por que precisamos de um grafo causal — e por que ele frequentemente não existe
As perguntas contrafactuais soam simples: "o que teria acontecido se o paciente tivesse recebido outro tratamento", "como a demanda teria mudado se tivéssemos aumentado o preço". A dificuldade está em que a resposta a elas não pode ser derivada apenas das correlações observadas. É preciso um modelo de como as variáveis influenciam umas às outras — ou seja, uma estrutura causal.
A receita clássica na literatura de identificação não paramétrica é a seguinte: pegue um grafo causal completamente especificado, adicione suposições sobre a forma dos mecanismos — e calcule a quantidade de interesse ou seu intervalo admissível. Isso funciona de forma confiável, mas depende de um luxo que o analista quase nunca tem. O domínio é estudado apenas parcialmente, parte das relações é controversa, parte das variáveis sequer é medida. O grafo completo, nessa situação, não é um ponto de partida, mas um ideal inatingível.
É exatamente essa lacuna entre teoria e prática que Eric Rossetto e Alessandro Antonucci tentam fechar no artigo Partial Identification under Causal Orders by Linear Programming (arXiv:2608.24427). Sua abordagem não é "completar o grafo de algum jeito", mas abandonar por completo a exigência de tê-lo como entrada.
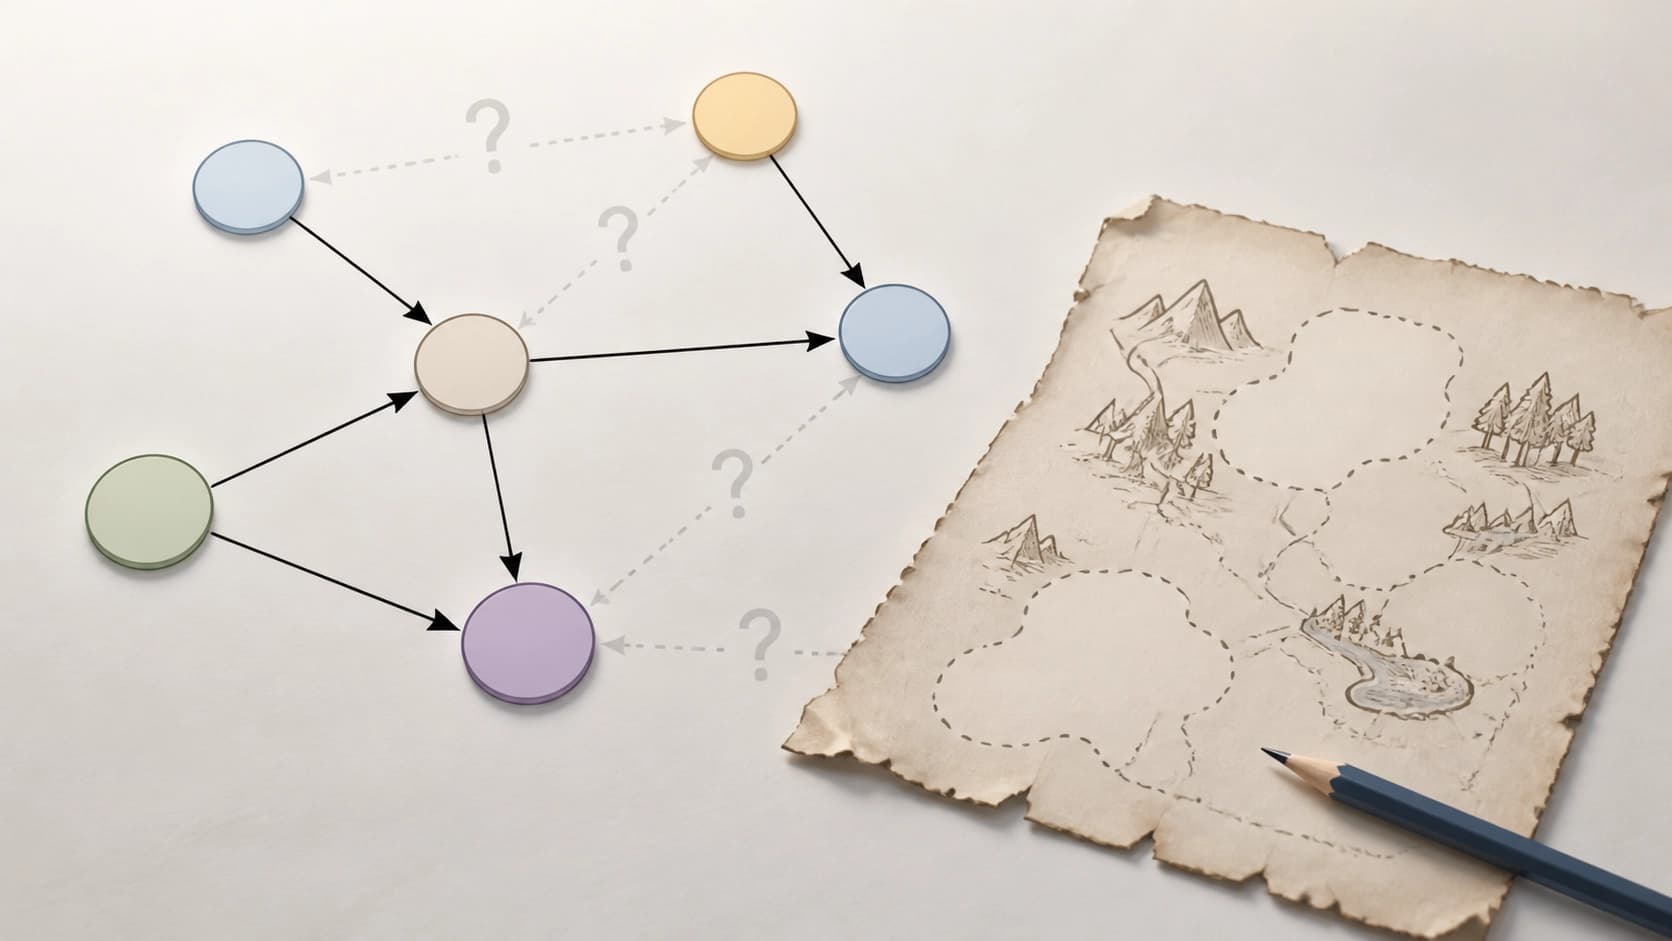
A própria consulta sugere a estrutura
A observação central dos autores pode ser formulada assim: uma consulta contrafactual não é uma pergunta neutra, mas um objeto com lógica interna. Quando perguntamos "o que teria acontecido se a variável X assumisse o valor x", já estamos implicitamente organizando as variáveis em uma certa relação: uma precede a outra, uma depende da outra, uma terceira permanece como condição de fundo.
Isso se formaliza por meio de uma ordem topológica. Em um grafo causal comum, essa ordem é dada por inteiro e de forma inequívoca: se há uma seta de A para B, então A vem antes. Mas, para a identificação, a ordenação completa não é necessária. Basta uma ordem parcial — um conjunto de relações "antes" que não cobre todos os pares de variáveis. Os demais pares simplesmente permanecem não ordenados, e isso não atrapalha.
O resultado central do trabalho consiste em que qualquer consulta contrafactual gera exatamente essa — em geral parcial — ordem topológica sobre as variáveis que dela fazem parte. E essa ordem não precisa ser adivinhada ou introduzida manualmente: ela é extraída da própria formulação da pergunta. O especialista do domínio não precisa mais responder à pergunta incômoda "desenhe o grafo inteiro"; basta concordar com o que decorre do enunciado do problema.
Da ordem à programação linear
Em seguida começa a parte técnica pela qual tudo isso foi concebido. A existência da ordem permite escrever a consulta de forma explicitamente parametrizada. Os parâmetros aqui não são arbitrários, mas subordinados à estrutura: eles descrevem distribuições e mecanismos de modo a serem compatíveis tanto com os dados observados quanto com a ordem derivada.
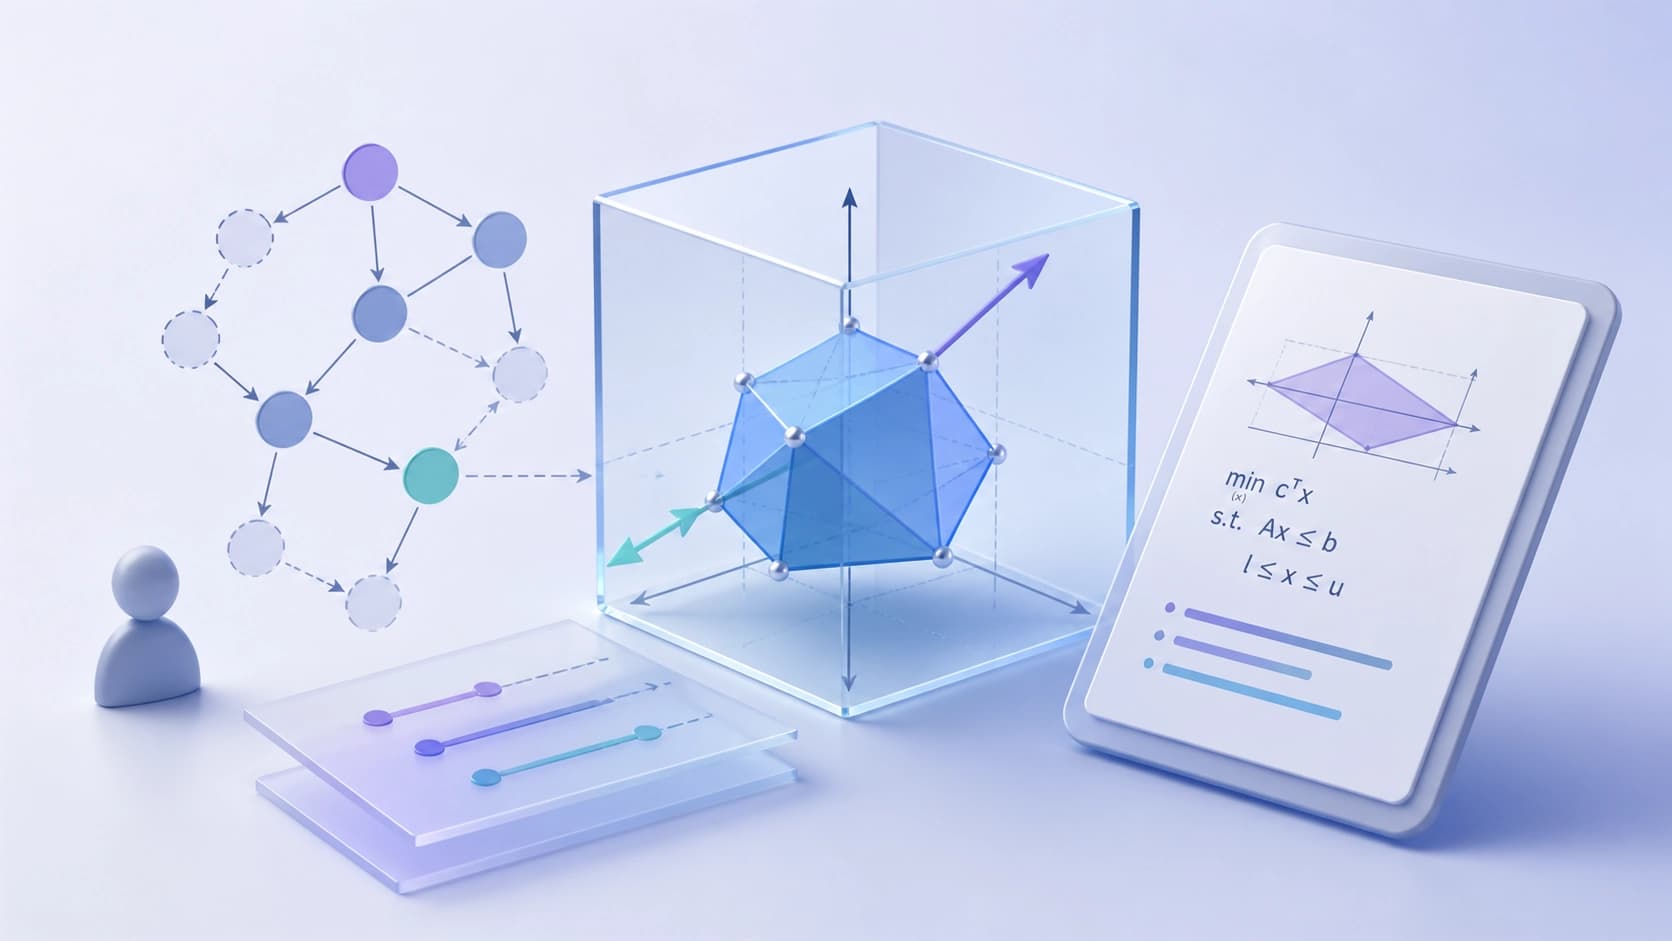
Após essa reparametrização, o problema de identificação deixa de ser um problema sobre funções e se transforma em um problema sobre números. Mais precisamente — em um problema de programação linear: é preciso minimizar e maximizar um funcional linear sobre um conjunto definido por restrições lineares. O mínimo e o máximo fornecem os limites inferior e superior da quantidade de interesse.
Essa transição é valiosa não apenas pela elegância. A programação linear é uma área bem estudada, com solucionadores confiáveis, e converter o problema para essa forma significa que os limites podem de fato ser calculados, e não apenas ter sua existência demonstrada. O esquema funciona para consultas contrafactuais arbitrárias, incluindo as aninhadas: aquelas em que o cenário hipotético contém, ele próprio, outro cenário hipotético. O aninhamento sempre foi uma dor de cabeça para os métodos existentes, pois exige recorrer simultaneamente a várias "camadas" do mundo.
Quão estreitos são os limites
Obter alguns limites não é difícil — a questão é se eles são úteis. Se o intervalo cobre quase toda a faixa concebível de valores, ele serve de pouco.
Os autores respondem a isso com uma prova de precisão. A ideia da construção: para cada limite, constrói-se um modelo causal estrutural que o atinge. Tal modelo deve ser compatível com duas coisas ao mesmo tempo — com a distribuição observada dos dados e com a ordem pressuposta pela consulta. Se o modelo existe, então o limite não é artificial: não se pode deslocá-lo para dentro sem perder a consistência com a informação disponível. Logo, o intervalo é estreito tanto quanto é possível ser sob as suposições dadas.
Trata-se de uma mudança importante no status do resultado. Não se trata de uma "estimativa grosseira de dedo" nem de que "no pior caso pode ser qualquer coisa". Trata-se de uma descrição honesta da incerteza: eis tudo o que se pode afirmar, e nem um passo além.
Relação com o arcabouço clássico
O trabalho se posiciona como uma generalização da abordagem de Tian e Pearl, proposta em 2000 para probabilidades de causalidade. Aquele arcabouço também sabia produzir intervalos em vez de estimativas pontuais, mas estava atrelado a uma classe específica de quantidades e exigia uma estrutura conhecida. O novo resultado amplia a classe de consultas e remove a exigência de conhecer o grafo por inteiro. Vale ter em mente essa continuidade: não estamos diante de uma invenção do zero, mas de uma ampliação cuidadosa daquilo que já foi testado pelo tempo.
Verificação em exemplos conhecidos
Para mostrar que o método não é uma excentricidade, os autores retornam a vários casos analisados anteriormente na literatura e os submetem ao seu procedimento. A condição do experimento é rígida: o grafo causal não é fornecido como entrada de forma alguma. Em seu lugar — apenas a ordem que decorre da formulação da consulta.
O resultado relatado pelos pesquisadores é que os intervalos obtidos permanecem informativos. Em outras palavras, abrir mão do grafo completo não transforma a conclusão em um vazio "tudo é possível". Esta é, talvez, a conclusão mais prática do artigo: o preço da ignorância é menor do que se costuma pensar.
O que isso muda na prática
O valor prático se resume a alguns pontos.
- O limiar de entrada diminui. Não é preciso descrever todo o sistema — basta concordar com a ordem que o próprio enunciado do problema já pressupõe.
- A incerteza torna-se visível. Em vez de uma estimativa pontual, por trás da qual se escondem suposições arbitrárias, o analista recebe um intervalo e entende onde exatamente passa a fronteira de seu conhecimento.
- Surge uma base instrumental. A redução à programação linear significa que o cálculo pode ser automatizado com ferramentas padrão, em vez de escrever um solucionador separado para cada classe de consultas.
- Amplia-se a classe de perguntas admissíveis. Construções contrafactuais aninhadas, que antes exigiam uma teoria à parte, passam a caber no esquema geral.
O que o método não promete
Vale também delimitar o escopo. Em primeiro lugar, a ordem parcial ainda precisa ser extraída corretamente: se da formulação da consulta for derivada uma relação de precedência incorreta, a validade dos limites se perde. Em segundo lugar, a largura do intervalo depende diretamente de quão ricos são os dados observados e de quantas relações foi possível fixar: quanto mais esparsa a ordem, mais ampla a resposta. O método não substitui o conhecimento sobre o domínio — ele permite trabalhar com seus fragmentos em vez do todo ausente.
O artigo tem 15 páginas de texto principal, acompanhadas de três apêndices, três figuras e três tabelas, de modo que os detalhes técnicos das provas ficam fora da exposição principal e estão disponíveis separadamente. Para quem trabalha com inferência causal em dados reais com lacunas na descrição do sistema, esta é, talvez, uma notícia mais interessante do que mais uma estimativa pontual com suposições não declaradas.