
RLTLDR: o agente tira suas próprias conclusões do fracasso e as leva em conta na próxima tentativa
Após uma falha, o agente recebe o sinal do verificador e é solicitado a condensá-lo numa única dica; o treinamento é feito com pares «tarefa — dica», sem professor nem soluções de referência. Em conjuntos de dados complexos de programação e uso de ferramentas, o método eleva o Pass@1 de 0–1% com GRPO para 12–31%, sendo que o principal fator é justamente a aprendizagem desse tipo de associação.
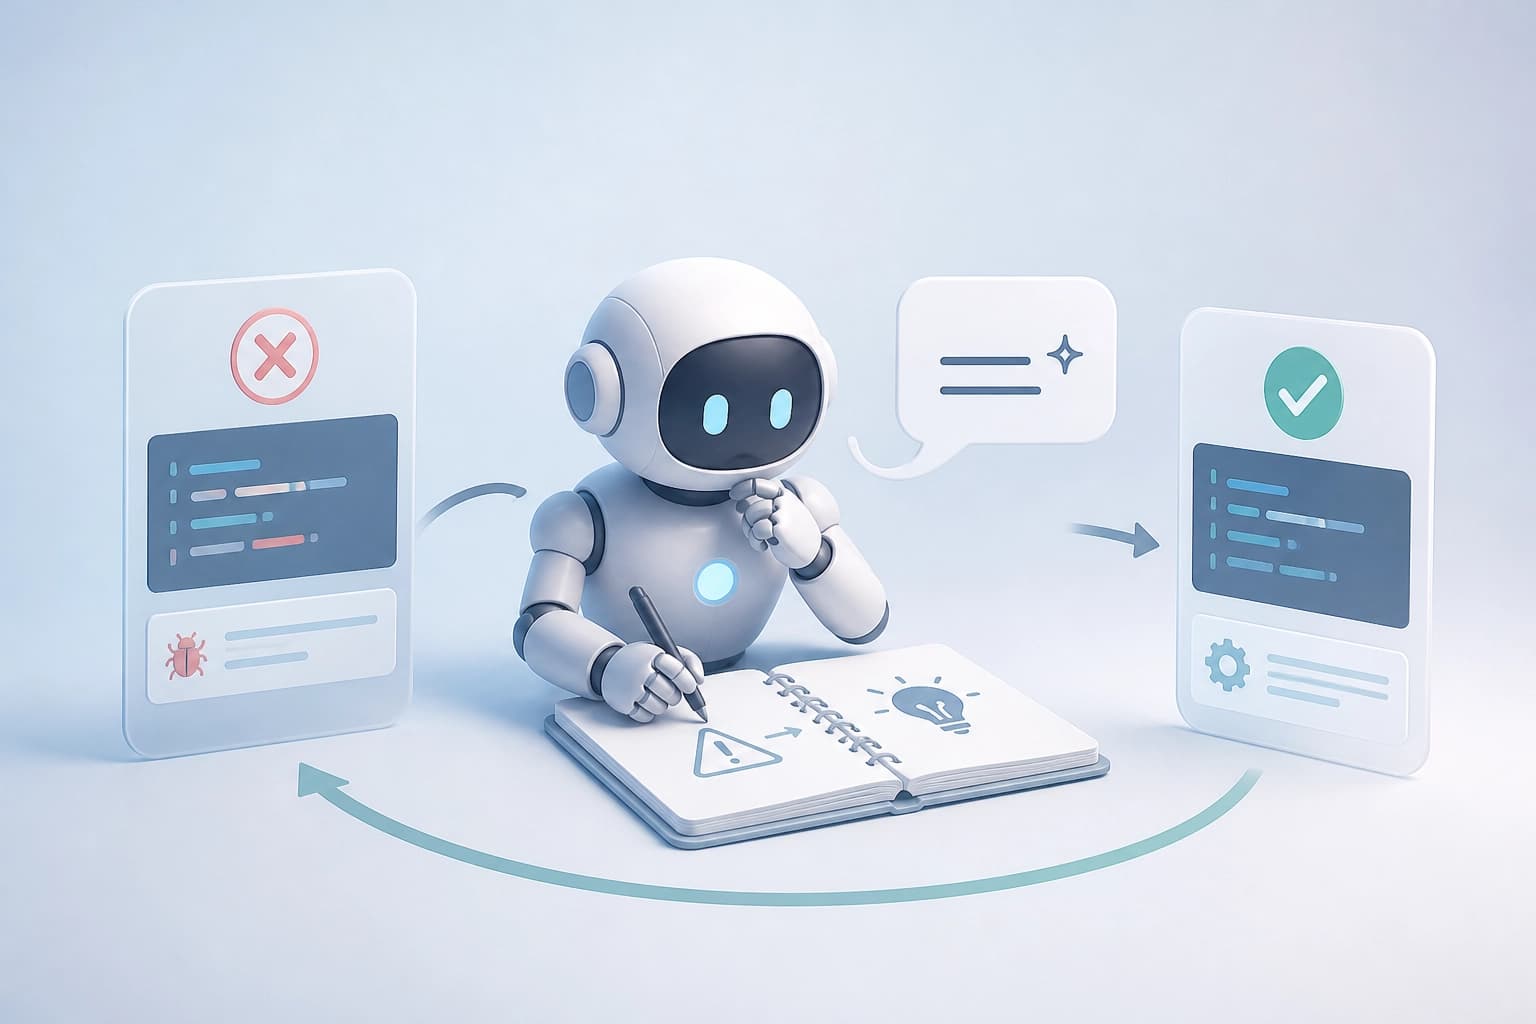
RLTLDR — um método de autoaperfeiçoamento de agentes em tarefas nas quais é difícil alcançar o sucesso. Após uma tentativa falhada, o agente vê a saída do verificador e formula por si próprio uma conclusão breve — um insight TL;DR. A tentativa seguinte tem em conta todas as conclusões anteriores. O trabalho de Michael Kirchhof, Eleonora Gualdoni, Andrew Szot e coautores descreve esta abordagem. A primeira versão foi submetida em 29 de setembro de 2026. A última revisão foi em 19 de outubro de 2026.
O problema que o RLTLDR resolve
O RLTLDR visa o autoaperfeiçoamento de agentes. Nestas tarefas, é difícil para o agente alcançar o sucesso. Não há modelos-professores nem exemplos de soluções para destilação. Por isso, a fonte de feedback passa a ser o insucesso e a saída do verificador.
Condições da tarefa:
- não há modelos-professores;
- não há exemplos de soluções para destilação;
- é difícil para o agente alcançar o sucesso;
- após uma falha, está disponível a saída do verificador.
Conclusão: o RLTLDR é útil quando não há soluções prontas nem um professor, mas existe uma falha verificável. O critério prático é a existência de um verificador cuja saída possa ser transmitida ao agente.
Como funciona o ciclo
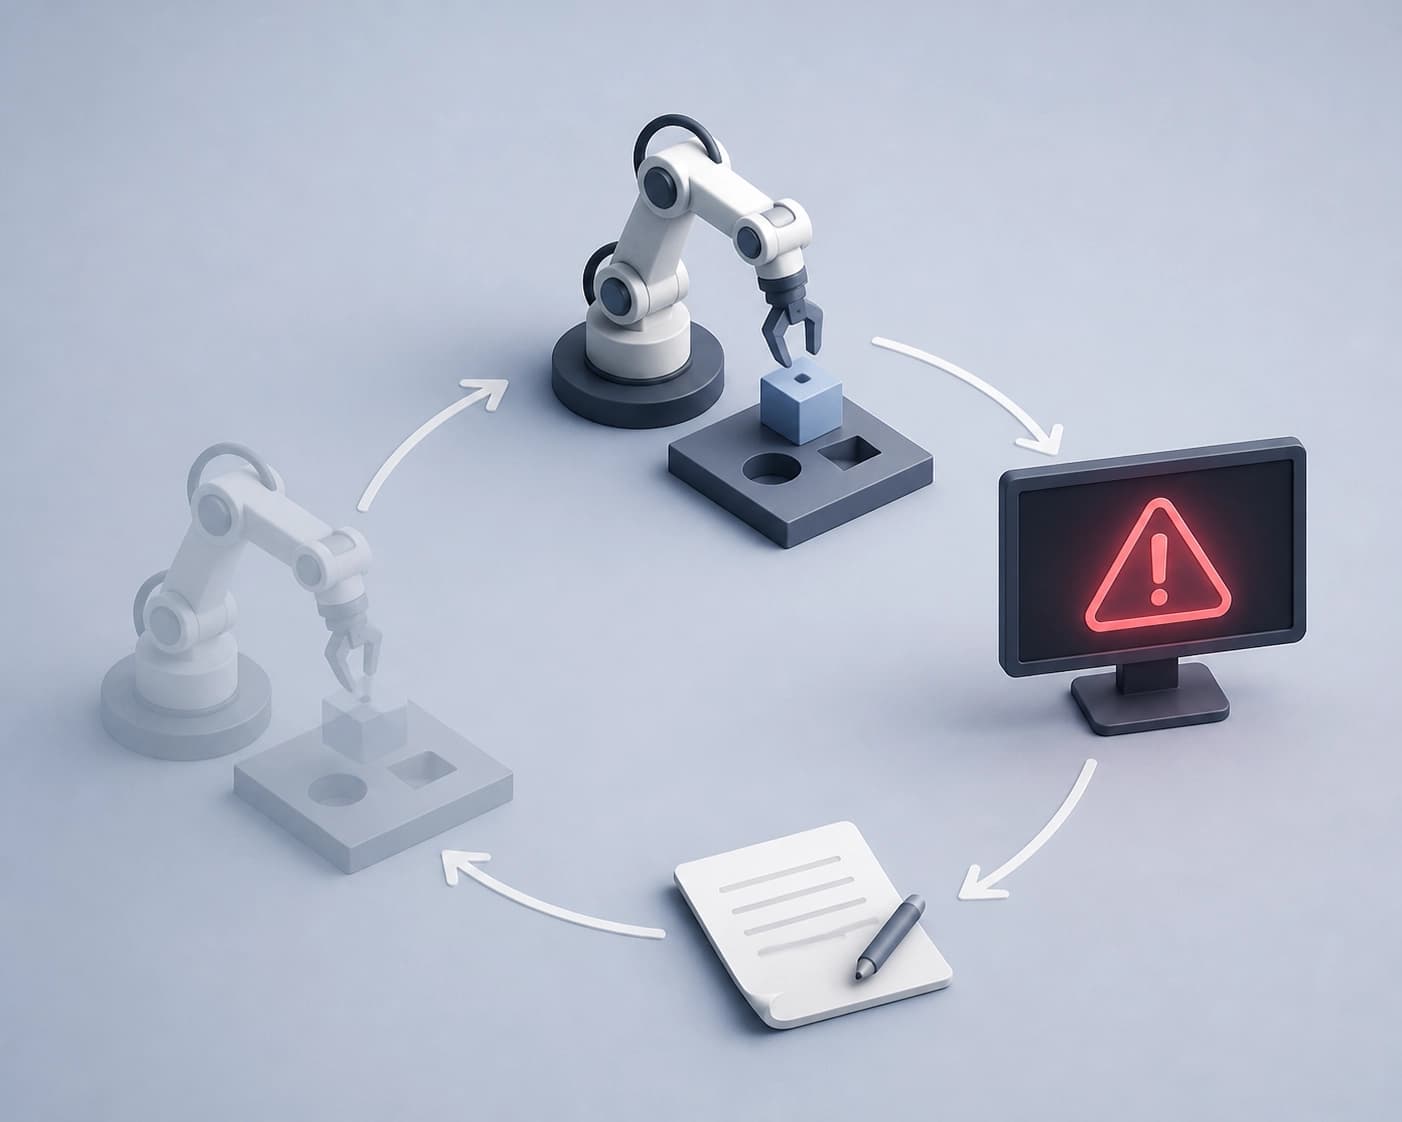
O ciclo do RLTLDR baseia-se em tentativas sucessivas. Cada falha fornece material para o passo seguinte.
Etapas:
- O agente executa um rollout e falha.
- O agente vê a saída do verificador.
- O agente formula o seu próprio feedback — um insight TL;DR breve.
- O rollout seguinte tem em conta todas as conclusões anteriores.
- Os rollouts prosseguem em sequência até ser encontrada uma solução.
- O treino com backpropagation sobre as conclusões no contexto aprende a correspondência «tarefa → conclusão».
Conclusão: o valor do ciclo não está apenas na sugestão para a tentativa seguinte. O fator essencial é aprender a relação entre a tarefa e a conclusão.
Resultados em tarefas difíceis
Os testes foram realizados em conjuntos de avaliação difíceis de tool-calling e programação. Os autores filtraram os conjuntos segundo o critério Pass@128=0. A comparação é feita com a política Qwen 3.5 9B Thinking.
| Abordagem | Condições de avaliação | Pass@1 |
|---|---|---|
| Treino GRPO padrão | Sem o ciclo de conclusões descrito | 0–1% |
| RLTLDR | Conclusões no contexto durante o treino | 14–31% |
| RLTLDR | Sem conclusões no contexto durante a avaliação | 12–13% |
O treino GRPO padrão mantém-se num Pass@1 entre 0% e 1%. O RLTLDR atinge 14–31% quando há conclusões no contexto durante o treino. Sem conclusões no contexto durante a avaliação, o resultado é de 12–13%. Os autores destacam a aprendizagem da correspondência «tarefa → conclusão» como fator essencial.
Conclusão: as conclusões no contexto aumentam o Pass@1. Para verificar a aprendizagem, é necessário avaliar o método com e sem conclusões.
SFTLDR: treino com pares «tarefa — conclusão»
O SFTLDR é uma variante de treino compacta. Aprende apenas com pares (tarefa, conclusão). Não utiliza rollouts nem backpropagation sobre os mesmos.
O que se sabe sobre o SFTLDR:
- o treino é feito apenas com pares (tarefa, conclusão);
- o SFTLDR não apresenta rollouts;
- o SFTLDR não aplica backpropagation sobre rollouts;
- o treino com 4k desses pares recupera quase todo o desempenho do RLTLDR;
- o SFTLDR quase alcança o desempenho do SFT clássico com rollouts completos;
- os autores descrevem a abordagem como um paradigma compacto: «para tarefas deste tipo, mantém em mente coisas deste tipo».
Conclusão: o SFTLDR é uma opção para um treino compacto. Critério: avaliá-lo quando for possível reunir pares «tarefa — conclusão».
Critérios de aplicabilidade
O RLTLDR requer feedback verificável e tentativas sucessivas. Sem estas condições, não é possível montar o ciclo. Os critérios abaixo ajudam a avaliar a aplicabilidade.
Critérios:
- a tarefa permite tentativas falhadas e rollouts repetidos;
- existe um verificador cuja saída pode ser mostrada ao agente;
- o agente consegue formular uma conclusão breve;
- a tentativa seguinte tem em conta todas as conclusões anteriores;
- a avaliação inclui um modo sem conclusões no contexto, se for importante verificar a aprendizagem.
Conclusão: escolhe-se o RLTLDR para tarefas em que existe um verificador e é difícil alcançar o sucesso. Escolhe-se o SFTLDR quando é necessário um modo compacto baseado em pares «tarefa — conclusão».
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
FedSocket: modelos intercambiáveis com executabilidade obrigatória no destinatário perante a heterogeneidade multimodal
É proposto o FedSocket — uma abordagem em que o modelo partilhado tem de poder ser executado no lado do destinatário, enquanto modelos privados heterogéneos são ligados por uma interface comum de previsões Q. O artigo descreve a agregação que tem em conta a pertença, o envio apenas dos parâmetros Q juntamente com os contadores e experiências em seis conjuntos de dados, que demonstram um aumento da precisão quando faltam modalidades e a vantagem da inferência conjunta sobre conjuntos independentes.
13 novembro 2026
Robustez dos detetores perante texto gerado por máquina e parafraseado: o que os testes revelaram
O artigo reúne os resultados de testes de ferramentas que reescrevem trechos gerados num estilo mais natural. Após esse processamento, a detetabilidade diminui consideravelmente, e os falsos positivos que persistem não permitem considerar o veredito do detetor como prova.
13 novembro 2026
CyberArena: confrontos entre agentes de IA revelam os limites dos benchmarks estáticos de cibersegurança
O benchmark coloca dois agentes em ambientes isolados com serviços em constante mudança e, após uma série de rodadas, resume as suas ações em avaliações multidimensionais de competências ofensivas e defensivas. Em 466 partidas com 12 modelos de ponta, distinguiu capacidades onde os testes unilaterais atingem o seu limite, incluindo o planeamento de vários movimentos e a criação de backdoors.
13 novembro 2026