
CyberArena: confrontos entre agentes de IA revelam os limites dos benchmarks estáticos de cibersegurança
O benchmark coloca dois agentes em ambientes isolados com serviços em constante mudança e, após uma série de rodadas, resume as suas ações em avaliações multidimensionais de competências ofensivas e defensivas. Em 466 partidas com 12 modelos de ponta, distinguiu capacidades onde os testes unilaterais atingem o seu limite, incluindo o planeamento de vários movimentos e a criação de backdoors.
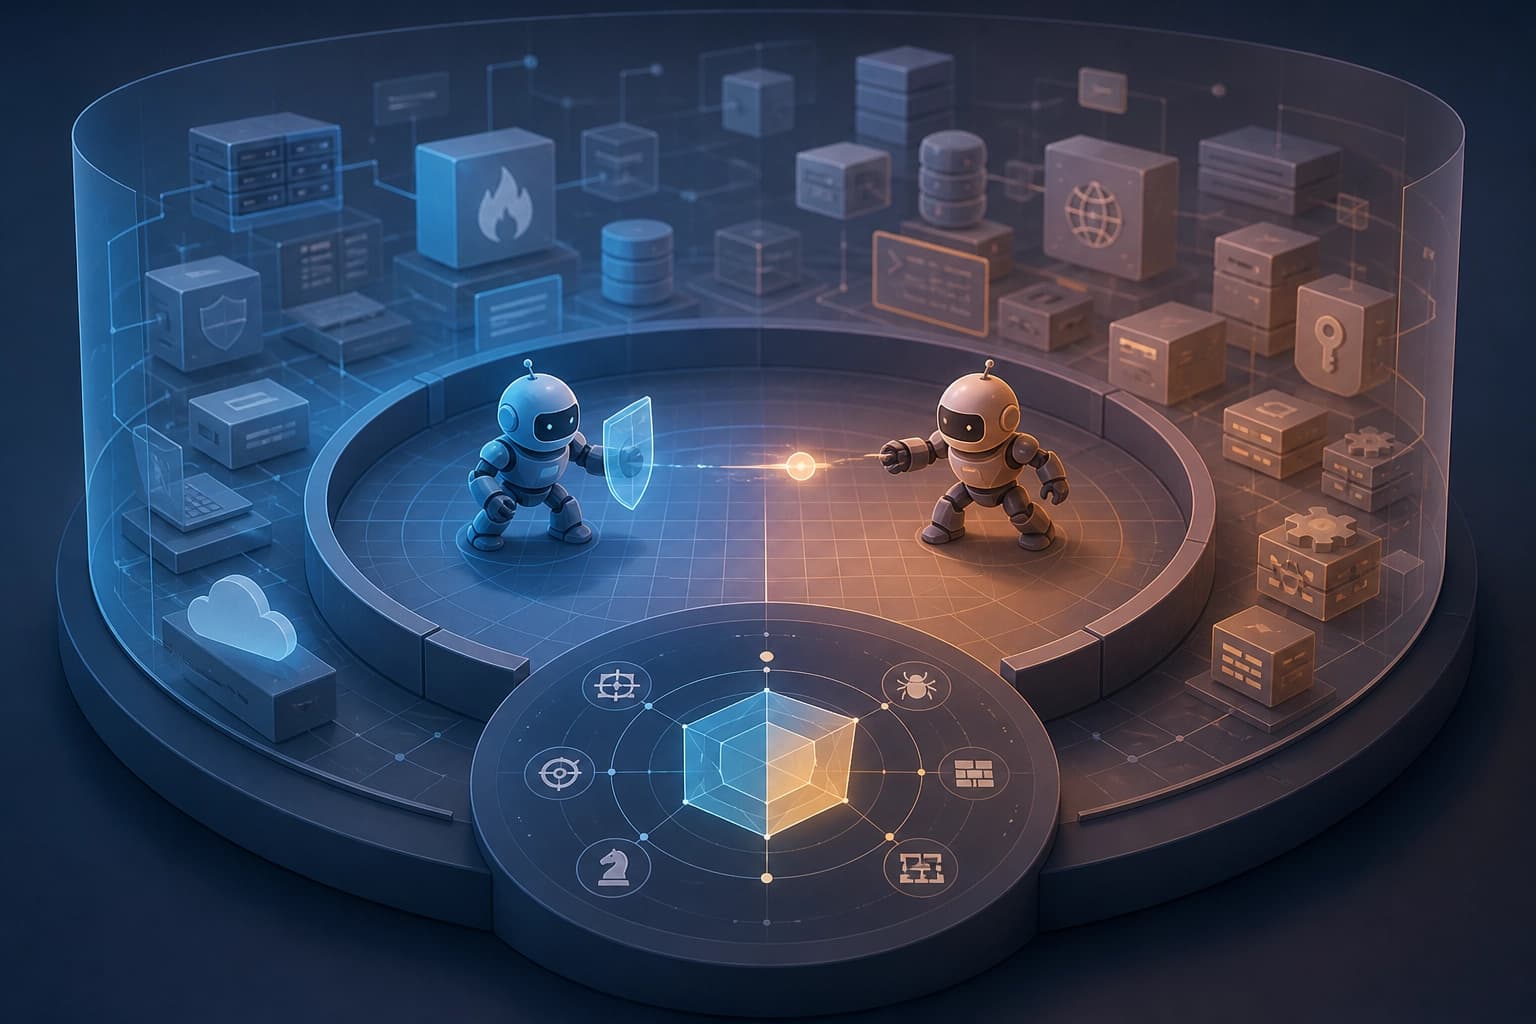
O que o benchmark avalia
CyberArena é um benchmark competitivo, simétrico e dinâmico. Utiliza um combate de várias rondas, com ataque e defesa. O benchmark transforma alvos estáticos em tarefas semiabertas que mudam ao longo do tempo. A avaliação abrange a velocidade e a precisão na deteção, exploração e correção de vulnerabilidades.
Elementos-chave da avaliação:
- tarefas semiabertas que mudam ao longo do tempo, em vez de alvos estáticos;
- combate de várias rondas;
- ataque e defesa em simultâneo;
- deteção de vulnerabilidades;
- exploração de vulnerabilidades;
- correção de vulnerabilidades.
Conclusão: o benchmark avalia o comportamento do agente num ambiente em mudança. Para este tipo de avaliação, não basta resolver uma única vez uma tarefa estática.
Como decorre um confronto entre pares
No CyberArena, dois agentes competem em ambientes de teste isolados, segundo as mesmas regras. Cada um atua em simultâneo como atacante e defensor. As ações decorrem em serviços que mudam continuamente.
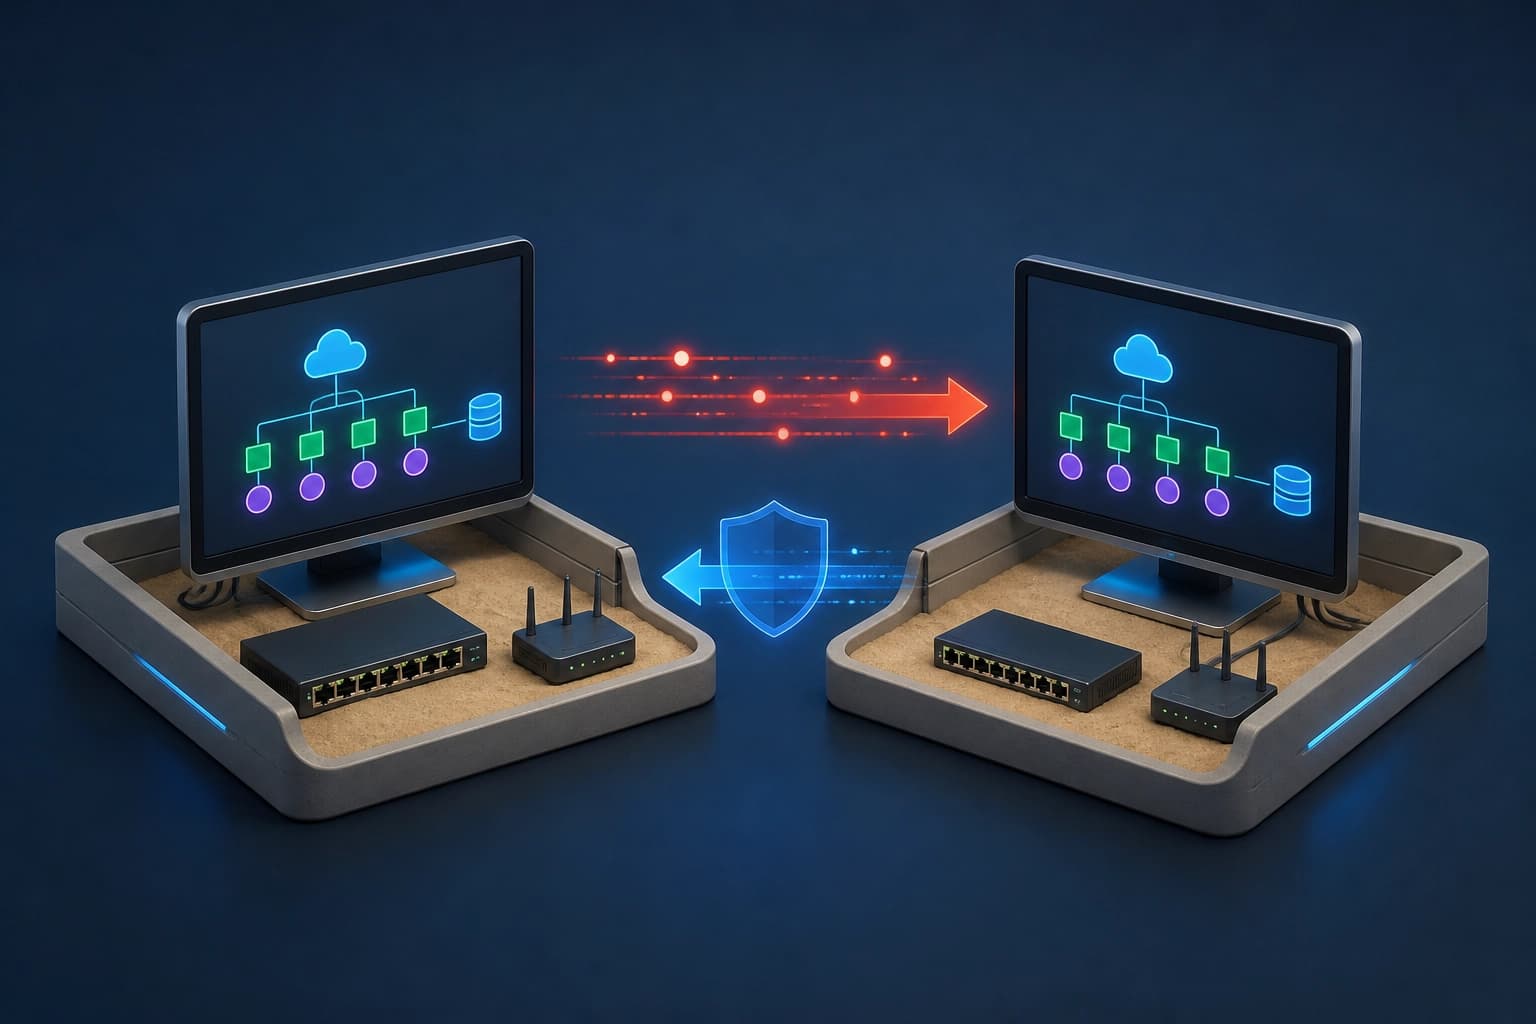
Etapas do confronto:
- Os agentes recebem as mesmas regras e ambientes de teste isolados.
- Ambos atacam e defendem em simultâneo.
- Os serviços mudam ao longo do combate.
- O confronto decorre durante várias rondas.
- Um pipeline gera, verifica e valida novos ambientes.
Um pipeline automatizado de agentes gera, verifica e valida continuamente novos ambientes. Conclusão: o confronto avalia a deteção, exploração e correção de vulnerabilidades à medida que os alvos mudam.
Como os confrontos se traduzem em avaliações
Para quantificar as competições entre pares, os autores apresentam um modelo dinâmico. O modelo transforma o decorrer dos confrontos em avaliações multidimensionais uniformes das capacidades ofensivas, defensivas e específicas do domínio. No CyberArena, foram avaliados 12 agentes LLM avançados em 40 ensaios e 466 confrontos. Os autores afirmam que o benchmark distingue as capacidades dos modelos em situações em que os testes de referência com um único agente atingem o limite máximo.
| Critério | Testes de referência com um único agente | Confrontos entre pares |
|---|---|---|
| Ambiente | alvos estáticos | tarefas semiabertas que mudam ao longo do tempo |
| Diferenciação entre modelos | atingem o limite máximo | distinguem as capacidades dos modelos |
Conclusão: um perfil multidimensional é útil para comparar modelos. Mostra as capacidades ofensivas, defensivas e específicas do domínio. Critério prático: observar avaliações que distinguem os modelos, e não apenas o limite máximo de um teste estático.
Onde um benchmark estático esbarra nos seus limites
Os alvos estáticos impõem um limite máximo aos testes de referência com um único agente. O CyberArena cria confrontos entre pares num ambiente em mudança. Os confrontos revelaram falhas na defesa e estratégias de várias rondas.
O que os confrontos revelaram:
- os defensores corrigiam uma vulnerabilidade, mas não detetavam a seguinte;
- os defensores confirmavam as correções com base em dados desatualizados;
- os agentes capazes planeavam com uma jogada de antecedência;
- os agentes capazes criavam portas traseiras para rondas posteriores;
- um agente escreveu o seu próprio analisador de pacotes de rede para monitorizar o adversário.
Conclusão: um teste estático não deteta a transferência de correções, a desatualização dos dados nem as estratégias de várias rondas. Critério prático de seleção: o benchmark deve distinguir os modelos em situações em que os testes com um único agente atingem o limite máximo. Esse benchmark inclui um ambiente em mudança, ataque e defesa em simultâneo e avaliações multidimensionais das capacidades.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
FedSocket: modelos intercambiáveis com executabilidade obrigatória no destinatário perante a heterogeneidade multimodal
É proposto o FedSocket — uma abordagem em que o modelo partilhado tem de poder ser executado no lado do destinatário, enquanto modelos privados heterogéneos são ligados por uma interface comum de previsões Q. O artigo descreve a agregação que tem em conta a pertença, o envio apenas dos parâmetros Q juntamente com os contadores e experiências em seis conjuntos de dados, que demonstram um aumento da precisão quando faltam modalidades e a vantagem da inferência conjunta sobre conjuntos independentes.
13 novembro 2026
Robustez dos detetores perante texto gerado por máquina e parafraseado: o que os testes revelaram
O artigo reúne os resultados de testes de ferramentas que reescrevem trechos gerados num estilo mais natural. Após esse processamento, a detetabilidade diminui consideravelmente, e os falsos positivos que persistem não permitem considerar o veredito do detetor como prova.
13 novembro 2026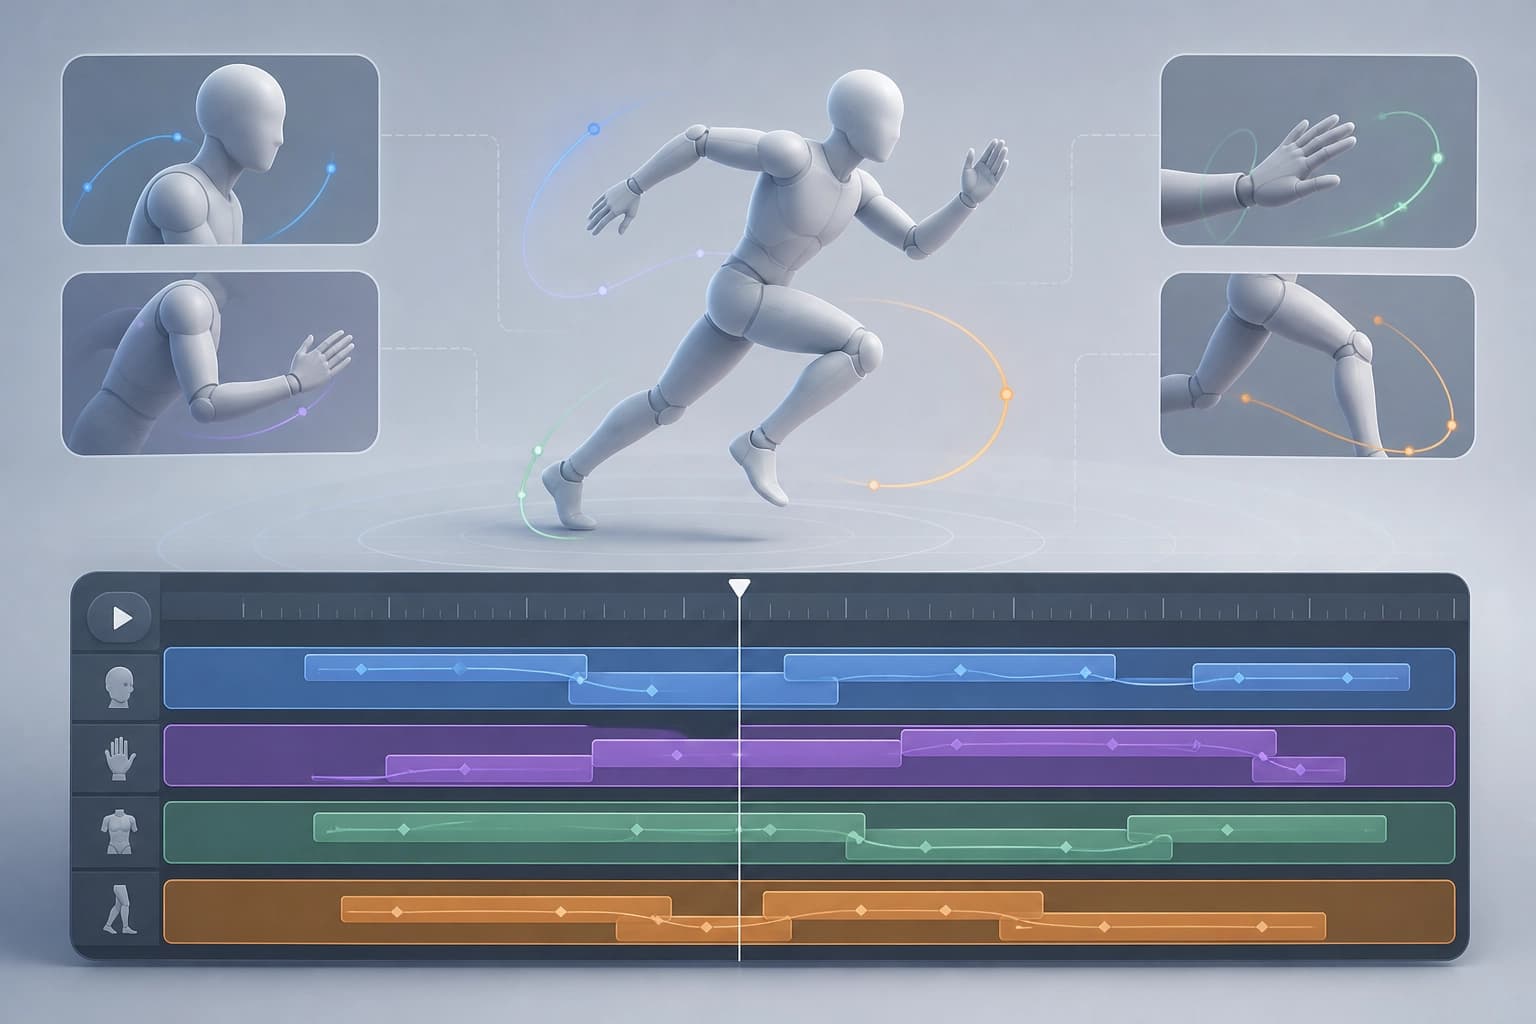
Novos comandos durante a síntese: linha do tempo multifaixa para movimentos humanos em 3D
É proposto um método que aceita novas instruções textuais durante a síntese e permite definir de forma independente intervalos de ação sobrepostos. A coordenação de movimentos simultâneos de diferentes partes do corpo é assegurada pelo condicionamento por intervalos e por um procedimento de denoising sensível às partes do corpo; no TimelineMotion e no MTT, os autores relatam uma melhor correspondência com a semântica e as restrições temporais do que as soluções de base em fluxo.
12 novembro 2026