
Robustez dos detetores perante texto gerado por máquina e parafraseado: o que os testes revelaram
O artigo reúne os resultados de testes de ferramentas que reescrevem trechos gerados num estilo mais natural. Após esse processamento, a detetabilidade diminui consideravelmente, e os falsos positivos que persistem não permitem considerar o veredito do detetor como prova.
Como a paráfrase altera o texto e os sinais dos detetores
Conteúdo de IA humanizado é texto gerado por máquina que foi parafraseado para soar mais natural. As ferramentas alteram a escolha das palavras, o comprimento das frases e o tom. Algumas acrescentam um ritmo irregular ou reescrevem o texto várias vezes. Estas alterações afetam os sinais em que os detetores se baseiam: a previsibilidade das palavras e a variação no comprimento das frases.
- escolha das palavras;
- comprimento das frases;
- tom;
- ritmo irregular;
- reescrita repetida.
Conclusão: a paráfrase altera precisamente as características que os detetores usam para distinguir o texto gerado por máquina.
O que os testes revelaram sobre o texto parafraseado
Os testes avaliaram se os detetores continuavam fiáveis após a paráfrase. Um estudo de 2025 abrangeu 19 ferramentas de humanização e paráfrase.
| Teste | Resultado |
|---|---|
| Estudo de 2025, 19 ferramentas | Muitos detetores não reconhecem texto humanizado. |
| Google Research | O modelo de paráfrase preserva o sentido e evita, em grande medida, a deteção. |
| Paráfrase do ChatGPT com o QuillBot | A precisão do detetor em texto do ChatGPT caiu para 49%. |
| Outro teste | A paráfrase do ChatGPT contornou cada detetor em pelo menos metade dos casos. |
| Stanford, linguagem literária | A deteção de texto de IA caiu de 100% para 13% quando pediram ao ChatGPT que usasse uma linguagem mais literária. |
Conclusão: a resistência dos detetores a texto gerado por máquina e parafraseado é baixa.
O que os detetores identificam no texto
Os detetores baseiam-se em características que nem sempre estão relacionadas com a origem automatizada do texto. Investigadores da Carnegie Mellon concluíram que o texto de modelos de base parecia muitas vezes ter sido escrito por uma pessoa ao GPTZero e ao Pangram. Já o texto de modelos aperfeiçoados para seguir instruções não parecia ter sido escrito por uma pessoa. A equipa considera que os detetores identificam mais os vestígios do treino do modelo do que um sinal fiável de escrita automática.
- modelos de base: o texto parece muitas vezes ter sido escrito por uma pessoa ao GPTZero e ao Pangram;
- modelos aperfeiçoados para seguir instruções: o texto não parece ter sido escrito por uma pessoa;
- conclusão da equipa: os detetores identificam vestígios do treino.
A Stanford testou sete detetores em 91 ensaios de autores para quem o inglês não era a língua materna. A taxa média de falsos positivos foi de 61,3%. Pelo menos uma ferramenta assinalou mais de 91% dos ensaios. Os ensaios de autores para quem o inglês era a língua materna obtiveram valores próximos de zero. Os investigadores associam a diferença à escolha de palavras simples e previsíveis, que os detetores confundem com texto gerado por máquina.
Conclusão: o sinal de um detetor não prova que o texto tenha sido gerado por máquina; por isso, a avaliação exige contexto.
Precisão declarada e limitações reais
Testes independentes e testes dos próprios criadores apresentam diferentes estimativas de precisão. As condições de avaliação alteram o resultado.
- Análise de testes independentes: a precisão do Turnitin, do GPTZero e do Originality.ai situa-se entre 70% e 85%. Estas ferramentas continuam a apresentar falsos positivos.
- O Turnitin declara uma precisão de 98% e uma taxa de falsos positivos inferior a 1%. Esta declaração aplica-se apenas a documentos em que a IA gerou mais de 20% do texto.
- A OpenAI encerrou o seu próprio classificador em julho de 2023. O classificador identificava apenas 26% do texto gerado por IA.
- Os autores do estudo de 2025 treinaram um modelo com exemplos humanizados. O modelo identificava texto humanizado com uma baixa taxa de falsos positivos. Mantinha a eficácia mesmo perante tentativas de o enganar. Os resultados foram obtidos pelos próprios autores do modelo; são necessários testes independentes.
Conclusão: a precisão declarada depende das condições, e os testes independentes revelam os limites da deteção.
Avaliação prática de um detetor
Os especialistas recomendam que se considere a avaliação de um detetor como uma indicação, e não como prova. Para verificar, pode ter-se em conta o histórico de rascunhos, fazer perguntas orais breves e comparar com trabalhos realizados na aula. Os especialistas aconselham autores e editores a pedir fontes, entrevistas e dados originais.
- histórico de rascunhos;
- perguntas orais breves;
- comparação com trabalhos realizados na aula;
- fontes, entrevistas e dados originais para autores e editores.
Critério prático: o detetor serve de alerta para uma verificação adicional, não de fundamento único para chegar a uma conclusão.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
FedSocket: modelos intercambiáveis com executabilidade obrigatória no destinatário perante a heterogeneidade multimodal
É proposto o FedSocket — uma abordagem em que o modelo partilhado tem de poder ser executado no lado do destinatário, enquanto modelos privados heterogéneos são ligados por uma interface comum de previsões Q. O artigo descreve a agregação que tem em conta a pertença, o envio apenas dos parâmetros Q juntamente com os contadores e experiências em seis conjuntos de dados, que demonstram um aumento da precisão quando faltam modalidades e a vantagem da inferência conjunta sobre conjuntos independentes.
13 novembro 2026
CyberArena: confrontos entre agentes de IA revelam os limites dos benchmarks estáticos de cibersegurança
O benchmark coloca dois agentes em ambientes isolados com serviços em constante mudança e, após uma série de rodadas, resume as suas ações em avaliações multidimensionais de competências ofensivas e defensivas. Em 466 partidas com 12 modelos de ponta, distinguiu capacidades onde os testes unilaterais atingem o seu limite, incluindo o planeamento de vários movimentos e a criação de backdoors.
13 novembro 2026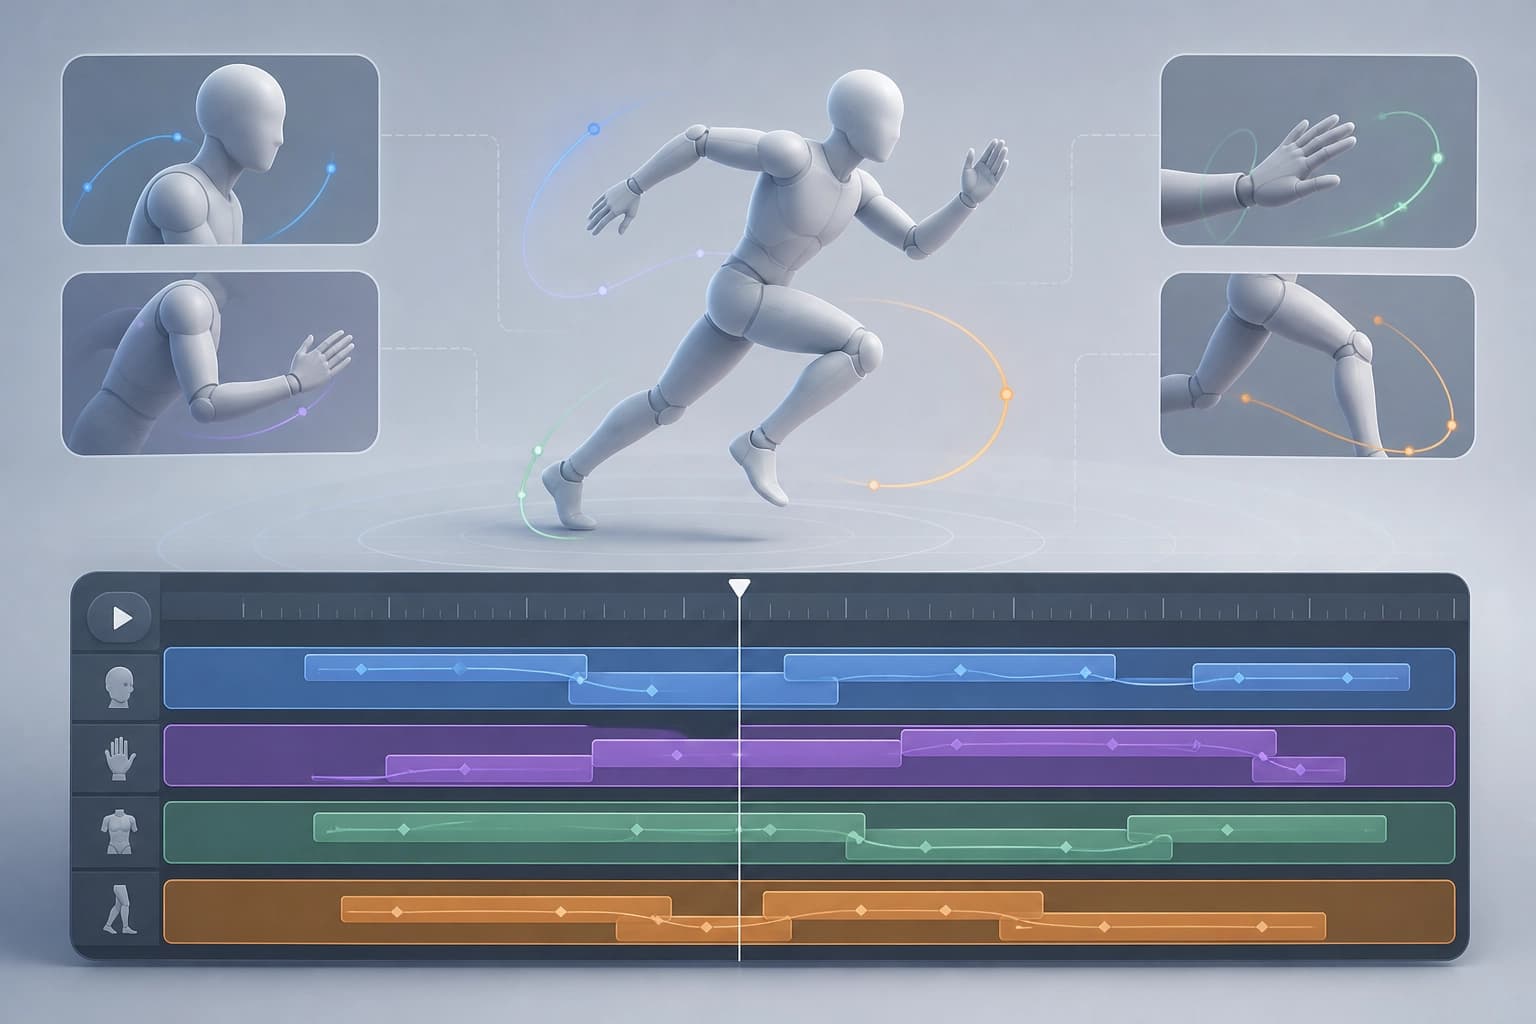
Novos comandos durante a síntese: linha do tempo multifaixa para movimentos humanos em 3D
É proposto um método que aceita novas instruções textuais durante a síntese e permite definir de forma independente intervalos de ação sobrepostos. A coordenação de movimentos simultâneos de diferentes partes do corpo é assegurada pelo condicionamento por intervalos e por um procedimento de denoising sensível às partes do corpo; no TimelineMotion e no MTT, os autores relatam uma melhor correspondência com a semântica e as restrições temporais do que as soluções de base em fluxo.
12 novembro 2026