
ReproAgent: agente de IA monta código funcional a partir de artigo científico, com base no "contrato de implementação"
Recriar um repositório a partir de uma publicação é dificultado por uma especificação fragmentada: parte das informações se perde ao longo da longa cadeia de raciocínio do agente, e outra parte simplesmente não é mencionada no texto do artigo, por se tratar de padrões implícitos consagrados dos frameworks. O ReproAgent resolve isso por meio de um ciclo de quatro etapas e de um contrato permanente que vincula os requisitos do artigo às evidências de repositórios abertos relacionados; no benchmark PaperBench Code-Dev, a abordagem obteve o melhor resultado médio entre os scaffolds com o mesmo modelo base.
De artigo a repositório: onde a cadeia se rompe
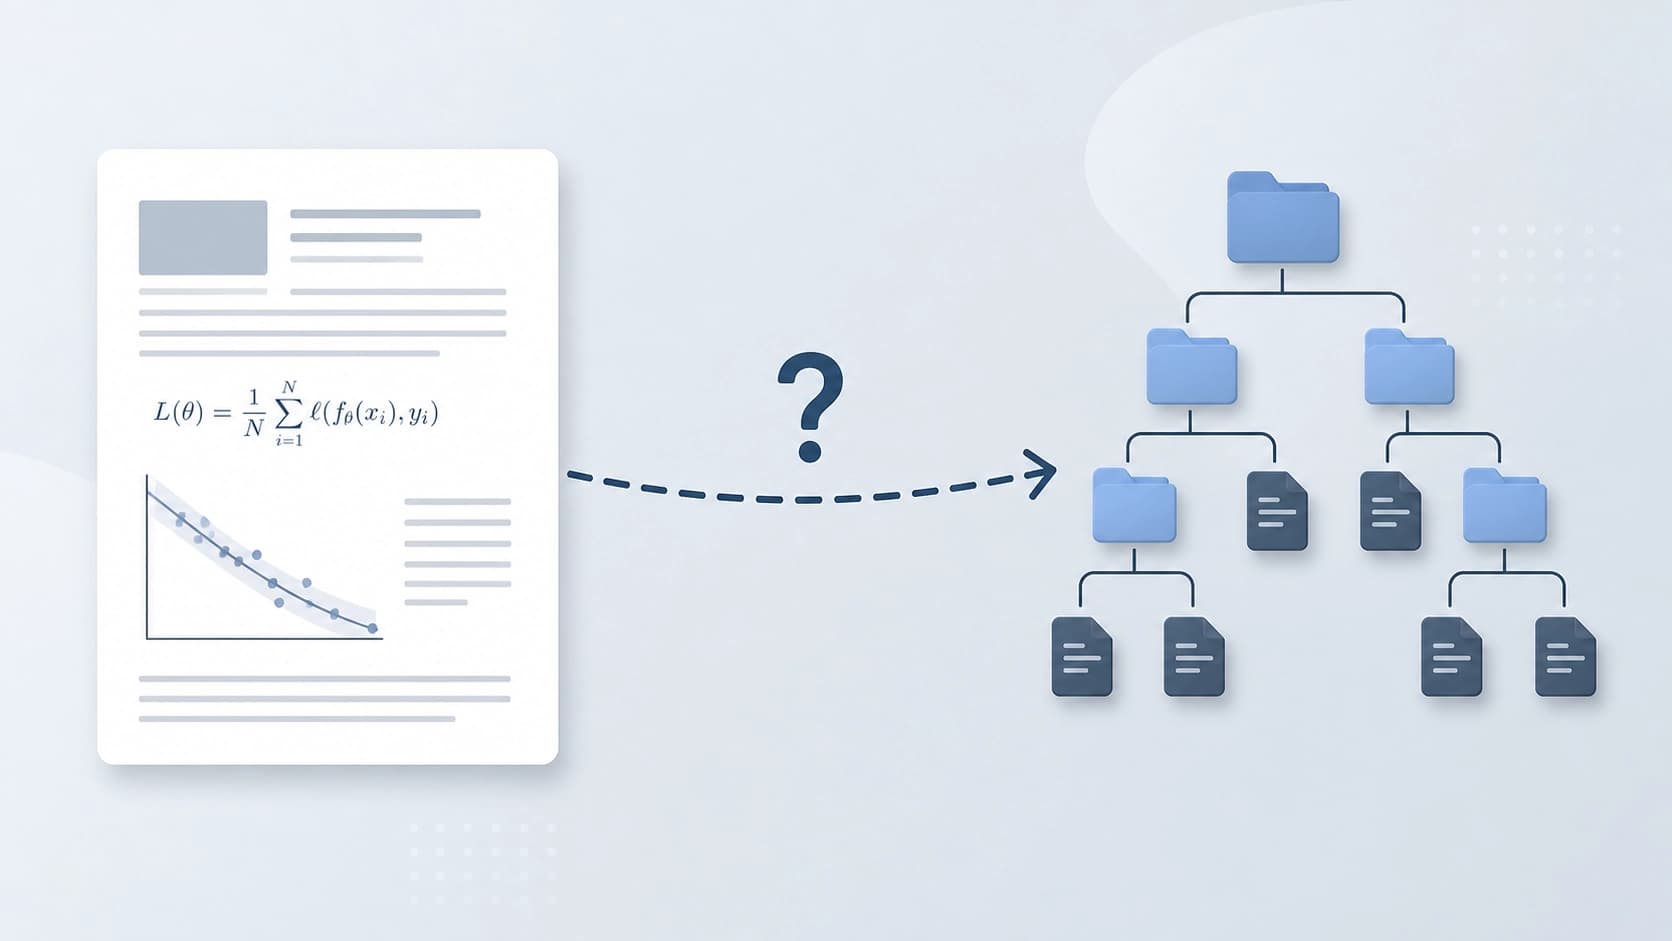
Uma publicação científica não é um manual de montagem. Mesmo um texto detalhado com fórmulas e gráficos não contém tudo o que é necessário para executar o código e obter os mesmos números. É exatamente essa lacuna que o trabalho intitulado ReproAgent: Contract-Guided Paper-to-Code Reproduction investiga — ele formaliza a tarefa de paper-to-code reproduction: um agente de IA científico deve transformar um artigo em um repositório executável, no qual sejam preservados o método, o protocolo experimental e os artefatos.
A razão da dificuldade, segundo os autores, não está na "fraqueza" dos modelos, mas na fragmentação da especificação. A parte explícita — algoritmos, métricas, composição dos artefatos — está presente no artigo, mas em trajetórias longas do agente esses detalhes gradualmente se perdem, são diluídos do contexto de trabalho. A parte implícita — padrões dos frameworks, convenções herdadas de trabalhos relacionados — não é mencionada no texto: para os autores do artigo, isso é tão óbvio que dispensa palavras. Tais detalhes não podem ser reconstruídos "por suposições gerais", e sem eles o código ou não executa, ou produz resultados diferentes.
Dados formais do preprint: arXiv:2608.24291, categoria principal — cs.AI, adicionalmente indicada cs.SE; submetido em 25 de agosto de 2026. Autores — Xue Hu, Zewei Pan, Zhongyuan Wang, Zhou Liu, Zeli Su e Wentao Zhang, remetente — Xue Hu. O trabalho foi aceito no Findings of EMNLP 2026, DOI: 10.48550/arXiv.2608.24291.
O contrato de implementação como âncora para o agente
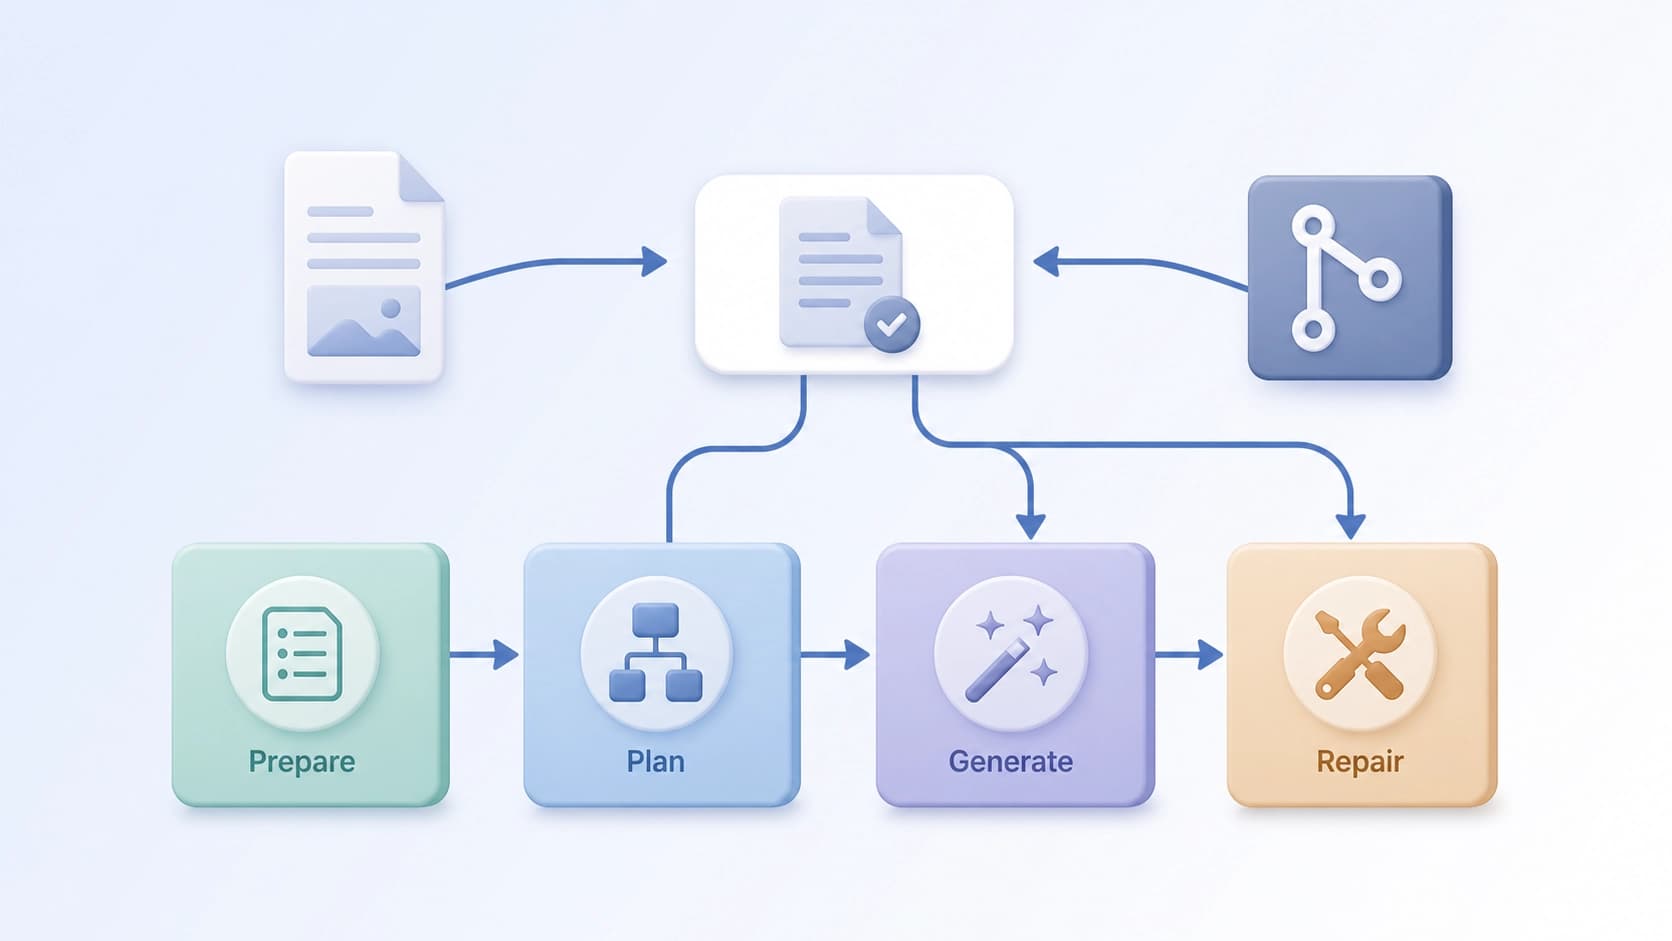
A ideia central do ReproAgent não é deixar o agente "apenas ler o artigo e escrever código". Em vez disso, constrói-se um contrato de implementação (implementation contract) permanente — um artefato que vive ao longo de todo o trabalho e sobrevive a trajetórias longas, ao contrário do texto original no contexto.
O contrato é preenchido a partir de dois canais independentes:
- canal de requisitos (implementation-requirement) — transforma trechos do artigo em obrigações concretas de código: o que exatamente deve ser implementado, quais métricas devem ser calculadas, quais dados devem ser carregados;
- canal de evidências (reference-evidence) — extrai pistas de conteúdo e estruturais de repositórios relacionados, ou seja, traz aquelas mesmas convenções implícitas que não estão no texto.
Em seguida, ambos os fluxos convergem: eles são vinculados a work packages — pacotes de trabalho — e depois projetados em contratos no nível de arquivos individuais. Essa projeção é importante porque é justamente no nível dos arquivos que o agente precisa agir, e é aí que normalmente se perde a conexão entre a "ideia do artigo" e a "linha no código".
O sentido da construção é que a obrigação é primária e a geração é secundária. O agente não tenta lembrar o detalhe necessário no momento de escrever o código — ele consulta um requisito já fixado.
Quatro estágios e o papel do reparo
O trabalho é descrito como um pipeline de quatro estágios consecutivos, que formam a sigla Prepare — Plan — Generate — Repair.
- Prepare — preparação: análise do artigo e dos materiais relacionados, preenchimento inicial do contrato.
- Plan — planejamento: divisão da tarefa em pacotes de trabalho e vinculação de obrigações e evidências a eles.
- Generate — geração de código a partir dos contratos no nível de arquivos.
- Repair — reparo: o contrato é reutilizado para entender o que exatamente divergiu do requisito, em vez de remendar erros ao acaso.
Observe a assimetria: o contrato é necessário não apenas na entrada, mas também no final — na correção de erros. Essa é, talvez, a parte mais prática da concepção. A maioria dos pipelines agênticos é forte na etapa de escrita e fraca na etapa de depuração, porque, no momento do primeiro erro, a especificação original já está difusa. Aqui ela permanece à mão.
Verificação: PaperBench Code-Dev
Os autores testaram a abordagem no PaperBench Code-Dev — um benchmark em que o agente deve reproduzir código a partir de artigos científicos. Resultado: a maior pontuação média entre scaffolds com o mesmo backbone. É importante que o efeito seja observado com dois modelos base diferentes — Claude Sonnet 4.5 e Gemini 3 Flash.
O que significam esses termos. Backbone — o modelo base, o "cérebro" do agente. Scaffold — a estrutura ao redor dele: regras, memória, ordem dos passos, ferramentas. A comparação com o mesmo backbone é a forma correta de mostrar que o ganho vem justamente da arquitetura, e não de um modelo mais forte. O ReproAgent é precisamente uma contribuição para a classe dos scaffolds.
Além disso, os autores realizaram ablações por canal: se o canal de requisitos ou o canal de evidências for desativado, a qualidade end-to-end cai. Somam-se a isso análises de artigos individuais, nas quais se vê qual contribuição cada canal oferece em exemplos concretos. Esse duplo controle — medição geral mais análise qualitativa — torna as conclusões mais convincentes do que um único número em uma tabela.
O código e os artefatos experimentais, segundo os autores, estão em acesso aberto.
O que isso muda na prática
O valor do trabalho não está apenas no resultado no benchmark, mas na própria formulação do problema. A "fragmentação da especificação" é uma boa explicação de por que os agentes escrevem com confiança um código que parece correto, mas não reproduz os resultados. Os detalhes explícitos se perdem à medida que a trajetória se alonga; os implícitos estão ausentes desde o início.
O contrato de implementação oferece um caminho alternativo: retirar as obrigações do contexto frágil para um objeto separado e estável, e consultá-lo em todos os estágios, incluindo a depuração. Esse artifício parece transferível — "requisitos fixados" semelhantes podem ser úteis em outras tarefas nas quais o agente precisa manter as condições iniciais por muito tempo: migrações, reprodução de infraestrutura, tarefas de engenharia longas.
As limitações também são claras a partir da lógica do método: a qualidade do contrato depende diretamente da qualidade da extração de requisitos e de quão adequados foram os repositórios relacionados encontrados. Se não houver código público sobre o tema, o canal de evidências trabalha às cegas. Mas pelo menos uma tese dos autores já soa convincente agora: a reprodutibilidade de um trabalho científico é uma questão de especificação, e não de velocidade de geração de código.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A confirmação de candidatos é mais cara do que a sua geração: iscas contra a busca de vulnerabilidades por LLM
O trabalho analisa a assimetria de custos na busca agentiva por defeitos: gerar variantes é barato, mas confirmá-las por meio de análise de alcançabilidade, execução e PoC exige a maior parte do orçamento; por isso, a verificação pode tornar-se um alvo de defesa por si só. O RedHerring proposto — iscas adaptadas ao repositório, com certificado selado — reduziu, com custos iguais, o número de vulnerabilidades reais encontradas em 38,7–60,4% em 33 projetos do OSS-Fuzz; mesmo após alertar o agente, a redução manteve-se em 37,2%.
9 novembro 2026
Verificação de alucinações em LLMs com uma representação SQL das fontes, sem ajuste fino
Este trabalho avalia se uma LLM consegue recorrer a uma competência simbólica básica — construir uma base de dados SQL a partir de documentos de origem — para fundamentar as respostas nas fontes sem supervisão na deteção de alucinações. No RAGTruth e no DiaHalu, este pipeline neuro-simbólico revela-se mais preciso do que a previsão direta e comparável aos métodos mais avançados, sem exigir afinação específica ao domínio.
9 novembro 2026
MathAdv: o que esconde a precisão final das provas geradas por máquina
Um conjunto de tarefas de diagnóstico em 13 áreas da matemática de nível universitário e de pós-graduação avalia sistemas de demonstração automática em Lean 4 não só pelo resultado final, mas também pelo domínio da matéria, pela qualidade do raciocínio informal e pela robustez perante reformulações das condições. A análise por componente mostra que traduzir um problema para uma forma formal continua a ser o principal obstáculo, e que o sucesso depende muito da área da matemática e da forma como o problema é formulado.
9 novembro 2026