
Memória de trabalho onde importa a magnitude, não o dígito
Manter na mente uma variável contínua — ângulo de rotação, velocidade, posição do cursor, força de pressão — e ajustá-la suavemente: este é, talvez, o teste mais honesto para a memória de trabalho. Memorizar o "sete" não é difícil, mas conservar uma magnitude sem fronteiras naturais, capaz de deslocar-se por uma fração arbitrariamente pequena, é uma tarefa de outra classe.
Com ela, as redes artificiais têm historicamente uma relação tensa. Modelos com atratores contínuos — isto é, com estados estáveis que formam não um punhado de pontos isolados, mas uma superfície suave — sustentam-se por um fio: basta um leve deslocamento dos parâmetros e o comportamento se desfaz.
Por que as arquiteturas recorrentes habituais "quantizam" o estado
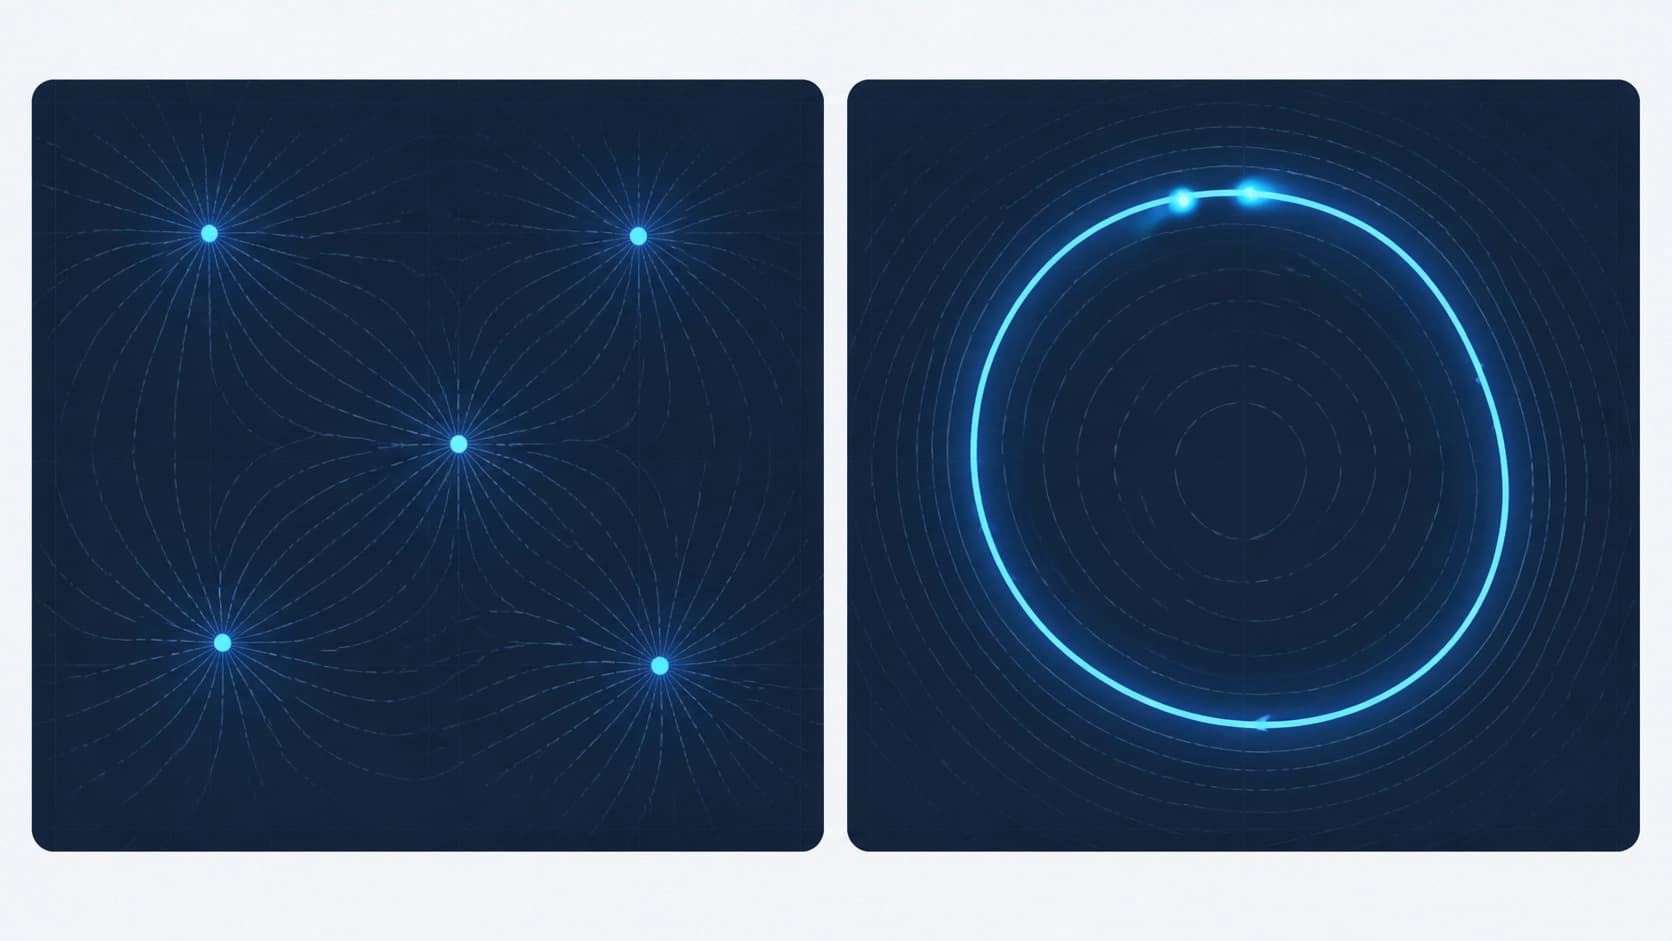
As soluções recorrentes padrão, incluindo GRU e LSTM, geralmente não aprendem variedades contínuas. Em vez de um contínuo, elas fragmentam o espaço de estados em atratores pontuais discretos: a rede como que arredonda a entrada para a "prateleira" mais próxima. Para classificação isso é conveniente; para estimativa quantitativa, é uma sentença.
Uma equipe de pesquisadores (Zhaotian Gu, Jie Su, Weiwei Wang, Chang Liu, Tianyi Qian, Dahui Wang) propôs tratar isso não complicando a arquitetura, mas com um recurso computacional específico. O trabalho foi publicado na Transactions on Machine Learning Research (agosto de 2026), e o preprint está disponível como arXiv:2608.01947 nas seções q-bio.NC, cs.AI e cs.NE.
Divisão em vez de subtração: o modelo mínimo
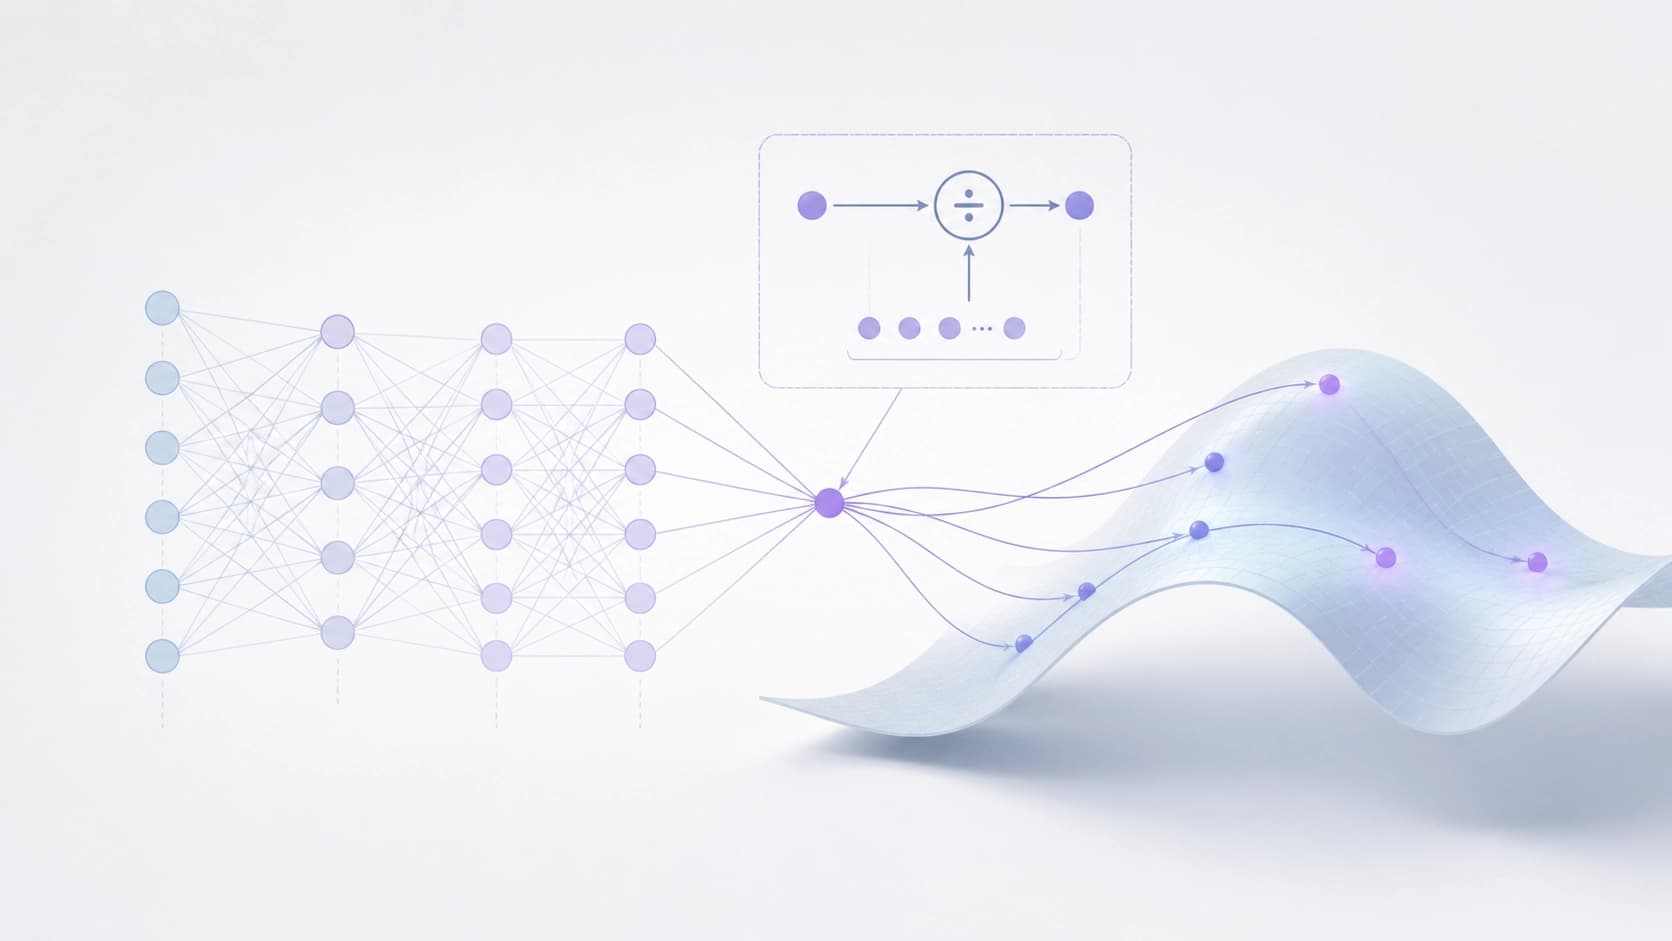
A ideia veio da neurobiologia. A divisão (normalização divisiva) é uma operação canônica observada de forma onipresente nos circuitos corticais, e os autores construíram em torno dela uma rede recorrente mínima e algebraicamente isolada — Recurrent Divisive Normalization Network, abreviada como RDNN. Dentro não há nada supérfluo: apenas a dinâmica da divisão e o que a acompanha.
Em seguida, vem o passo padrão da neurociência computacional: a análise de sistemas dinâmicos em tarefas clássicas de memória de trabalho. E aqui a restrição biofísica inesperadamente se transforma em vantagem. A rede converge para variedades lentas estáveis, e com alta precisão: as trajetórias não se dispersam, mas se acomodam sobre uma superfície estreita e se movem calmamente por ela.
O que acontece com o gradiente
Um enredo à parte do trabalho é a análise do aprendizado por retropropagação no tempo (BPTT). A divisão introduz uma escala local do gradiente que depende da atividade atual: quanto mais excitado o bloco, mais modesto é o ajuste de parâmetros que lhe cabe. O resultado é um freio embutido, que entra em ação exatamente onde é necessário.
O efeito é observável: o posto efetivo da rede se autocontrai visivelmente, e a dinâmica recorrente fica encerrada em um subespaço estreito de baixa dimensão. Ao mesmo tempo, os autores destacam a diferença em relação à fatoração explícita de baixo posto — ali, essa restrição frequentemente leva a patologias de otimização, enquanto aqui ela surge por si só, como efeito colateral da atividade.
Ablações: sem a divisão, a variedade se desfaz
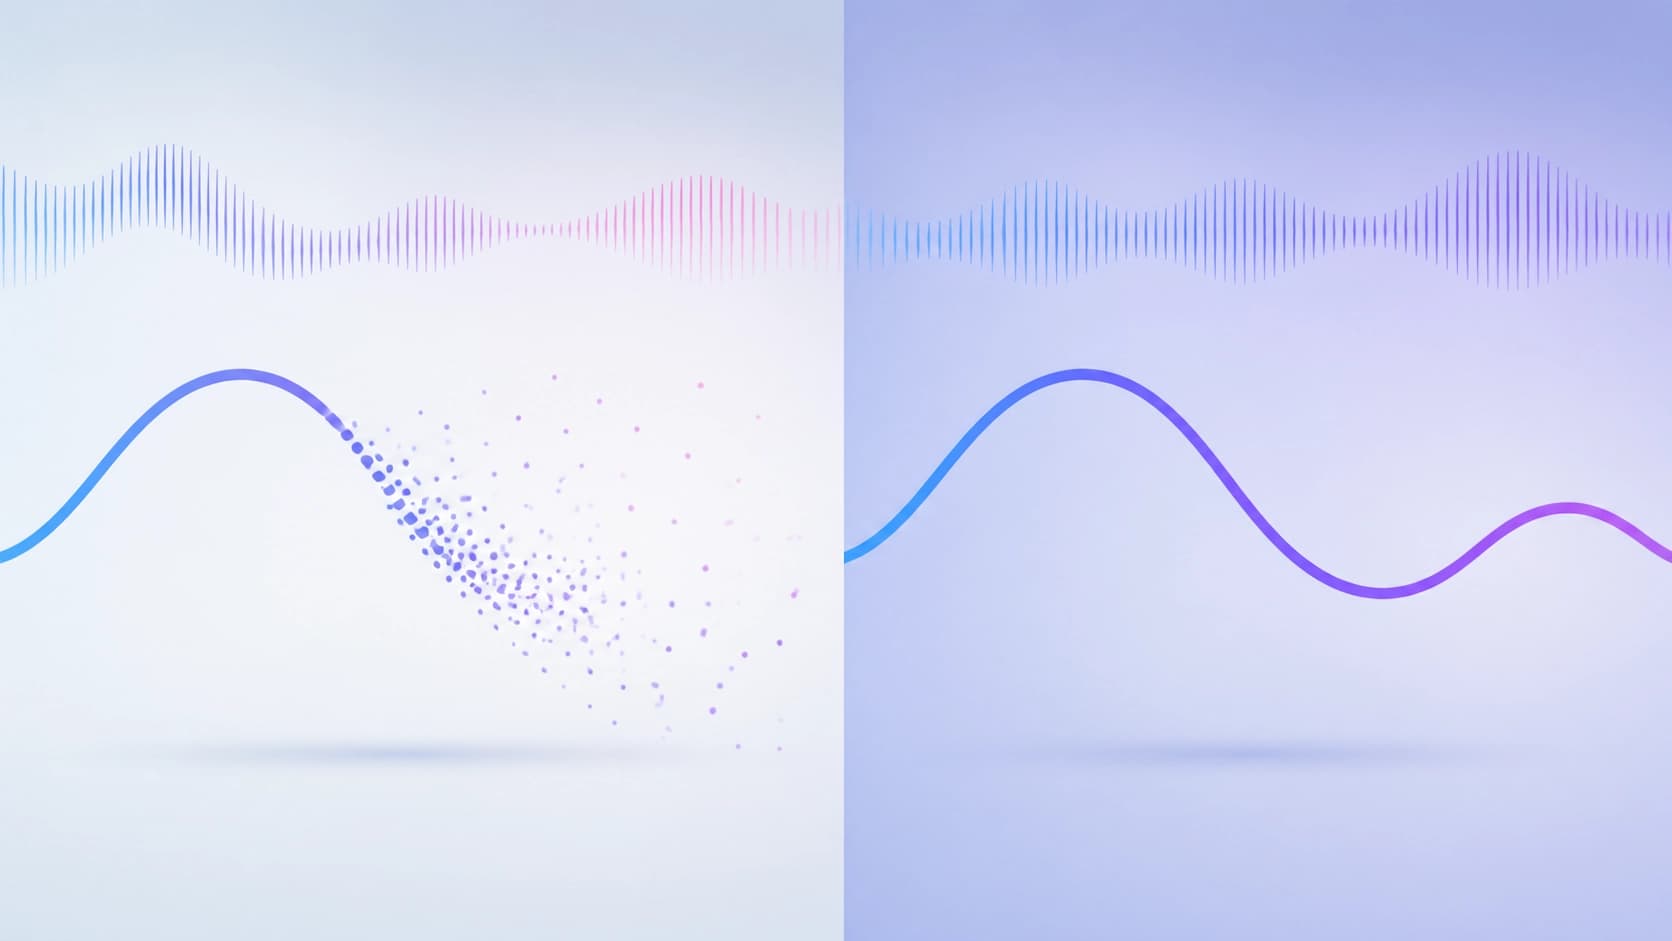
A parte mais reveladora é a comparação com a inibição subtrativa. Essa substituição consegue manter memórias estáticas: preservar um ponto fixo não é problema. Mas basta que os sinais de entrada comecem a variar no tempo, e a variedade se "estilhaça" (manifold shattering) — a continuidade desaparece exatamente onde é mais necessária.
Daí a conclusão que vale ter em mente: a divisão não é uma curiosidade biológica herdada do córtex, mas um mecanismo computacional funcional. Ela é necessária para que a rede aprenda representações contínuas de alta precisão, e não apenas uma discretização cuidadosa.
O que fazer com isso na prática
O sentido prático não está em reescrever às pressas todos os modelos recorrentes. É mais um lembrete: a normalização não diz respeito apenas à estabilidade do treinamento nem apenas à regularização. É uma forma de definir a geometria do espaço interno de estados, e a divisão tem aqui uma vantagem clara sobre a subtração.
Se a tarefa exige manter uma magnitude contínua e atualizá-la suavemente — em controle, em rastreamento, em quaisquer sistemas com "quanto" em vez de "qual de" — vale a pena olhar com atenção para esquemas com normalização multiplicativa. O custo é mínimo, e em troca a rede deixa de arredondar o que não deveria ser arredondado.


