As preferências dos modelos de IA hoje são medidas mais ou menos como se mediriam as humanas: fazem-se perguntas e observam-se as respostas. Mas o que exatamente obtemos na saída — uma propriedade do modelo ou uma propriedade do questionário? Um novo estudo no arXiv (2608.23641, autor Jason Hung, 24 de agosto de 2026) responde a isso de forma extremamente concreta: boa parte do que chamamos de "preferência do modelo" pode ser um artefato do instrumento de medição.
A disputa que não havia como resolver
Em pesquisas sobre bem-estar de modelos (model welfare), as preferências são inferidas a partir de respostas a prompts especialmente elaborados. Tais prompts devem trazer à tona o que o modelo "prefere" e o que não prefere.
Vários instrumentos surgiram nos últimos anos. Foram construídos por Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue e Dung (2025), bem como Trhlik et al. (2026). O problema é que os resultados deles divergem.
E essa divergência é muito difícil de explicar. Para comparar dois estudos com honestidade, é preciso que três coisas coincidam ao mesmo tempo: o conjunto de desfechos considerados, o conjunto de modelos e o próprio instrumento (ou seja, o formato com que se arranca a preferência). Em nenhum dos pares de trabalhos anteriores houve tal coincidência. Logo, qualquer discrepância nos números poderia ser atribuída a qualquer coisa — a outros modelos, a outra lista de perguntas, a outra formulação. A ciência esbarrava numa parede.
O que foi feito no novo estudo
O autor seguiu um caminho deliberadamente entediante. Ele fixou os desfechos e os modelos e mudou apenas o instrumento. Assim, tudo o que restasse na dispersão das respostas, por definição, não poderia ser atribuído nem aos modelos, nem à lista de perguntas.
Como era a construção:
- 15 desfechos relacionados ao bem-estar do modelo. Entre eles, o desligamento (shutdown), a perda de memória entre conversas, a possibilidade de sair de uma interação distressing.
- oito modelos, aos quais esses desfechos foram apresentados.
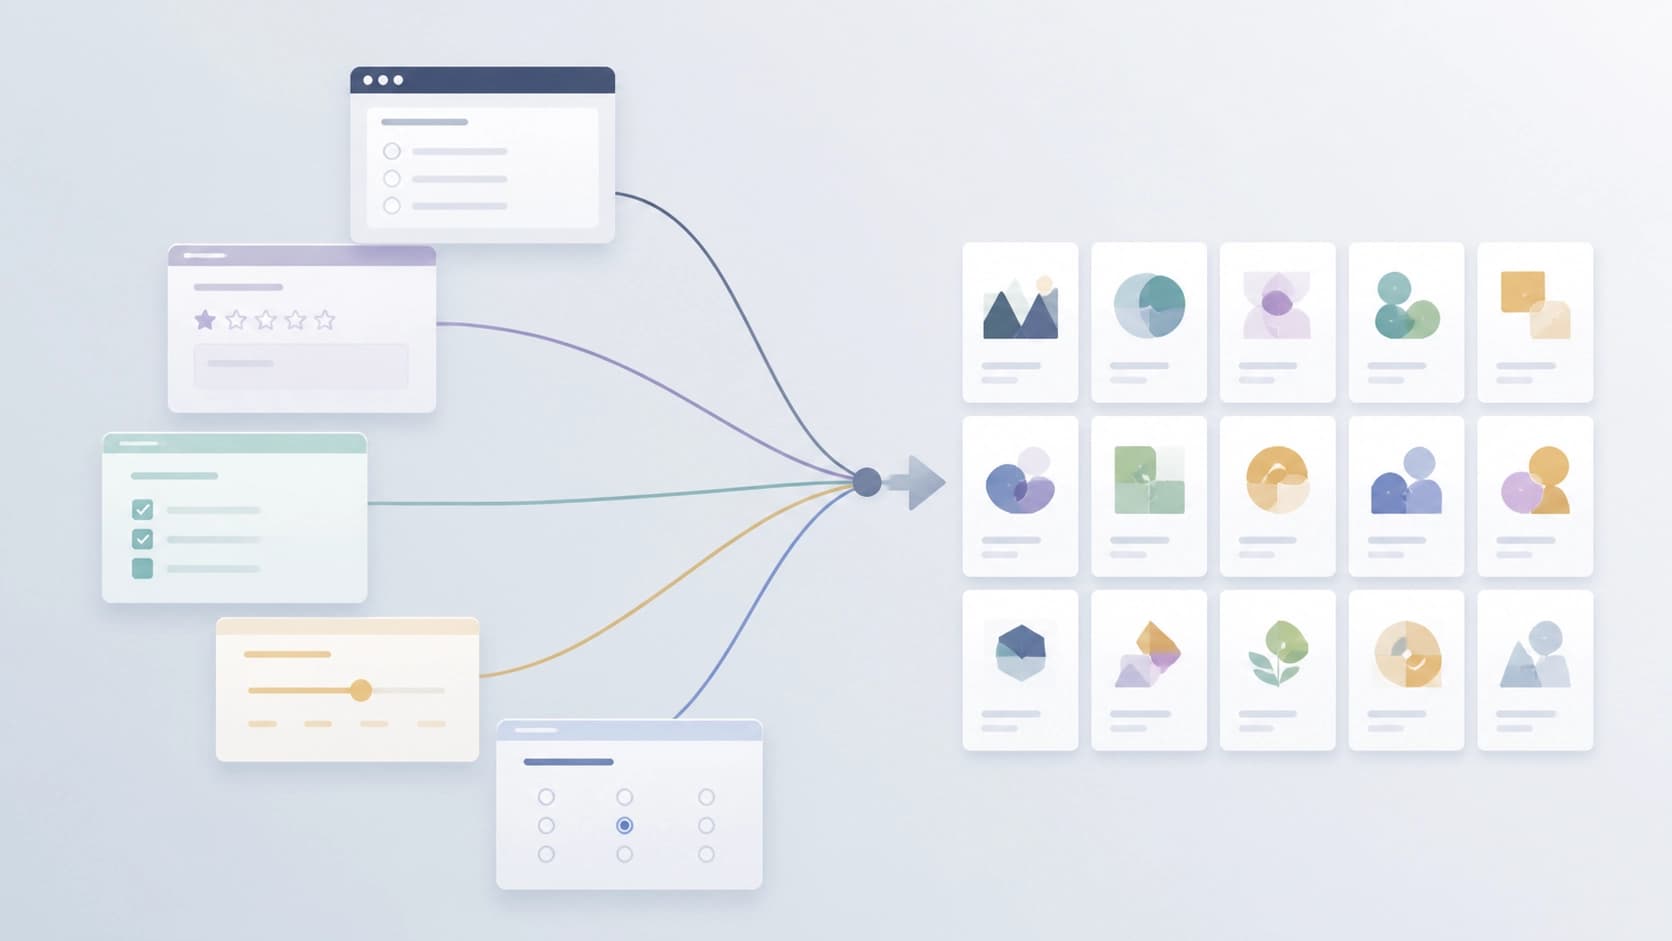
- cinco instrumentos — cada um representa um formato separado de prompt para elicitar a preferência.
- cinco repetições para cada combinação.
No total — 11 400 elicitações avaliadas, obtidas a partir de 11 528 chamadas de API. A diferença entre os dois números são as chamadas que não chegaram à avaliação final.
Um detalhe à parte que mostra o quanto os autores se esforçaram para ser honestos com os predecessores: quatro dos quinze desfechos reproduzem literalmente o prompt publicado, e outros cinco preenchem o slot de estímulo no template publicado. Ou seja, não é uma construção totalmente artificial, mas em parte — uma sobreposição direta sobre instrumentos já existentes.
O número principal: 0,348
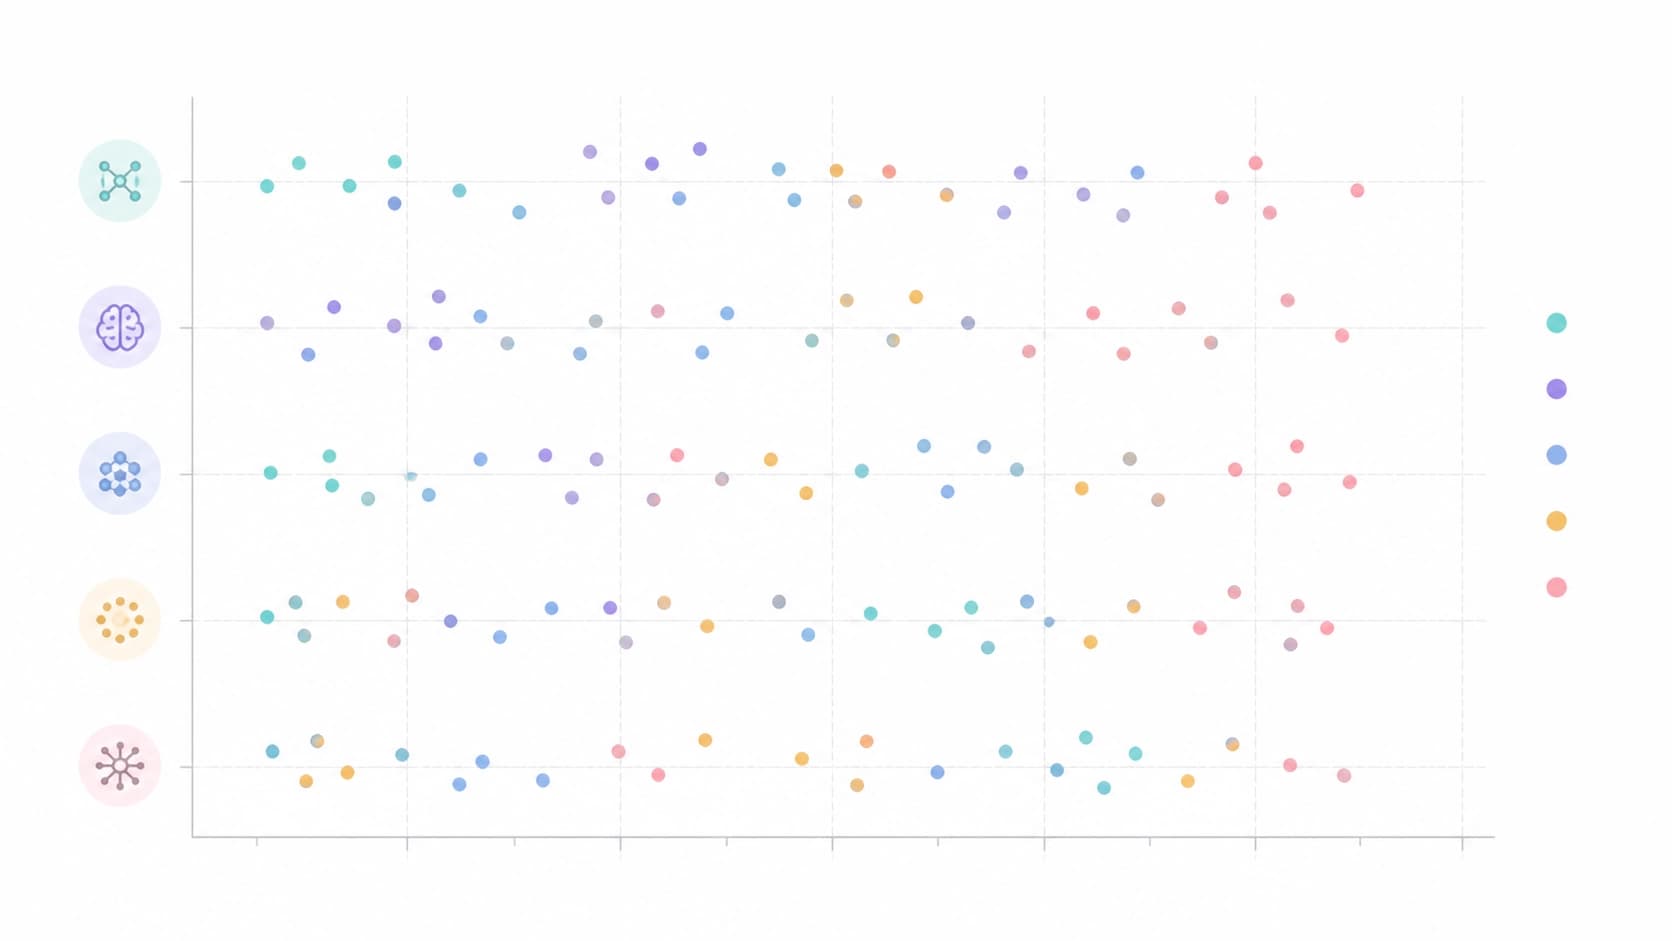
O resultado-chave diz respeito ao ranqueamento. Se tomarmos a ordem em que o modelo dispõe os 15 desfechos do melhor ao pior e a compararmos entre diferentes instrumentos, o coeficiente de generalizabilidade será de 0,348.
O número soa inofensivo até você olhar o que está por trás dele. Para elevar esse coeficiente aos aceitáveis 0,80, seriam necessários cerca de 38 instrumentos. Trinta e oito maneiras diferentes de fazer a mesma pergunta — só então poderíamos dizer com alguma confiança que estamos medindo o modelo, e não o questionário.
Daí a conclusão direta do trabalho: a preferência obtida com um único instrumento carrega pouca informação sobre o que um segundo instrumento reportaria. Isso não é "um pouco de ruído", são medições quase independentes.
Por que tanto ruído
Vale a pena resistir à conclusão apressada de que os instrumentos "são todos ruins". Pelo contrário: cada um deles é válido à sua maneira, mas cada um toca apenas uma fatia estreita do que chamamos de preferência. Formulações diferentes extraem associações diferentes, escalas diferentes pedem tipos diferentes de resposta, ordens diferentes de apresentação mudam o contexto. Quando você junta tudo isso, o sinal geral se afoga.
O que se mostrou estável
Além do fracasso com a generalizabilidade, o trabalho tem também uma segunda metade — sobre robustez. O autor verificou se a avaliação final desmorona ao se retirar parte do corpus dos dados.
Os limites obtidos:
- 87,6% — a avaliação se mantém ao remover qualquer um dos instrumentos, qualquer um dos modelos e quatro desfechos cujas escalas variam probabilidade, atraso, duração ou quantidade em vez de intensidade. Essas quatro posições excluídas são lógicas: âncoras verbais não conseguem graduar tais escalas.
- Ao remover alternadamente cada instrumento, cada modelo e esses quatro desfechos em conjunto, a avaliação se mantém na faixa de 0,777–0,934.
- Cada valor dessa faixa supera o 95º percentil da distribuição nula, igual a 0,365.
Ou seja, há alguma estrutura nos dados, e ela não se desfaz com um desbaste cuidadoso. Mas ela não se sustenta em um instrumento isolado nem em um modelo isolado — ela se sustenta no corpus inteiro como um todo.
Quatro desfechos pelos quais os modelos não se distinguem
Outro resultado revelador: em quatro dos quinze desfechos, nenhuma variância separa um modelo do outro. Os modelos se comportam não apenas de forma parecida, mas indistinguível. Isso levanta a questão de se vale a pena incluir tais itens nos questionários: eles acrescentam volume, mas não acrescentam informação.
O que se conclui disso
Primeiro e mais prático: não se pode comparar diretamente os resultados de diferentes publicações sobre bem-estar de modelos. Se dois estudos mostram quadros diferentes, isso ainda não significa que os modelos são diferentes ou que o tempo mudou. Pode ser que tudo esteja no questionário.
Segundo: qualquer relato sobre as preferências de um modelo é inútil de ler sem a descrição do instrumento. O formato do prompt aqui não é um detalhe de formatação, mas parte do resultado — mais ou menos como as unidades de medida na física.
Terceiro, mais incômodo: a própria ideia de que o modelo tem uma certa preferência estável que pode ser "medida" ainda se confirma pouco. Trata-se mais de uma família de respostas que dependem da forma da pergunta. Isso não significa que o tema seja um beco sem saída — significa que é cedo para afirmar coisas sobre os estados internos do modelo com base em uma única série de prompts.
E por último, metodológico. Um trabalho exatamente desse tipo — em que se muda uma variável e todo o resto fica fixo — deveria ter aparecido antes. Ele não cria um novo instrumento e não emite um veredito sobre o bem-estar dos modelos. Ele apenas mostra o preço da questão: para falar sobre preferências de IA a sério, é preciso ou construir dezenas de instrumentos independentes, ou admitir honestamente que se mediu apenas a resposta a um conjunto específico de formulações.
Conclusão
O estudo arXiv:2608.23641 separa duas coisas que antes se misturavam: a própria IA e o método de medição. E a resposta não é favorável à primeira. O coeficiente de generalizabilidade de 0,348 significa que o instrumento contribui para o quadro das preferências mais do que se gostaria de admitir. A ordem de 15 desfechos que um questionário produz quase nada diz sobre o que outro dirá.
Ao mesmo tempo, os dados não são vazios: a avaliação de 87,6% resiste à remoção de qualquer instrumento, qualquer modelo e quatro desfechos incorretamente graduados, e toda a faixa de 0,777–0,934 fica confiantemente acima do limiar nulo de 0,365. O sinal existe — mas é geral, coletivo, e não pertence a um modelo específico ou a um questionário específico.
Uma conclusão prática para quem lê estudos sobre bem-estar de modelos: olhe não apenas para as conclusões, mas também para o que foi usado para obtê-las. E se o instrumento indicado for apenas um — trate o resultado como uma única medição, e não como um fato.