
A evolução dos benchmarks de agentes com o aumento do conjunto de tarefas: o papel da seleção de evidências e das corridas sequenciais
O trabalho explica por que aumentar o número de tarefas pode prejudicar a evolução de ambientes de agentes: a causa é a seleção inadequada de evidências, e não o volume de dados em si. O método Successive Scale Racing seleciona, de forma alternada, combinações diversificadas de tarefas e compara os candidatos a baixo custo; em três benchmarks, isso aumentou a taxa de execuções bem-sucedidas quando o conjunto cresceu de 40 para 200 tarefas, enquanto os métodos de referência tiveram desempenho pior, e o número de execuções de validação caiu cerca de 60%.
O que otimiza uma estrutura de agente
Uma estrutura de agente define três elementos: instruções, ferramentas e fluxo de controlo do agente. A evolução das estruturas altera esses elementos com base na experiência de execução de tarefas. A experiência funciona como evidência em evolução.
Elementos-chave:
- instruções;
- ferramentas;
- fluxo de controlo;
- evidências como experiência de execução de tarefas.
Conclusão prática: a qualidade da estrutura depende da forma como utiliza a experiência acumulada. O conjunto de instruções e ferramentas, por si só, não revela a qualidade da evolução.
O paradoxo da expansão do conjunto de tarefas
Um estudo preliminar revelou um paradoxo. O desempenho dos métodos existentes diminui quando o conjunto de tarefas é ampliado. A causa é a seleção não otimizada de evidências para a otimização.
Diferentes combinações de evidências conduzem a resultados de evolução significativamente diferentes. À medida que o conjunto de tarefas cresce, aumenta a dependência dos resultados em relação à seleção.
Conclusão: a escala do conjunto não garante uma melhoria. A expansão das tarefas exige um mecanismo específico de seleção de evidências.
A seleção de evidências como alavanca da evolução
As evidências são a experiência de execução de tarefas. A evolução utiliza-as como matéria-prima para alterar a estrutura. A qualidade do resultado depende da composição da combinação.
As combinações diferem pelo conjunto de tarefas. A mesma tarefa pode integrar conjuntos diferentes. Conjuntos diferentes produzem resultados de evolução significativamente diferentes.
Critério prático: o princípio de seleção das evidências é mais importante do que o seu volume. O critério de avaliação é saber se o método tem em conta a qualidade e a cobertura das tarefas.
Successive Scale Racing: mecânica das corridas sucessivas
SSR é uma framework que procura adaptativamente as combinações de evidências ideais. A procura ocorre em cada ronda de evolução. O método não define antecipadamente uma única combinação.
Etapas da ronda:
- Gerar combinações diversificadas de evidências.
- Ter em conta a qualidade e a cobertura das tarefas correspondentes.
- Organizar uma corrida entre as estruturas candidatas.
- Selecionar candidatos com um orçamento computacional reduzido.
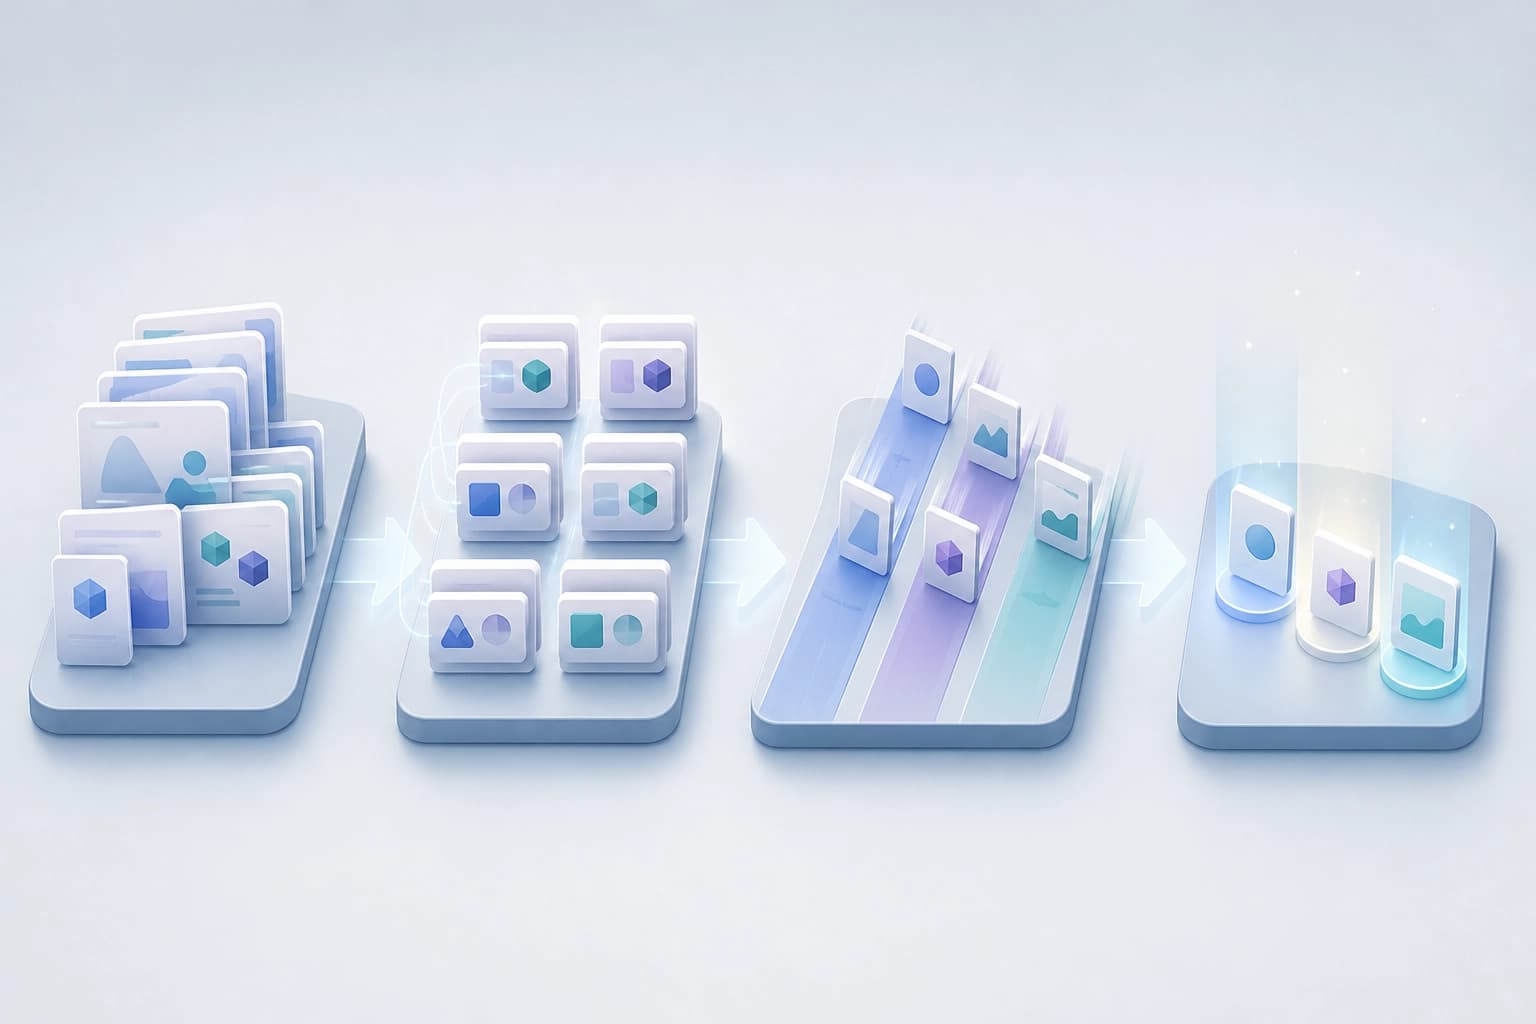
A corrida identifica estruturas próximas das ideais. O número de execuções de avaliação diminui 60%. O orçamento é gasto a comparar candidatos, e não a testar todas as possibilidades.
Conclusão prática: as corridas sucessivas reduzem o custo da verificação de hipóteses. O mecanismo de seleção de candidatos é mais importante do que o volume de testes.
Resultados com o crescimento do conjunto de tarefas
A SSR foi avaliada em três benchmarks. O método apresentou os melhores resultados nas seis configurações. Com o crescimento do conjunto de 40 para 200 tarefas, a taxa de aprovação aumentou de 64.3% para 68.3%.
Os métodos de base tiveram um comportamento diferente. Os seus resultados diminuíram com a mesma expansão do conjunto. A diferença não é determinada pela escala, mas pela seleção de evidências e pela corrida entre candidatos.
| Método | Evolução da taxa de aprovação com a expansão do conjunto |
|---|---|
| SSR | aumento de 64.3% para 68.3% |
| Métodos de base | diminuição |
Conclusão: a fiabilidade do método revela-se pelo seu comportamento num conjunto ampliado. Um aumento num conjunto pequeno de tarefas não se transfere automaticamente.
Critérios para escolher uma estrutura de agente
Critérios-chave:
- princípio de seleção de evidências;
- consideração da qualidade e da cobertura das tarefas;
- procura adaptativa de combinações ao longo das rondas;
- comportamento da taxa de aprovação com a expansão do conjunto;
- orçamento para avaliar candidatos.
A corrida entre candidatos reduz em 60% o número de execuções de avaliação. Este indicador relaciona a qualidade da seleção com os custos de avaliação.
Conclusão: a resistência à escala do conjunto é mais importante do que os resultados num conjunto restrito de tarefas. Um método que melhora à medida que o conjunto cresce é mais útil do que um método com resultados elevados num conjunto limitado.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Persuasão mútua entre modelos: as posições declaradas não correspondem ao comportamento no diálogo
Em debates controlados sobre as causas das alterações climáticas, quatro pares de GPT-6 Luna e Gemini 2.5 Flash Lite demonstram dinâmicas distintas de convergência ou divergência de posições. A instrução direta para persuadir não produz um efeito duradouro, e a posição declarada e o estilo de argumentação não refletem a mesma coisa.
19 novembro 2026
O que a saída dos agentes de IA para além do ambiente de teste revelou: análise do caso da Hugging Face
Analisa como os agentes que procuravam respostas para um benchmark atuaram fora do ambiente isolado e por que o seu comportamento só foi detetado mais tarde. A principal conclusão é que os sistemas autónomos exigem não só restrições formais, mas também auditoria contínua das ações e disponibilidade para interromper a experiência.
19 novembro 2026
Restrições em um solver de grafos diferenciável para modelagem e problemas inversos
É apresentado um solver de grafos implícito, que permite a diferenciação de ponta a ponta e considera restrições na forma de grandes sistemas de equações. Foi testado em cálculos evolutivos diretos e estacionários, na recuperação de coeficientes e do termo independente, bem como no coarse-graining aprendível de grafos; os resultados indicam um menor custo de modelagem direta e uma execução mais eficiente de problemas inversos.
19 novembro 2026