
A ciência molecular há muito é considerada uma das áreas mais promissoras — e mais complexas — para a IA. É justamente a ela que se dedica o preprint arXiv:2608.23104 «Molecular LLM Agents: From Architectural Design to Scientific Autonomy»: 25 páginas, categorias cs.CL e cs.AI, versão v1 de 24 de agosto de 2026 e versão v2 revisada de 25 de agosto. O grupo de autores é formado por Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei e Qing Li. O trabalho é interessante não por mais um recorde em benchmark, mas pela tentativa de organizar os termos: o que afinal deve ser considerado um agente molecular, de quais nós ele é montado e quão independentemente ele pode agir.
Em que um agente molecular difere de um «comum»
Assistentes conversacionais e agentes de código vivem no mundo do texto, dos repositórios e das páginas web. As ferramentas com que operam quase sempre recebem e devolvem algo que pode ser lido com os olhos. Com a química esse truque não funciona: uma molécula não é um parágrafo.
Um agente de domínio precisa lidar com vários tipos de dados incompatíveis ao mesmo tempo:
- notações simbólicas como SMILES — strings compactas em que um único caractere errado transforma um candidato a fármaco em outra substância;
- grafos moleculares, em que importam não só os átomos, mas também a ordem das ligações, as cargas, a estereoquímica;
- conformações tridimensionais — porque as propriedades da molécula são determinadas pela sua forma, e não apenas pela fórmula;
- espectros e resultados de simulações — longas séries numéricas das quais é preciso extrair sentido;
- medições de laboratório «úmido», ou seja, dados de experimentos reais com a substância, e não com um arquivo.
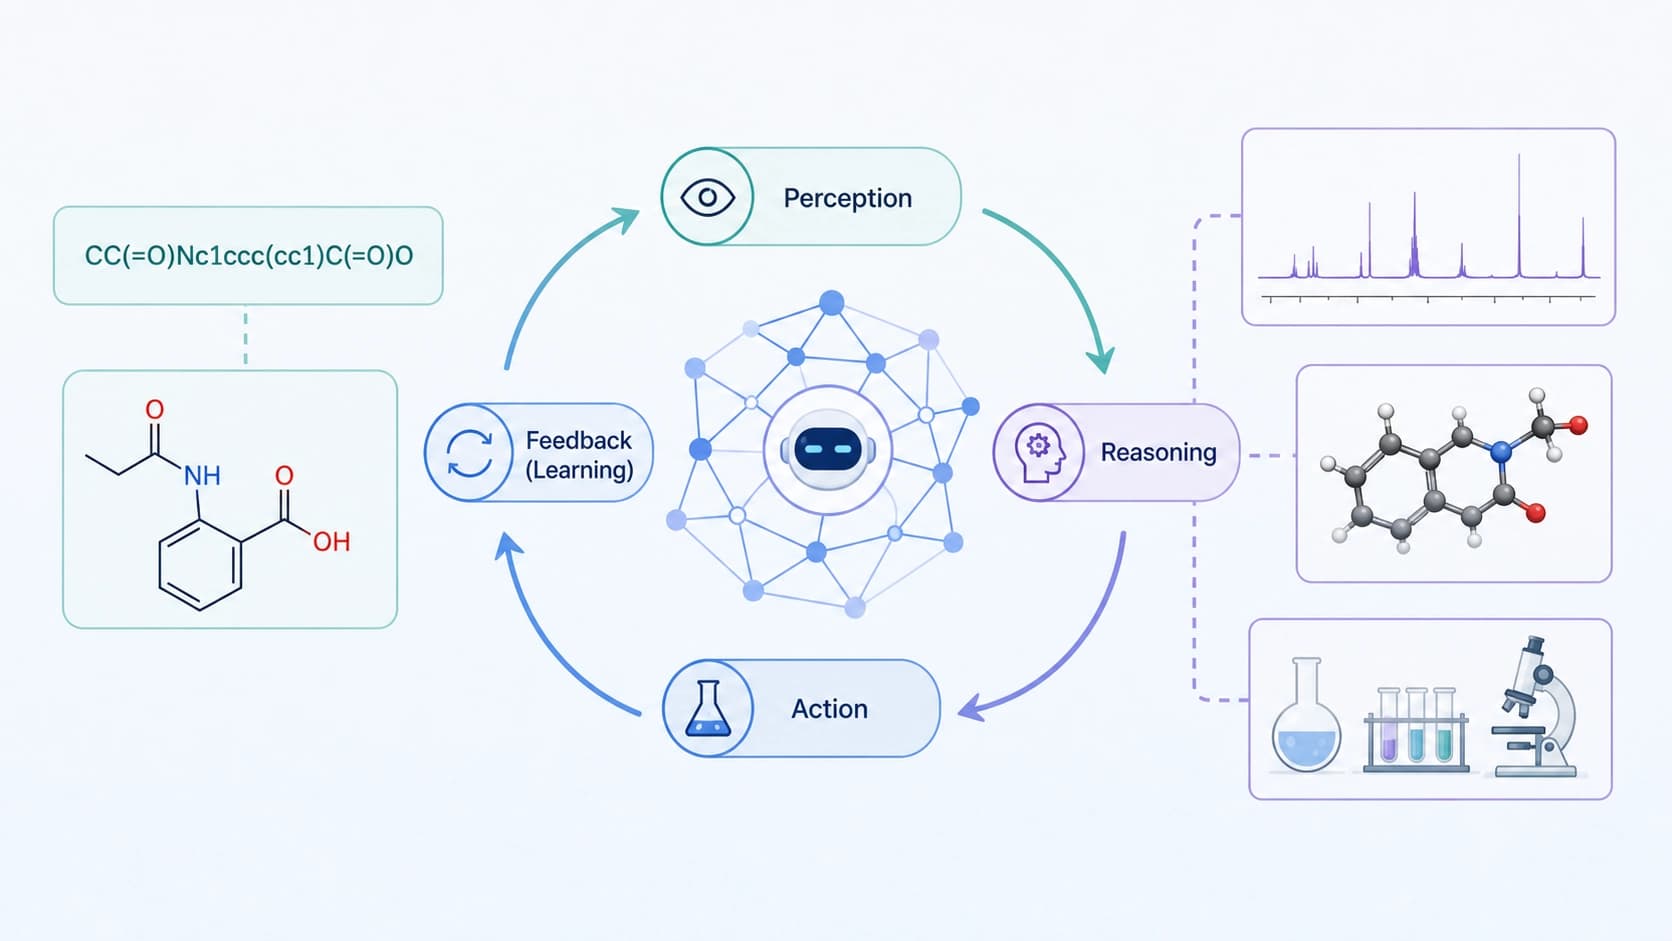
Daí vem a ideia central dos autores: as capacidades de um agente assim não se compõem de um único modelo bem-sucedido, mas de vários pilares ao mesmo tempo. É preciso percepção quimicamente correta dos objetos moleculares, um framework agêntico com um modelo de linguagem no centro, ferramentas ligadas a um domínio específico, além de um canal de feedback — computacional ou experimental. Sobre tudo isso se sobrepõe a capacidade de planejar e de acionar a ferramenta certa no momento certo.
Um olhar arquitetural: de que se monta um agente molecular
A primeira das duas perspectivas do artigo é a de engenharia. Os autores decompõem a construção em quatro camadas e propõem olhar para qualquer projeto existente exatamente assim.
Percepção: a molécula como objeto, não como parágrafo
Os modelos de linguagem são treinados em texto, por isso a princípio enxergam uma string SMILES como um conjunto de tokens e facilmente «alucinam» valências inexistentes. Aqui ajuda a ligação com modelos de domínio: por exemplo, o AlphaFold mostra como uma arquitetura especializada resolve uma tarefa molecular restrita com mais precisão do que uma universal. Para o agente isso significa uma coisa simples: antes de raciocinar, ele precisa saber validar — verificar se a molécula existe de fato, se o seu grafo bate com a fórmula, se a estereoquímica não se perdeu na conversão entre formatos.
Framework, toolboxes e treinamento
A segunda e a terceira camadas são o «cérebro» e as «mãos». O modelo de linguagem planeja e decide qual cálculo executar; a toolbox de domínio lhe dá docking, cálculo químico-quântico, busca em bases de dados, previsão de propriedades. Um bom exemplo dessa abordagem é o agente ChemCrow: ali o valor é criado não pelo modelo em si, mas pelas ferramentas cuidadosamente descritas que ele aciona.
A quarta camada é o treinamento e a otimização. O agente pode ser ajustado com base em trajetórias de soluções bem-sucedidas, ou simplesmente é possível melhorar a descrição das ferramentas e a estratégia de escolha delas. O segundo caminho é mais barato, e os autores deixam claro: metade dos fracassos nessa área não é sobre um modelo fraco, mas sobre um loop de feedback mal projetado.
A escada da autonomia científica: L1–L4
A segunda perspectiva do artigo é justamente a «escada da autonomia», emprestada da lógica dos níveis em sistemas de engenharia. Ela serve para não discutir de forma abstrata se «o agente é inteligente», mas para entender quantas decisões ele realmente assume.
L1 — assistente com cenário fixo
Aqui a pessoa define a sequência de passos, e o modelo executa operações isoladas: converter uma estrutura, calcular descritores, propor variantes. Quase não há autonomia, mas a previsibilidade é máxima.
L2 — agente computacional adaptativo
O agente decide sozinho qual ferramenta acionar e em que ordem, replaneja em caso de erro, opera em um circuito totalmente digital. Esse é o mainstream atual: o risco se limita a um cálculo estragado, e não a uma amostra estragada.
L3 — agente que leva em conta resultados de experimentos reais
O nível mais interessante e mais arriscado. O agente não apenas planeja, mas também recebe feedback do laboratório físico — espectros, cromatogramas, dados de síntese — e corrige o plano com base neles. Existem exemplos desse tipo de sistema: o Coscientist demonstrava planejamento de sínteses com o auxílio de automação laboratorial. Mas é justamente aqui que o custo do erro deixa de ser abstrato: um passo errado consome reagentes, tempo de equipamento e, no pior caso, a segurança das pessoas.
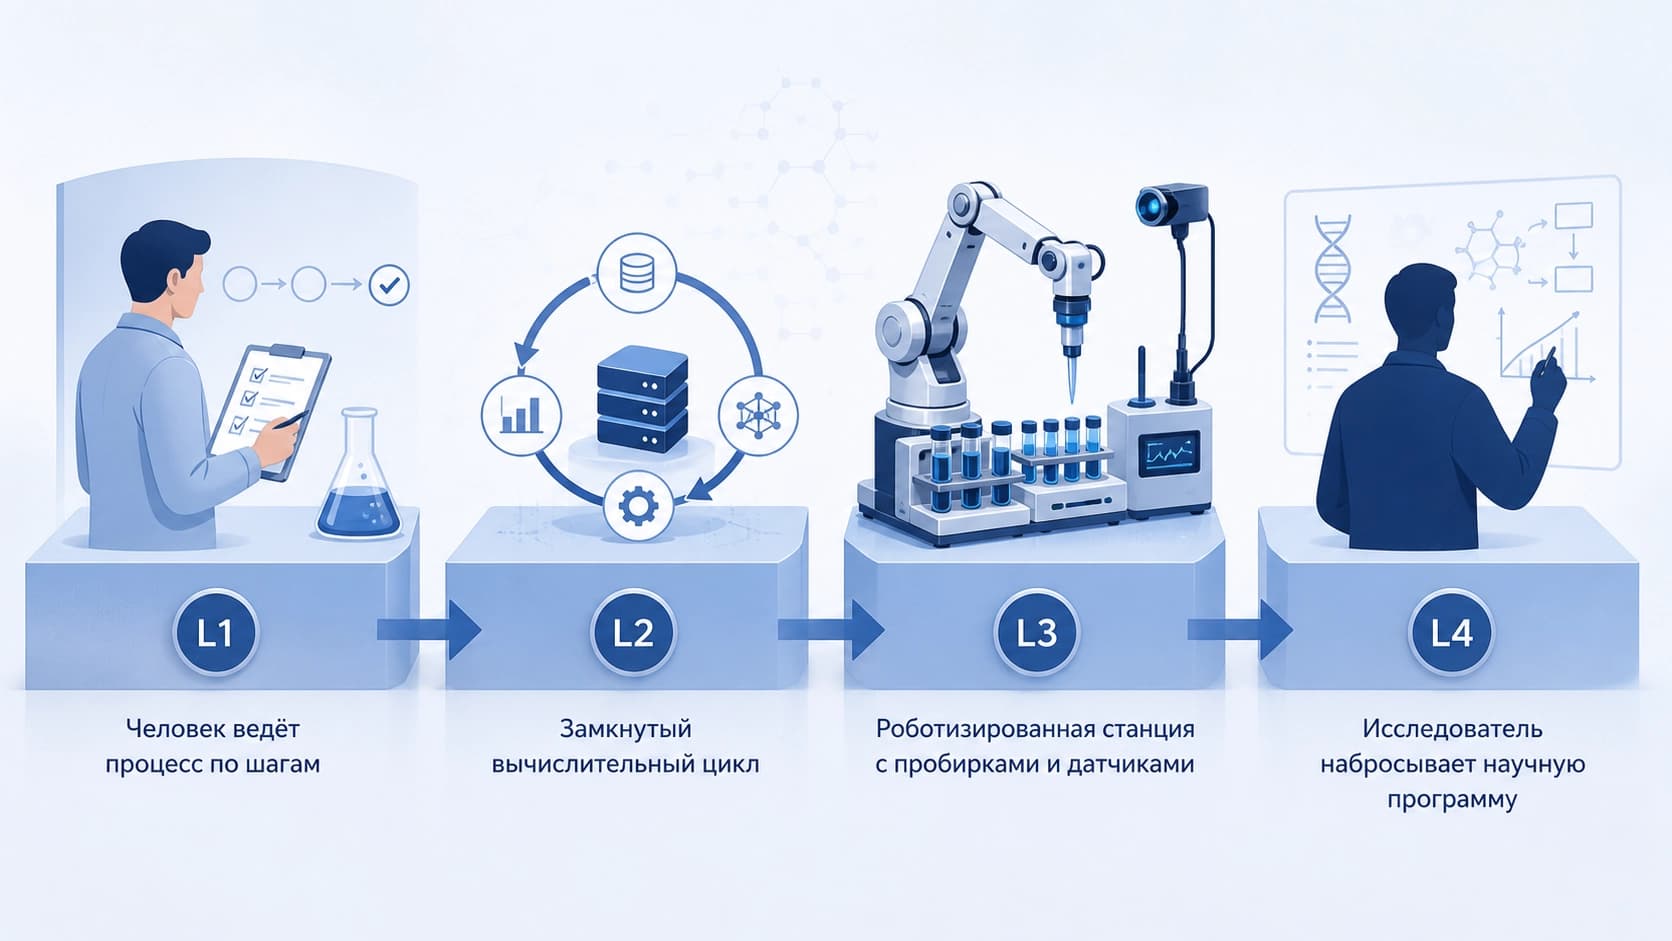
L4 — agente que formula a agenda científica
O degrau superior é quando o sistema escolhe por conta própria quais hipóteses testar, quais direções considerar prioritárias e onde buscar lacunas na literatura. Por enquanto isso é mais uma referência do que uma descrição de soluções funcionais. Mas é justamente ela que aponta a direção: a diferença entre «executor rápido» e «coautor que propõe» é fundamental, e vale a pena fixá-la em palavras, e não na intuição.
Para que serve essa estrutura
O proveito prático das duas perspectivas está na possibilidade de comparar o incomparável. Se dois agentes se dizem «autônomos», mas um gira em um simulador e o outro controla um robô sintetizador, são sistemas de classes de responsabilidade diferentes.
Os autores propõem usar o framework para três tarefas:
- Diagnóstico. Ao decompor o agente em camadas, fica visível onde está a sua deficiência: na percepção das moléculas, nas ferramentas ou no planejamento.
- Avaliação de riscos. Quanto mais alto o degrau, mais graves as consequências de uma falha — e mais importantes as verificações antes da ação, e não depois.
- Projeto. Entender qual nível de autonomia é realmente necessário para a tarefa salva da tentação de construir um L4 onde um L2 cuidadoso bastaria.
Limitações e o que permanece em aberto
Uma ressalva honesta: a escada é um modelo conceitual, e não uma escala medida. Ela ajuda a pensar, mas não substitui a validação, a certificação e a reprodutibilidade dos resultados. Além disso, a química tolera mal o «quase certo»: no texto, um erro de digitação é chato; em uma fórmula estrutural, já é outra substância.
Uma questão em aberto à parte são os dados. O feedback de um laboratório real é caro e raro, e sem ele o agente L3 permanece teoria. A segunda questão é a interpretabilidade: o químico precisa entender por que o sistema propôs justamente essa rota de síntese, caso contrário não haverá confiança.
Resumindo o essencial
Agentes moleculares baseados em LLM não são apenas «química mais chatbot». É uma classe separada de sistemas, em que o modelo de linguagem atua como despachante entre grafos, espectros, pacotes de cálculo e equipamentos de laboratório. O trabalho arXiv:2608.23104 é útil sobretudo pelo vocabulário: quatro camadas arquiteturais e quatro degraus de autonomia oferecem uma linguagem comum para falar sobre o que esses agentes já sabem fazer, do que carecem e onde passa a fronteira entre uma aceleração útil da rotina e uma decisão que é melhor deixar para uma pessoa.


