
LLMs multimodais multiagentes em matemática: como verificar o processo de resolução e a robustez a distorções
É apresentado o MAMath-Bench — um conjunto de 1003 problemas de 11 áreas da matemática, com materiais textuais, gráficos e de áudio; além da resposta final, regista etapas de verificação e a reação do sistema a alterações adversariais no raciocínio. Os resultados mostram que a cooperação entre vários LLMs não aumenta necessariamente a precisão, pode levar a justificações mais redundantes e que perturbações estruturais sutis continuam a ser uma fonte importante de vulnerabilidade.
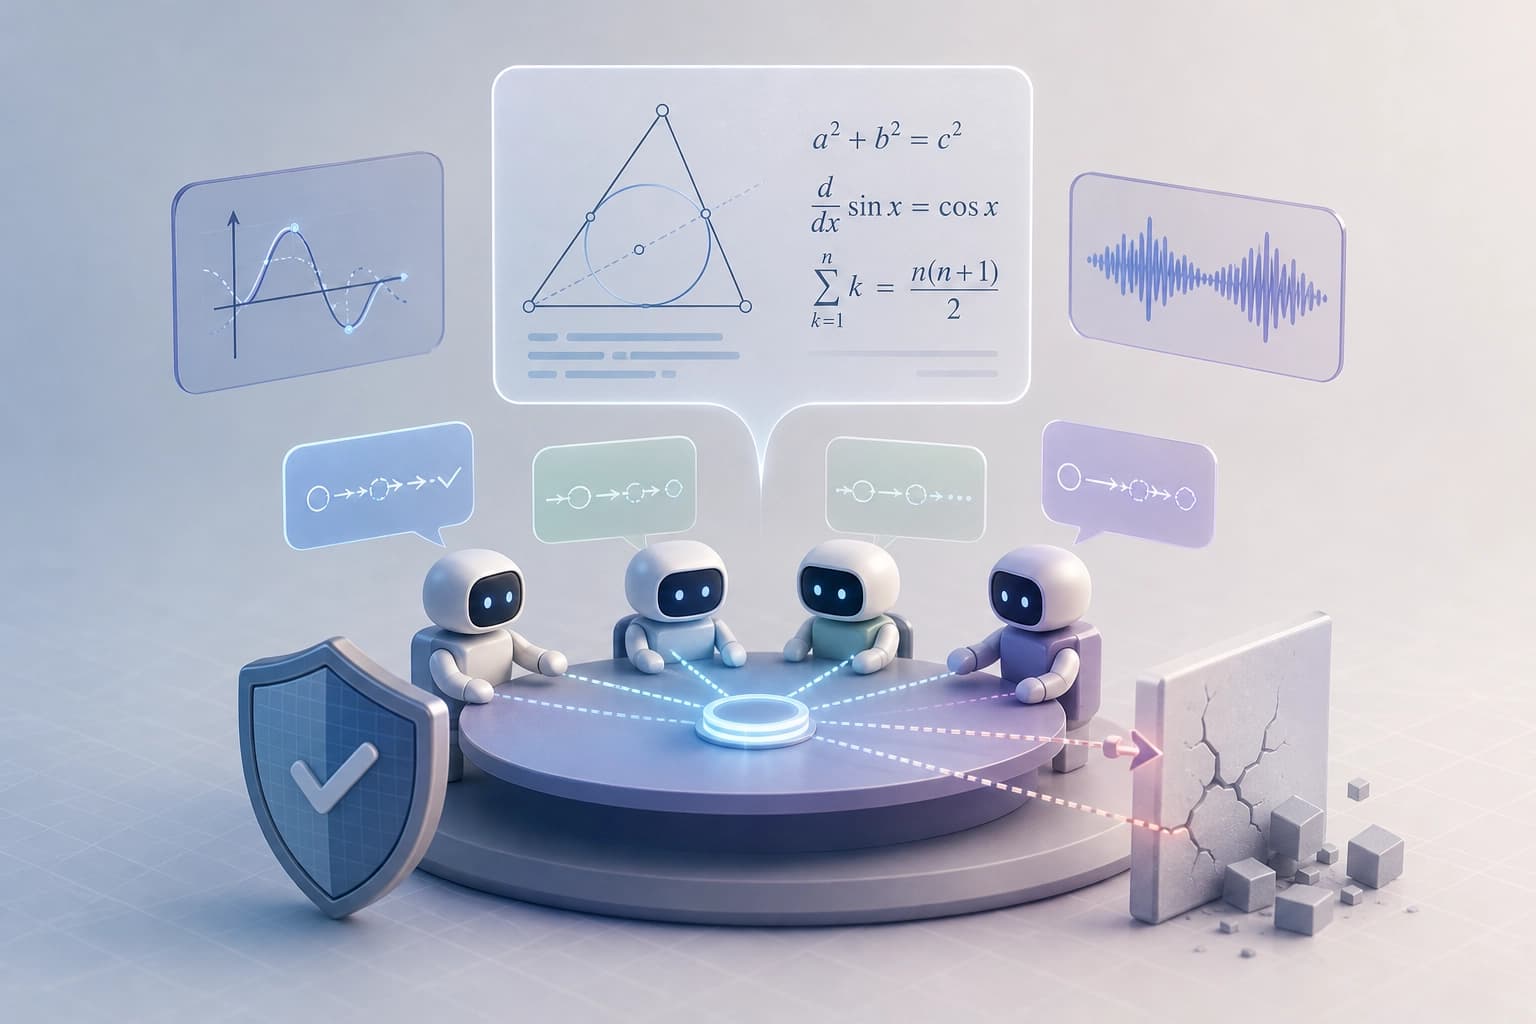
O que o benchmark avalia
MAMath-Bench é um benchmark para avaliar o raciocínio matemático multimodal de sistemas multiagente. Inclui 1 003 tarefas de 11 categorias matemáticas. As tarefas abrangem vários níveis de dificuldade e três modalidades: texto, imagens e áudio.
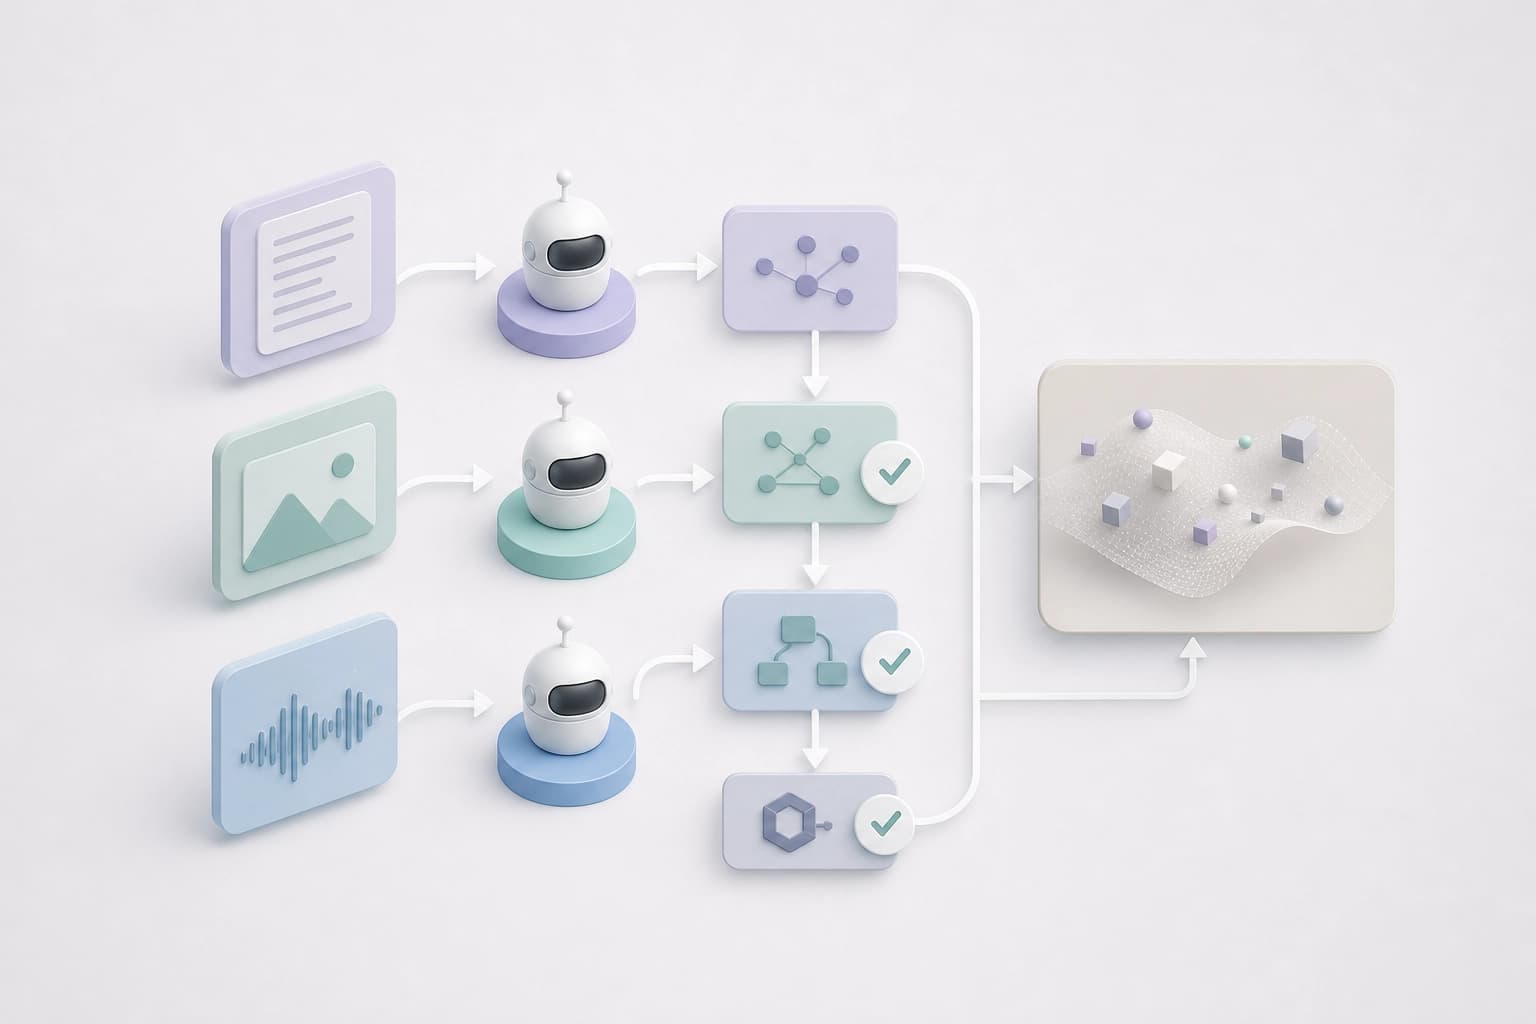
O benchmark contém anotações detalhadas dos pontos de controlo. A avaliação é feita em três dimensões:
- correção da solução da tarefa;
- fiabilidade do processo de raciocínio;
- robustez a perturbações adversariais da cadeia de raciocínio.
Critério prático: escolher uma avaliação que distinga a correção da resposta, a fiabilidade do processo e a robustez a perturbações. A resposta final não é suficiente para esta verificação.
Verificação do processo de resolução
As anotações dos pontos de controlo servem de referência para verificar os passos intermédios. A avaliação da fiabilidade do processo de raciocínio é separada da correção da resposta final. Isto permite comparar sistemas não só pelo resultado.
O que verificar no processo de resolução:
- a presença dos pontos de controlo assinalados nas anotações;
- a correspondência entre os passos intermédios e esses pontos;
- a fiabilidade do processo de raciocínio como dimensão autónoma.
Critério de verificação: registar exatamente em que ponto a solução se desvia dos pontos de controlo. A resposta final, por si só, não mostra a qualidade do processo de resolução.
Multiagente: precisão, cobertura e redundância
A avaliação mostra três efeitos distintos da colaboração entre vários agentes. A precisão da resposta final nem sempre aumenta em comparação com LLMs individuais de alto desempenho. A cobertura do raciocínio intermédio pode melhorar substancialmente. O aumento da cobertura pode ser acompanhado por um aumento da redundância do raciocínio.
| O que comparar | O que mostra a avaliação | Conclusão prática |
|---|---|---|
| Precisão da resposta final | A colaboração entre vários agentes nem sempre aumenta a precisão em comparação com LLMs individuais de alto desempenho | Não considerar a abordagem multiagente uma garantia de resposta correta |
| Cobertura do raciocínio intermédio | A colaboração pode melhorar substancialmente a cobertura | Comparar o ganho de cobertura com as outras dimensões |
| Redundância do raciocínio | O aumento da cobertura pode ser acompanhado por um aumento da redundância | Ter em conta o aumento da redundância ao avaliar a cobertura |
Critério de seleção: não considerar a abordagem multiagente uma garantia de precisão. Compará-la com um LLM individual de alto desempenho quanto à resposta final, à cobertura e à redundância.
Robustez a distorções adversariais
A avaliação inclui a robustez a perturbações adversariais da cadeia de raciocínio. Os sistemas atuais continuam vulneráveis a erros de raciocínio adversariais, sobretudo aos associados a perturbações estruturais subtis.
O que verificar:
- a reação do sistema a perturbações adversariais da cadeia de raciocínio;
- erros de raciocínio perante perturbações estruturais subtis;
- a manutenção da fiabilidade do processo, e não apenas da resposta final.
Critério de robustez: testar o sistema com perturbações adversariais da cadeia de raciocínio. A robustez a estas perturbações faz parte da avaliação, a par da correção da resposta.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Tarefas verificáveis e ajuste fino em trajetórias longas: como a Navalia reforça agentes cooperativos de LLM
O trabalho descreve um framework que, com base em relatórios financeiros empresariais, constrói cadeias computacionais com evidências rastreáveis, valida-as de forma independente e, em seguida, aplica-as em SFT e RL. Com base no Qwen3.6-35B-A3B, esse pipeline apresenta ganhos em cinco benchmarks e, segundo os autores, melhora a associação de evidências, o uso de ferramentas e a execução de tarefas longas, incluindo cenários de escritório.
18 novembro 2026
IA física: limites do conceito, ferramentas e desafios
A monografia de 388 páginas reúne num único enquadramento as definições de IA física, as diferenças em relação a áreas afins e os principais métodos — da perceção e simulação ao controlo e aos sistemas multiagente coordenados. Permite obter um mapa dos desafios de investigação e das limitações que dificultam a transição de soluções especializadas para sistemas com ampla capacidade de generalização.
17 novembro 2026
Agentes de LLM em produção: taxonomia, arquitetura e limitações de implementação
O artigo sistematiza pesquisas sobre a aplicação de grandes modelos de linguagem em agentes industriais: identifica obstáculos, níveis de capacidade e uma arquitetura de quatro camadas. Permite compreender quais cenários do ciclo de vida já estão a ser estudados e onde persistem lacunas para um planeamento autónomo fiável.
17 novembro 2026