
Tarefas verificáveis e ajuste fino em trajetórias longas: como a Navalia reforça agentes cooperativos de LLM
O trabalho descreve um framework que, com base em relatórios financeiros empresariais, constrói cadeias computacionais com evidências rastreáveis, valida-as de forma independente e, em seguida, aplica-as em SFT e RL. Com base no Qwen3.6-35B-A3B, esse pipeline apresenta ganhos em cinco benchmarks e, segundo os autores, melhora a associação de evidências, o uso de ferramentas e a execução de tarefas longas, incluindo cenários de escritório.
Problema que o Navalia resolve
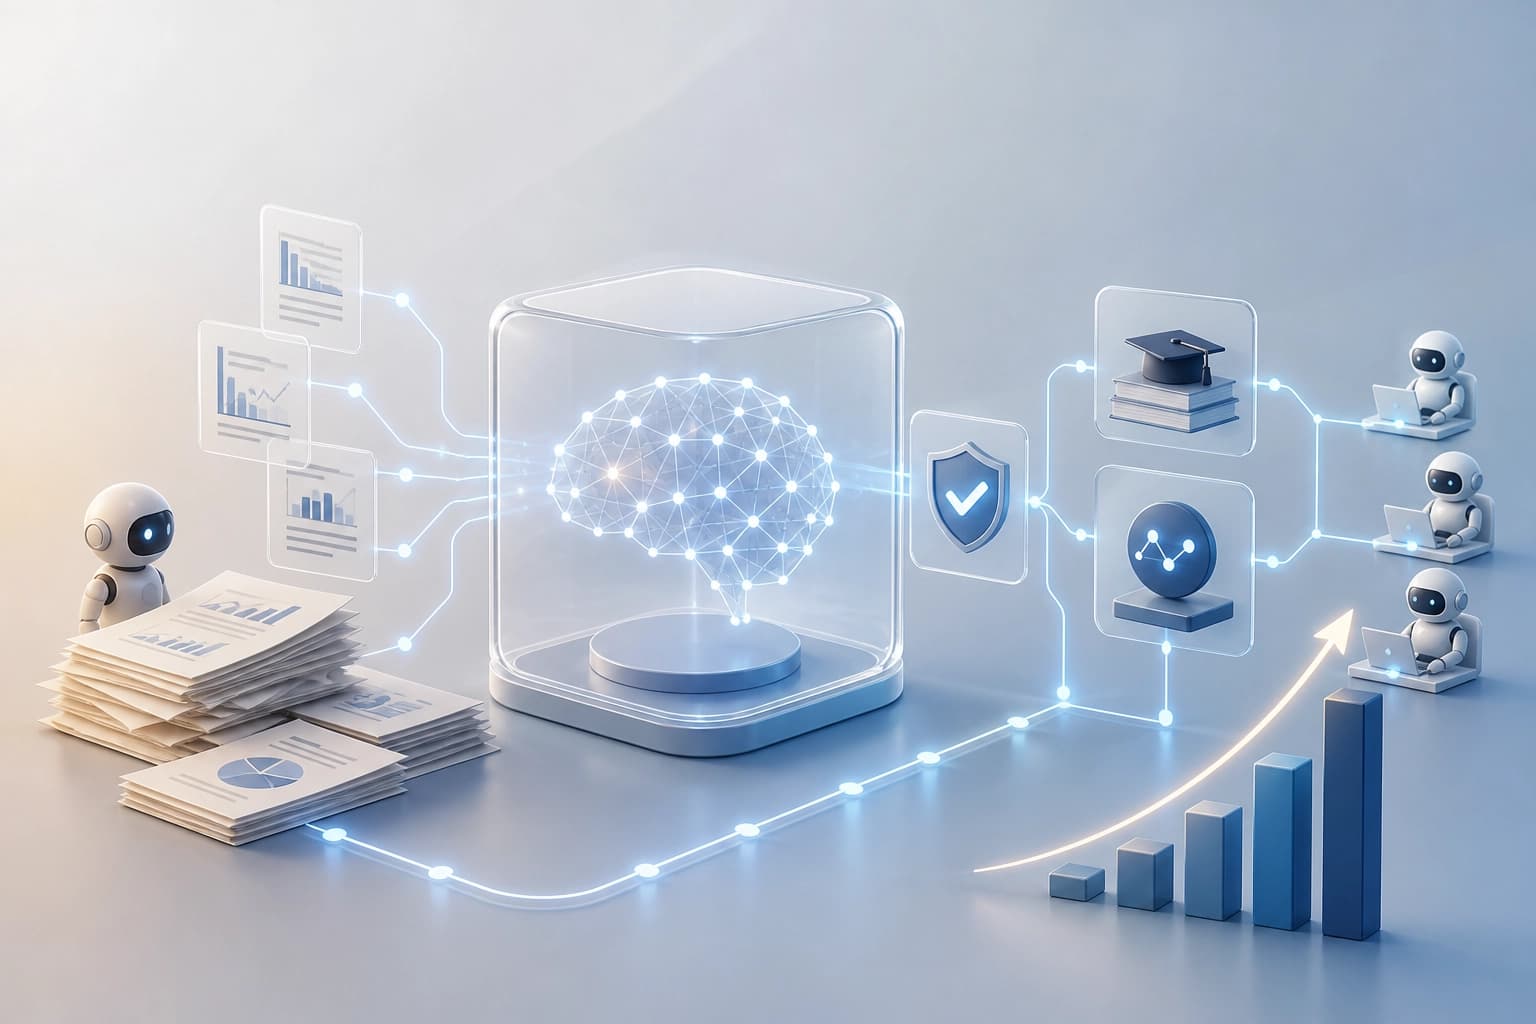
Navalia é um framework para Cowork Agents. Combina a síntese de tarefas verificáveis com o pós-treino em horizontes longos. Para a análise financeira, o framework utiliza relatórios financeiros empresariais.
O Navalia seleciona semanticamente evidências de suporte a partir de conjuntos completos de factos. Em seguida, constrói cadeias de cálculo executáveis. Assim, o framework cria tarefas analíticas com evidências rastreáveis e dependências factuais entre os dados de cada etapa.
Critério prático: uma tarefa é adequada para a síntese verificável se tiver evidências rastreáveis e dependências entre etapas.
Verificação de evidências e respostas
A consistência das evidências e a correção das respostas são verificadas de forma independente por um LLM e por verificações programáticas. São dois circuitos de controlo distintos. O primeiro avalia o conteúdo semântico; o segundo, a correção formal.
Critério prático: uma tarefa verificável precisa tanto da verificação por LLM como de verificações programáticas.
Pós-treino em trajetórias longas
As tarefas verificadas fornecem material para recolher trajetórias. O Navalia aplica fine-tuning supervisionado com arranque a frio e aprendizagem por reforço. Ambas as etapas melhoram a execução de tarefas em horizontes longos.
O framework, inicializado com o Qwen3.6-35B-A3B, apresenta ganhos consistentes em relação ao modelo de base. Os ganhos são observados nos cinco benchmarks. Os autores referem que o Navalia melhora a integração de evidências, o uso de ferramentas e a execução de tarefas em horizontes longos.
Critério prático: o pós-treino faz sentido quando a tarefa exige uma longa sequência de ações e o uso de ferramentas.
Benchmarks e transferência de resultados
A avaliação do Navalia é realizada em cinco benchmarks: OfficeQA Pro, FinSearchComp, Finance Agent Benchmark, APEX-Agents-AA e Workspace-Bench-Lite. Nos cinco, o framework apresenta ganhos consistentes em relação ao modelo de base.
Os autores referem que os resultados se transferem para cenários Cowork mais abrangentes, incluindo tarefas gerais de escritório. Critério prático: avaliar a transferência de competências para além da análise financeira. As tarefas gerais de escritório são um indicador de maior aplicabilidade.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
IA física: limites do conceito, ferramentas e desafios
A monografia de 388 páginas reúne num único enquadramento as definições de IA física, as diferenças em relação a áreas afins e os principais métodos — da perceção e simulação ao controlo e aos sistemas multiagente coordenados. Permite obter um mapa dos desafios de investigação e das limitações que dificultam a transição de soluções especializadas para sistemas com ampla capacidade de generalização.
17 novembro 2026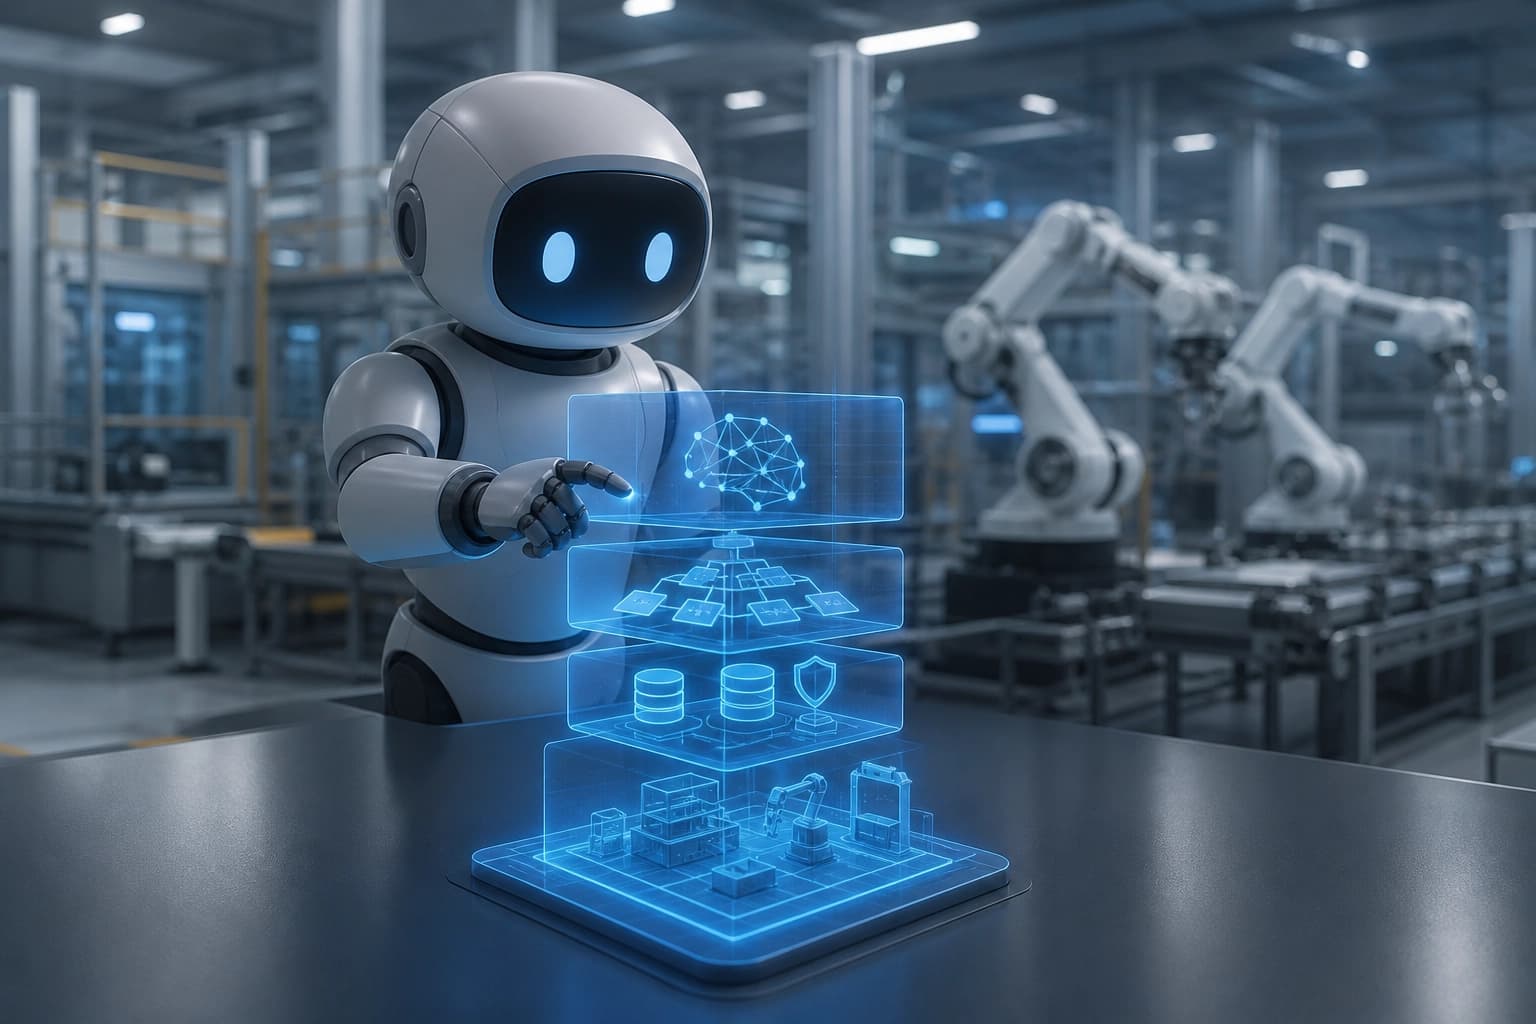
Agentes de LLM em produção: taxonomia, arquitetura e limitações de implementação
O artigo sistematiza pesquisas sobre a aplicação de grandes modelos de linguagem em agentes industriais: identifica obstáculos, níveis de capacidade e uma arquitetura de quatro camadas. Permite compreender quais cenários do ciclo de vida já estão a ser estudados e onde persistem lacunas para um planeamento autónomo fiável.
17 novembro 2026
Abordagem OWP: redistribuição de evidências e sinais a priori no Omni-LLM
É proposto o framework Omni-Woodpecker, que não requer treinamento, identifica conflitos entre modalidades e, antes da decodificação, ajusta o equilíbrio entre os dados de contexto e os vieses aprendidos nos estados ocultos. Em Qwen2.5-Omni-7B e VideoLLaMA2-AV, o método aumenta a robustez a erros audiovisuais no CMM e no AVHBench, além de proporcionar ganhos moderados em benchmarks gerais de raciocínio.
17 novembro 2026