
Como começar com DALL-E 3: um guia passo a passo da configuração às imagens terminadas
Rede neural O OpenAI cria imagens a partir de descrições de texto. Nós quebramos como obter acesso, criar um prompt detalhado, e baixar o resultado, bem como onde opções gratuitas estão disponíveis.
O que é DALL-E 3 e onde funciona
DALL-E 3 é a versão mais recente do modelo de imagem generativa da OpenAI. Ele transforma descrições de texto simples em imagens prontas, e ele faz isso visivelmente mais precisamente do que seus antecessores. A diferença chave é a integração integrada com uma interface de chat: você não pode apenas enviar um prompt, mas também discuti-lo com a rede neural, esclarecer detalhes, e guiar o processo de geração passo a passo. Como resultado, o modelo transforma-se de um gerador simples em um ilustrador completo com um modo conversacional.
O acesso ao modelo está disponível através de planos pagos. Para usuários individuais, a opção mais óbvia é uma assinatura ChatGPT Plus a $20 por mês. Ele permite que você crie até 50 imagens a cada três horas, tornando-o adequado tanto para experimentação regular e tarefas comerciais. As empresas podem se inscrever para o plano corporativo Enterprise, onde os termos são discutidos individualmente. Se você ainda não quer pagar, há um caminho mais leve — sites de terceiros gratuitos que trabalham com o modelo. Eles geralmente têm um limite de geração diária, mas isso é suficiente para uma primeira tentativa.
Se conectando e começando a gerar
Escolha o seu método de acesso
Primeiro, decida onde vai trabalhar. Se você precisar do conjunto completo de recursos e integração de bate-papo sem descontinuidades, site oficial do OpenAI. Após o pagamento, o acesso DALL-E 3 será aberto em sua conta — o modelo já será integrado na interface de chat. Para um teste rápido sem registro, um site como dalle3.org funciona bem. Tais plataformas geralmente não exigem um cartão bancário, mas o número de tentativas por dia é limitado — ainda assim, você pode descobrir se esse estilo de interação lhe cai bem.
Entre na sua conta e envie seu primeiro pedido
Os assinantes só precisam ir ao site do ChatGPT e iniciar uma nova conversa. Lá você verá um campo de entrada regular — é aí que você digita seu prompt. A interface também permite que você peça ao modelo para ajudar com a redação: escreva "screva uma descrição detalhada de uma cena com um astronauta em uma floresta florescente" — e a rede neural irá sugerir uma versão expandida do pedido, que você pode então enviar diretamente para a geração. A primeira imagem aparecerá dentro de alguns segundos, após o que você pode salvá-la ou continuar refinar os detalhes.
Como criar alertas e refinar o resultado
Os detalhes importam mais
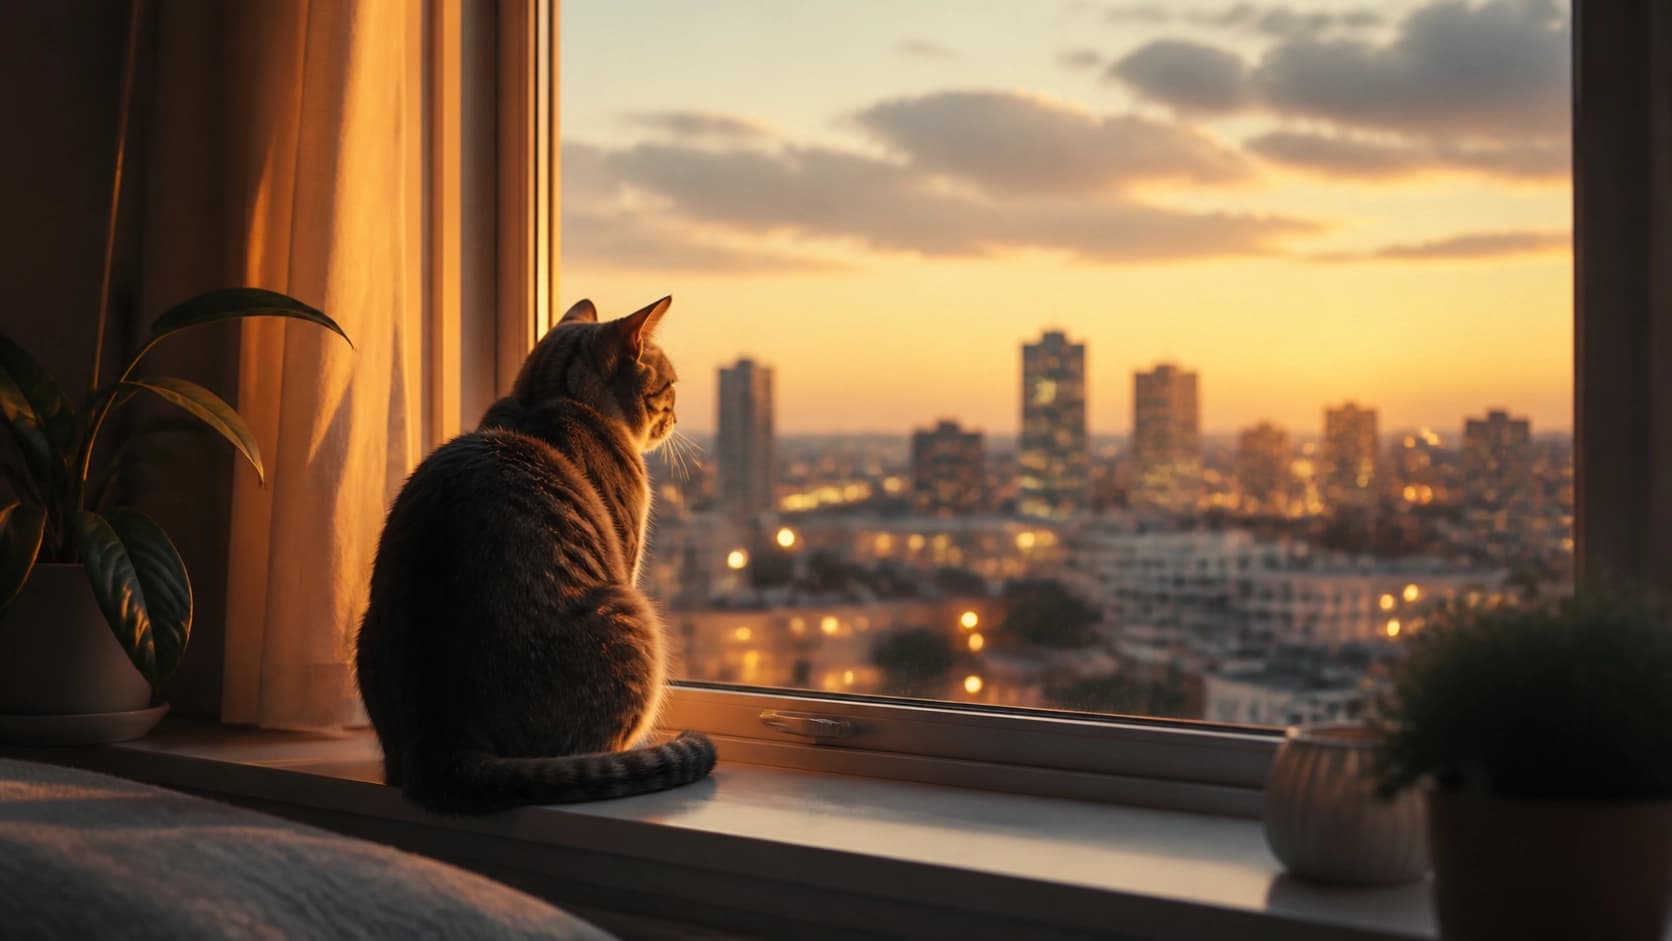
DALL-E 3 entende bem descrições ricas, mas sem especificidades o resultado muitas vezes acaba embaçado. Especifique cores, tamanhos, materiais, iluminação, colocação de objetos e até mesmo humor. Em vez de "desenhe um gato", é melhor escrever "um gato cinza listrado deitado em uma janela, luz da noite, cidade fora da janela, estilo de pintura digital." O modelo transforma tais detalhes em elementos visuais precisos. Se você não tiver certeza de como estruturar um prompt, você pode pedir ajuda ao ChatGPT — ele irá reformular um pequeno pedido em um cenário detalhado, e haverá menos rodadas redo.
Refinação e download
Por padrão, DALL-E 3 produz duas variantes de imagem para cada solicitação. Se um deles já funciona — ótimo, você pode passar direto para o download. Mas mais frequentemente você vai querer mudar algo: cor, fundo, pose de personagem, ou composição. Em vez de começar do zero, basta escrever na conversa o que corrigir, e o modelo irá redesenhar a imagem com suas edições em mente. Você pode manter esse diálogo funcionando até que você obtenha o resultado que você quer. Quando a imagem estiver pronta, clique no ícone de download — o arquivo será salvo em seu dispositivo em alta qualidade.
Onde usar imagens geradas
A gama de aplicações para tais imagens é praticamente ilimitada. No marketing, eles são usados para mídias sociais, banners de anúncios e anúncios de eventos. Os designers os usam como base para conceitos, apresentações e maquetes. Gerações também são usadas para criar impressões em roupas, canecas, cartões e outros produtos personalizados.
Na educação, tais imagens ajudam a criar materiais visuais para aulas e cursos, e na mídia e entretenimento — para ilustrar artigos, vídeos, capas e conceitos de arte. O principal é sempre verificar se o resultado corresponde à tarefa, e não hesite em refinar na conversa, porque é precisamente a capacidade de ajustar interactivamente que torna trabalhar com este modelo tão conveniente.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Método GoldiMask para o ajuste fino de modelos de linguagem de difusão: seleção de contexto e ponderação dos alvos
O trabalho apresenta o GoldiMask — uma abordagem de ajuste fino supervisionado para modelos de linguagem com difusão discreta, que seleciona tokens visíveis por meio da maximização aproximada de uma função submodular e atribui pesos aos objetivos restantes com base na sua utilidade para o treino. As experiências com vários modelos e conjuntos de dados demonstram um aumento da precisão média, ganhos em tarefas de raciocínio lógico e programação, bem como menos iterações de descodificação paralela no GSM8K e no MATH-500, com qualidade semelhante.
30 outubro 2026
MSEB da Google Research: implementação de codificadores de áudio segundo o contrato do benchmark e avaliação em quatro classes de tarefas
Análise prática do pacote mseb==0.1.0: arquitetura em camadas types, encoder e evaluators, dois encoders de demonstração num corpus sintético e chamada direta das métricas de classificação, clustering, pesquisa e segmentação. O material mostra como adaptar o seu próprio modelo ao MultiModalEncoder abstrato, interpretar o formato SoundEmbedding e criar TaskMetadata para posterior envio para o benchmark.
10 outubro 2026
LoRA de base nula para ajustar LLMs após o RL sem perder competências de raciocínio
Os autores propõem um método de adaptação eficiente em termos de parâmetros para modelos treinados por reforço, no qual as atualizações LoRA são projetadas num espaço nulo aproximado das ativações de raciocínio. Esta abordagem permite preservar a precisão do raciocínio ao nível anterior ao ajuste fino, sem comprometer a qualidade da adaptação em comparação com a LoRA convencional.
5 outubro 2026