Por que o SFT após o RL ameaça o raciocínio
O aprendizado por reforço desenvolve as capacidades de raciocínio dos grandes modelos de linguagem. Essa abordagem se tornou eficaz para o pós-treinamento de LLMs. O fine-tuning supervisionado posterior adapta o modelo pós-RL a novos domínios de conhecimento ou tipos de comportamento. Esse SFT pode sobrescrever seriamente as capacidades adquiridas.
Abordagens existentes para reduzir o esquecimento:
- replay de experiências;
- inicialização especializada;
- otimização restrita com projeção do gradiente.
Esses métodos ou oferecem uma preservação limitada das capacidades ou exigem um volume significativo de computação adicional. Critério prático: para um modelo pós-RL, escolhe-se um método que reduza o risco de sobrescrever o raciocínio.
O espaço nulo como recurso para adaptação
Os autores mostram que as ativações relacionadas ao raciocínio se concentram em subespaços de baixa dimensão. Resta uma capacidade considerável no espaço nulo para adaptação. É possível estimar de forma confiável espaços nulos aproximados com um pequeno número de exemplos.
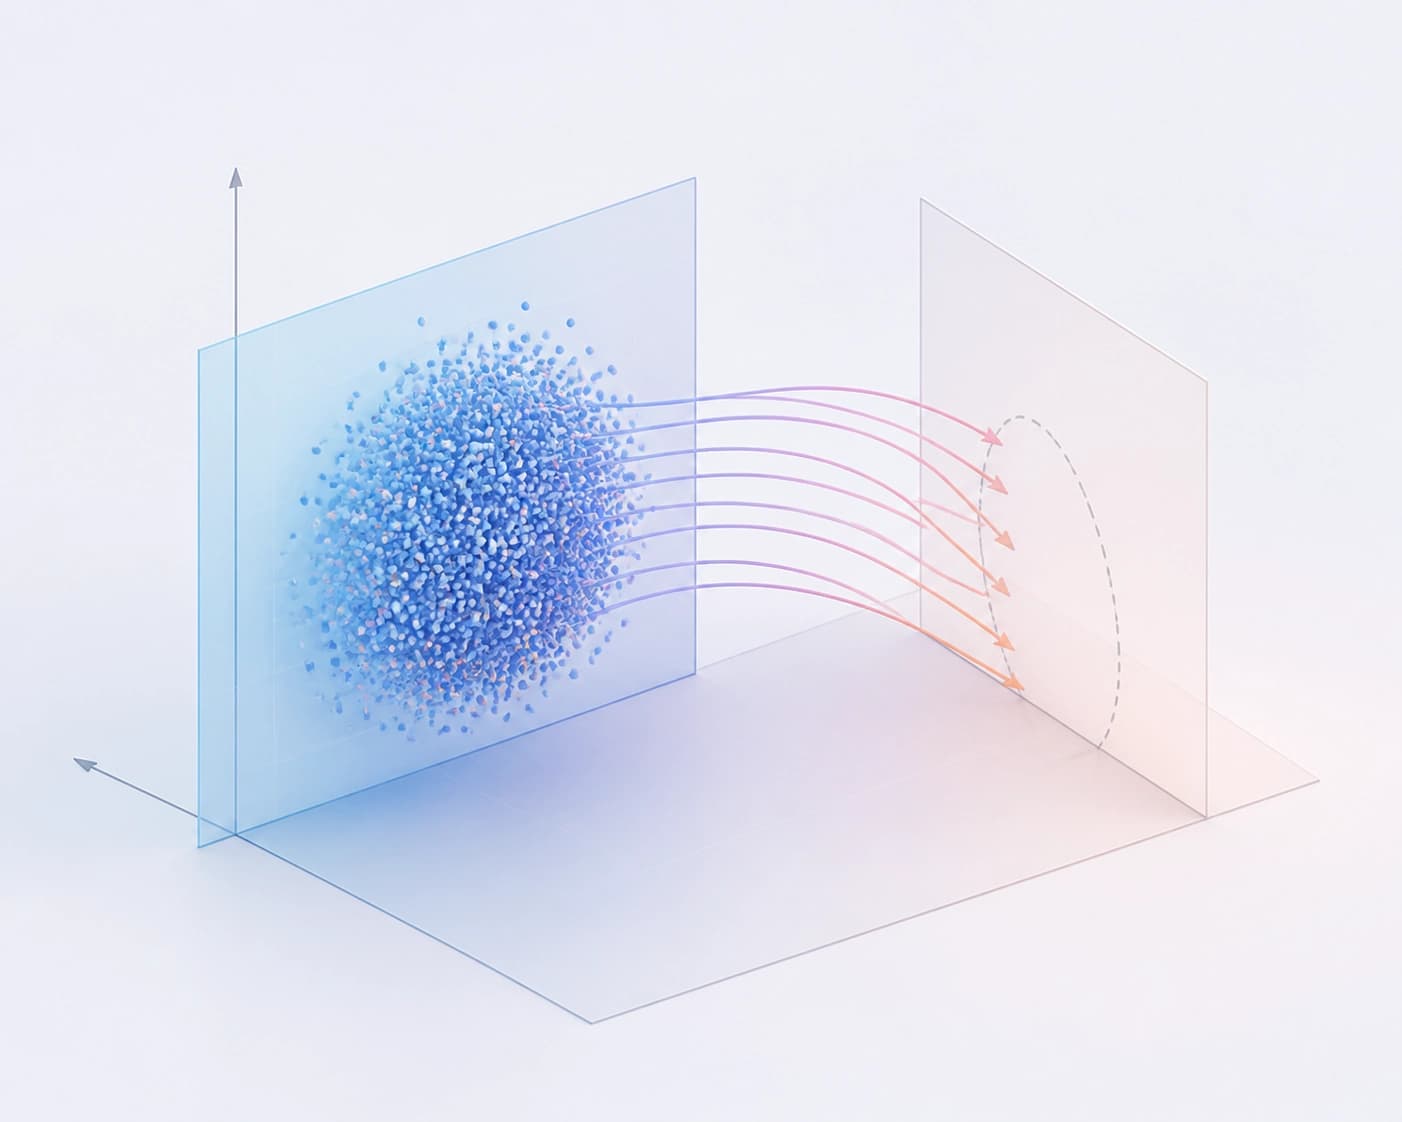
Critério prático: um método que constrói atualizações no espaço nulo aproveita a capacidade disponível. Ele não afeta as ativações de raciocínio.
Como funciona o NB-LoRA
Null-Basis Low-Rank Adaptation (NB-LoRA) é um método de adaptação parametricamente eficiente para LLMs pós-RL. Foi proposto no artigo arXiv:2609.25618. O método preserva as capacidades de raciocínio adquiridas.
Etapas de funcionamento:
- Constrói-se uma base nula aproximada e fixa a partir das ativações de raciocínio.
- As atualizações LoRA são reparametrizadas por meio dessa base.
- A preservação do raciocínio é formulada como uma restrição à preservação dos estados ocultos no nível das camadas.
- A restrição é respeitada durante todo o fine-tuning.
Critério prático: escolhe-se o NB-LoRA quando é necessário realizar SFT e preservar o raciocínio do modelo pós-RL.
Comparação com as abordagens existentes
A tabela compara os mecanismos e as características.
| Critério | Abordagens existentes | NB-LoRA |
|---|---|---|
| Mecanismo | Replay de experiências, inicialização especializada, otimização restrita com projeção do gradiente | Reparametrização LoRA por meio de uma base nula aproximada e fixa |
| Característica | Preservação limitada das capacidades ou computação adicional significativa | Restrição à preservação dos estados ocultos no nível das camadas |
Critério prático: se a prioridade é preservar o raciocínio, o NB-LoRA oferece uma restrição integrada. As abordagens existentes exigem escolher entre preservação limitada e computação adicional.
Resultados dos experimentos e critério de escolha
Os experimentos abrangem várias LLMs treinadas com RL e uma diversidade de tarefas posteriores. O NB-LoRA apresenta qualidade de adaptação comparável à da LoRA padrão. O método preserva a precisão de raciocínio em um nível próximo ao anterior ao fine-tuning. Essa preservação se estende a benchmarks de raciocínio reservados para avaliação.
Critério prático: para LLMs pós-RL nas quais o SFT ameaça o raciocínio, o NB-LoRA é uma opção a ser testada nas próprias tarefas.