
Método GoldiMask para o ajuste fino de modelos de linguagem de difusão: seleção de contexto e ponderação dos alvos
O trabalho apresenta o GoldiMask — uma abordagem de ajuste fino supervisionado para modelos de linguagem com difusão discreta, que seleciona tokens visíveis por meio da maximização aproximada de uma função submodular e atribui pesos aos objetivos restantes com base na sua utilidade para o treino. As experiências com vários modelos e conjuntos de dados demonstram um aumento da precisão média, ganhos em tarefas de raciocínio lógico e programação, bem como menos iterações de descodificação paralela no GSM8K e no MATH-500, com qualidade semelhante.
O mascaramento define duas decisões de uma só vez
O ajuste fino de modelos de linguagem de difusão discreta baseia-se na recuperação de tokens mascarados. Parte dos tokens da resposta é ocultada por uma máscara, e o modelo prevê os seus valores originais com base no contexto visível.
O esquema de mascaramento define duas coisas ao mesmo tempo. Determina o contexto a que o modelo tem acesso. Determina também quais tokens se tornam alvos de previsão.
Estas decisões estão interligadas: um token revelado deixa de ser um alvo. O mascaramento aleatório uniforme não tem esta relação em conta. Por isso, alguns tokens são revelados em situações em que pouco contribuem para a previsão.
A metodologia GoldiMask é descrita no artigo Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting (arXiv:2609.38385, 29 de setembro de 2026). Destina-se ao ajuste fino supervisionado de modelos de linguagem de difusão discreta.
| Decisão | Mascaramento aleatório uniforme | GoldiMask |
|---|---|---|
| Que tokens revelar como contexto | seleção aleatória | seleção com base numa função objetivo submodular |
| Peso dos restantes tokens-alvo | independente do contexto selecionado | depende da contribuição do contexto e do potencial de aprendizagem |
| Relação entre as duas decisões | não é tida em conta | é tida em conta através de sinais do modelo |
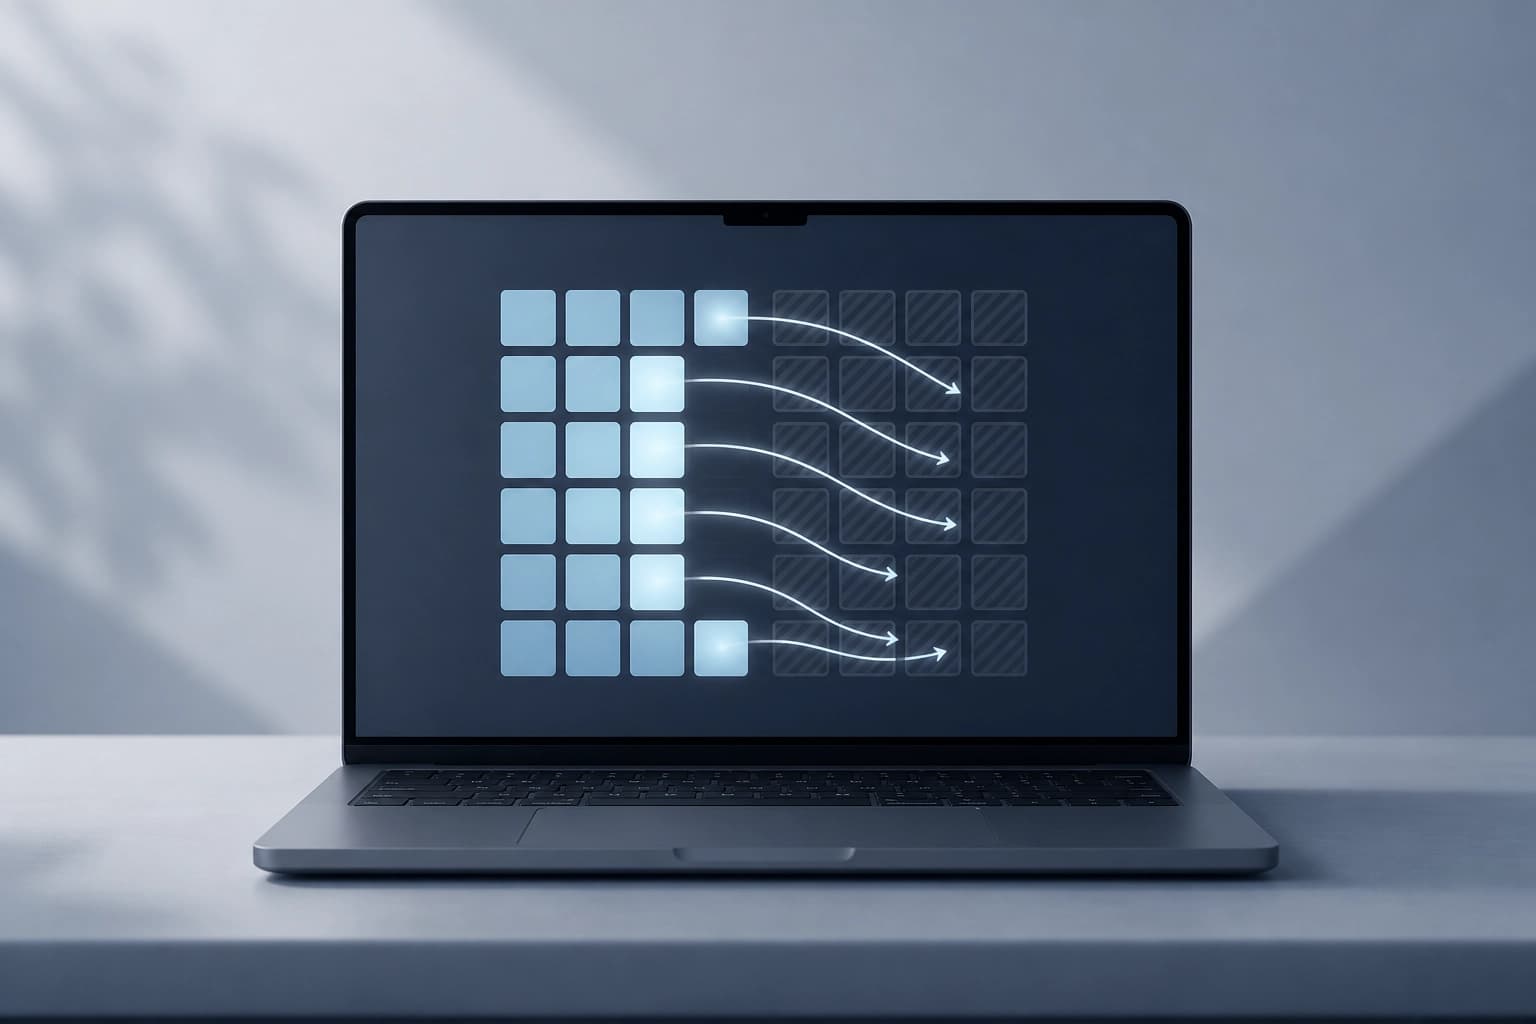
Critério: o esquema de mascaramento deve ser avaliado como uma decisão única sobre o contexto e os alvos. Assim, é possível perceber em que casos a revelação de tokens se justifica e em quais não.
Seleção de contexto com base em sinais do modelo
GoldiMask seleciona os tokens a revelar como contexto. A seleção maximiza aproximadamente uma função objetivo submodular.
O método utiliza sinais do modelo e equilibra duas grandezas:
- o benefício de revelar um token específico;
- o valor desse token como alvo de previsão.
É vantajoso revelar um token que ajude a prever os tokens à sua volta. É preferível manter como alvo um token que o modelo tenha dificuldade em prever.
Critério prático: a seleção aleatória de contexto não utiliza sinais do modelo. Se for utilizado precisamente esse esquema, o potencial da seleção de contexto fica por explorar.
Ponderação dos tokens-alvo
Depois da seleção do contexto, alguns tokens permanecem como alvos de previsão. GoldiMask atribui-lhes pesos tendo em conta dois fatores:
- em que medida o contexto selecionado ajuda a prever um token específico;
- qual o potencial de aprendizagem que resta nesse token.
Deste modo, o peso relaciona os alvos com a decisão já tomada sobre o contexto. A ponderação não determina o que revelar. Determina a contribuição para a aprendizagem dos tokens que permaneceram ocultos.
Critério: ao analisar um esquema de mascaramento, é útil separar duas questões — o que revelar e com que peso treinar o que resta.
Resultados em modelos e conjuntos de dados
GoldiMask foi testado em três modelos de base e três conjuntos de dados de treino. A precisão média do método foi a mais elevada na maioria das configurações avaliadas.
As melhorias abrangeram tarefas de raciocínio e geração de código. Os estudos de ablação dos componentes mostraram que ambos os mecanismos contribuem para as melhorias: tanto a seleção de contexto como a ponderação dos tokens-alvo.
Critério prático: ter a precisão mais elevada na maioria das configurações não significa obter ganhos em todas elas. Vale a pena testar o método com cada par específico de «modelo de base + conjunto de dados de treino».
Efeito na descodificação paralela
Outro resultado diz respeito à descodificação paralela com um limiar de confiança. No GSM8K e no MATH-500, GoldiMask reduz o número de iterações de descodificação.
A precisão mantém-se comparável com limiares de confiança mais elevados.
Critério prático: se o pipeline utilizar descodificação paralela com um limiar de confiança, o método afeta tanto o número de passos de descodificação como a precisão. Avaliá-lo apenas pela precisão é, neste caso, insuficiente.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
A transição para o simplex probabilístico reduz a lacuna modal em modelos multimodais contrastivos
O trabalho arXiv:2610.32890 propõe substituir embeddings esféricos por um simplex probabilístico, adicionando adaptadores softmax leves e a similaridade de Variação Total. Em cinco benchmarks de recuperação, a distância ℓ2 entre centroides de modalidades diferentes diminui 97–99%, mantendo ou melhorando a qualidade da recuperação.
3 novembro 2026
Como o ActionRAG reavalia evidências durante a difusão no grafo de memória de agentes LLM
Foi proposta uma arquitetura de memória em grafo que, na fase de indexação, harmoniza cuidadosamente as entidades e, no momento da consulta, reavalia as relações com base na estrutura local. No MemoryAgentBench, o método alcançou uma precisão média de 55,1 e uma melhoria de 5,4 pontos percentuais face ao melhor método de referência de recuperação, com um custo de síntese reduzido por consulta.
3 novembro 2026
Quinze empresas apoiaram o MDK Tether para automatizar a mineração
Fabricantes de equipamentos, pools e operadores assumiram o desenvolvimento de integrações com o conjunto aberto da Tether para unificar a monitorização e a gestão dos equipamentos; o agente de IA QVAC já funciona com base nele. Ainda não foram publicados dados independentes que confirmem a redução dos custos de eletricidade ou o aumento da eficiência.
2 novembro 2026