Por que a IBM foi na direção dos agentes
Um cliente corporativo raramente compra um modelo por causa de demos bonitas. Ele precisa que o software faça algo: processar tickets, conferir faturas, acionar APIs internas, escrever resumos de documentos. É exatamente esse nicho que a lógica agêntica ocupa — quando o modelo não apenas responde a uma pergunta, mas decide por conta própria qual ferramenta chamar em seguida.
O Granite 4.2 nessa história não é "mais um modelo grande", mas uma tentativa da IBM de completar a linha de modo que ela funcione com a mesma confiança tanto na nuvem quanto no ambiente fechado do cliente. A aposta está na combinação de três coisas: pesos abertos, exigências modestas de hardware e comportamento previsível ao chamar funções externas.
O que é, afinal, a linha Granite
A IBM mantém a família de modelos abertos sob o nome Granite há vários anos. Nesse tempo, consolidou-se uma filosofia reconhecível: os modelos são lançados em vários tamanhos, voltados em primeiro lugar para código, trabalho com tabelas, extração de dados de documentos e cenários corporativos, e não para competir em benchmarks gerais de chat.
Tamanhos importam
A linha é construída como uma escada — desde opções bem pequenas, que cabem em uma única placa de vídeo ou até rodam em processador, até modelos de porte médio. A ideia é que, para cada tarefa, seja possível escolher o tamanho mínimo suficiente. Para um agente que basicamente roteia requisições e chama funções, um modelo gigante costuma ser exagerado: é mais caro em inference e responde mais devagar.
Arquitetura híbrida
Na quarta geração da família, a IBM passou para um esquema híbrido, em que parte das camadas é construída sobre Mamba e parte sobre a atenção clássica do transformer. O ganho prático aqui é prosaico: o contexto longo é processado mais barato, a memória é consumida de forma mais econômica e a vazão no mesmo hardware é maior. Para cenários agênticos isso é crítico, porque no contexto são constantemente carregados resultados de chamadas de ferramentas, trechos de documentos e o histórico de passos.
Licença sem surpresas
Os modelos Granite são distribuídos sob a licença Apache 2.0. Para o jurista corporativo, essa é uma notícia entediante — e isso é justamente uma boa notícia: é possível fazer fine-tuning, incorporar em um produto comercial, implantar dentro do perímetro e não prestar contas ao fornecedor sobre quanto o produto faturou.
O principal argumento: dá para manter isso em casa
APIs de nuvem são convenientes exatamente até o momento em que os dados passam a estar sob restrições regulatórias. Um banco, uma clínica, uma indústria ou um órgão público muitas vezes não pode, fisicamente, enviar parte dos documentos para fora. É aí que começa a conversa sobre "hardware próprio".
O que realmente é necessário para rodar
O ponto-chave aqui não são aceleradores de ponta, mas um mínimo razoável. As versões pequenas do Granite sobem em uma placa de consumidor, em um contêiner em um servidor sem GPU ou no notebook do desenvolvedor. Os tamanhos médios já exigem várias placas ou quantização. A execução normalmente se dá por ferramentas padrão como vLLM ou Ollama, o que elimina o problema de dependência de um stack exclusivo do fornecedor.
Segurança e previsibilidade
A segunda camada do argumento é o controle. Quando o modelo vive no seu ambiente, você mesmo decide quais logs escrever, quais dados entram no prompt, o que é cacheado e por quanto tempo é armazenado. Para agentes isso é especialmente importante: eles são capazes de executar ações, e não apenas gerar texto, e cada uma dessas ações é melhor que passe pelas suas próprias regras e auditoria.
A IBM aqui vende não apenas o modelo, mas também o arcabouço: a plataforma watsonx, um conjunto de modelos "guardiões" para filtrar conteúdo indesejado e ferramentas de fine-tuning com dados próprios. O modelo, nesse esquema, é um detalhe — ainda que central.
Como um cenário agêntico se parece na prática
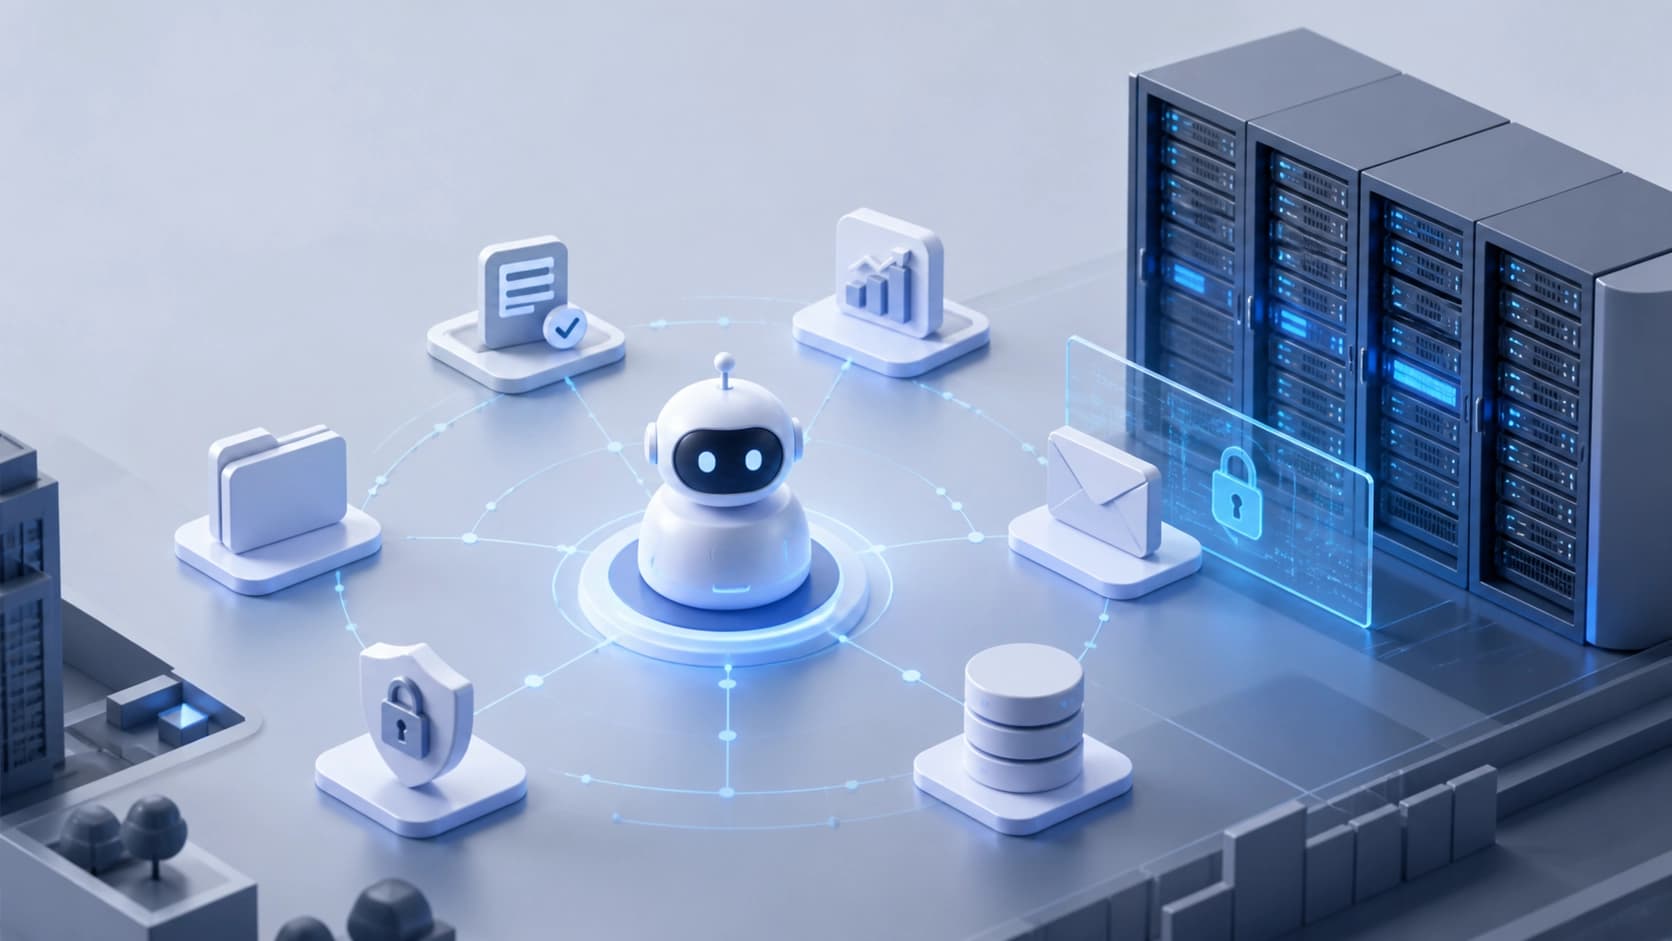
A ideia do agente é simples: o modelo recebe uma tarefa, decide de quais dados ele não dispõe, chama a ferramenta necessária, lê a resposta e continua até chegar ao resultado. A diferença entre "apenas um chat" e um agente está na existência de um ciclo e de permissões.
Papéis típicos para os quais esses modelos são afinados:
- Roteador. Analisa a solicitação recebida e decide para qual cenário encaminhá-la.
- Extrator. Extrai campos de faturas, contratos, extratos e os organiza em uma estrutura.
- Executor. Aciona APIs de sistemas internos: cria uma solicitação, atualiza um status, envia um e-mail.
- Revisor. Verifica o resultado do passo anterior e decide se ele pode ser aceito.
Um modelo pequeno em cada uma dessas etapas costuma ser mais vantajoso do que um único grande: mais barato, mais rápido, mais fácil de testar e, o que não é pouco, mais simples de substituir se a qualidade deixar de satisfazer.
No que prestar atenção e onde estão as limitações
Modelos abertos não são uma pílula mágica, e uma conversa honesta sobre limitações é mais útil do que marketing.
Tamanho versus qualidade de raciocínio
Modelos pequenos são econômicos, mas em tarefas complexas de múltiplos passos ainda ficam atrás dos grandes. O compromisso costuma ser buscado na arquitetura: dividir papéis entre vários modelos pequenos, adicionar verificações determinísticas em código, deixar com o humano o direito da decisão final.
O ecossistema ao redor
Pesos abertos significam que o modelo é facilmente portável entre frameworks — do LangChain a orquestradores feitos sob medida. O outro lado: há menos soluções prontas "de prateleira" para um setor específico do que em plataformas proprietárias, e parte do trabalho de integração recai sobre a equipe do cliente.
Hardware e custo de propriedade
Hardware próprio não é apenas economia com API, mas também custos de capital, eletricidade, refrigeração e pessoas que cuidam de tudo isso. Para uma empresa pequena, a nuvem quase sempre sairá mais barata; para uma grande com dados sensíveis, o oposto — e esse limiar se desloca conforme os volumes.
Avaliação de qualidade
A principal armadilha é medir o agente com benchmarks gerais. Um agente que funciona é verificado nos seus próprios cenários: um conjunto de tarefas reais com resposta correta conhecida, a robustez a dados de entrada sujos e o comportamento quando a ferramenta chamada retornou erro. Sem esse conjunto, qualquer número de nota de lançamento continua sendo um número de nota de lançamento.
O que se conclui disso
A reação da IBM ao momento atual do mercado parece lógica. Enquanto uns correm atrás da qualidade máxima na nuvem, outros ocupam o nicho em que importam mais o controle, o preço por token e a possibilidade de implantar tudo dentro do perímetro. Pesos abertos mais exigências modestas de recursos mais ênfase na chamada de ferramentas — exatamente o conjunto de que precisa o cliente corporativo cansado de aprovar o envio de dados para fora.
A questão central não é se a nova versão vai superar os líderes nos testes gerais. A questão é se a equipe terá disciplina suficiente para construir em torno do modelo um contorno agêntico adequado: com permissões limitadas, auditoria, testes e rollback claro. Se sim, manter um agente desses no próprio hardware torna-se uma estratégia perfeitamente viável, e não um compromisso.