Coelho perseguindo um tigre: o teste que expôs um ponto cego
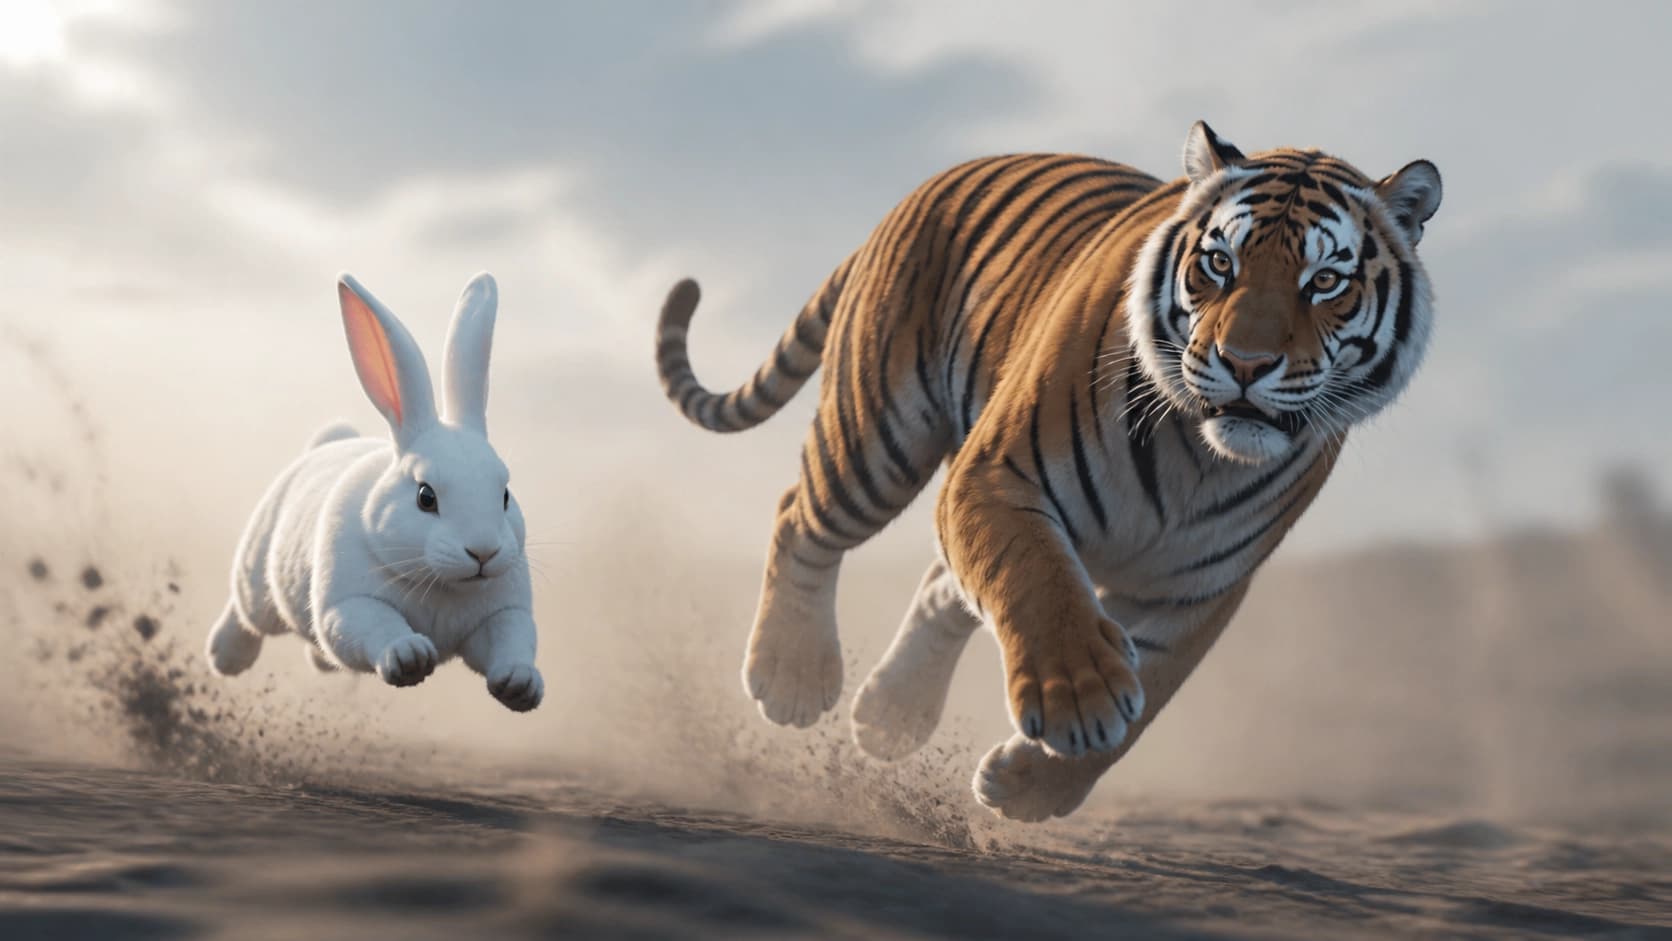
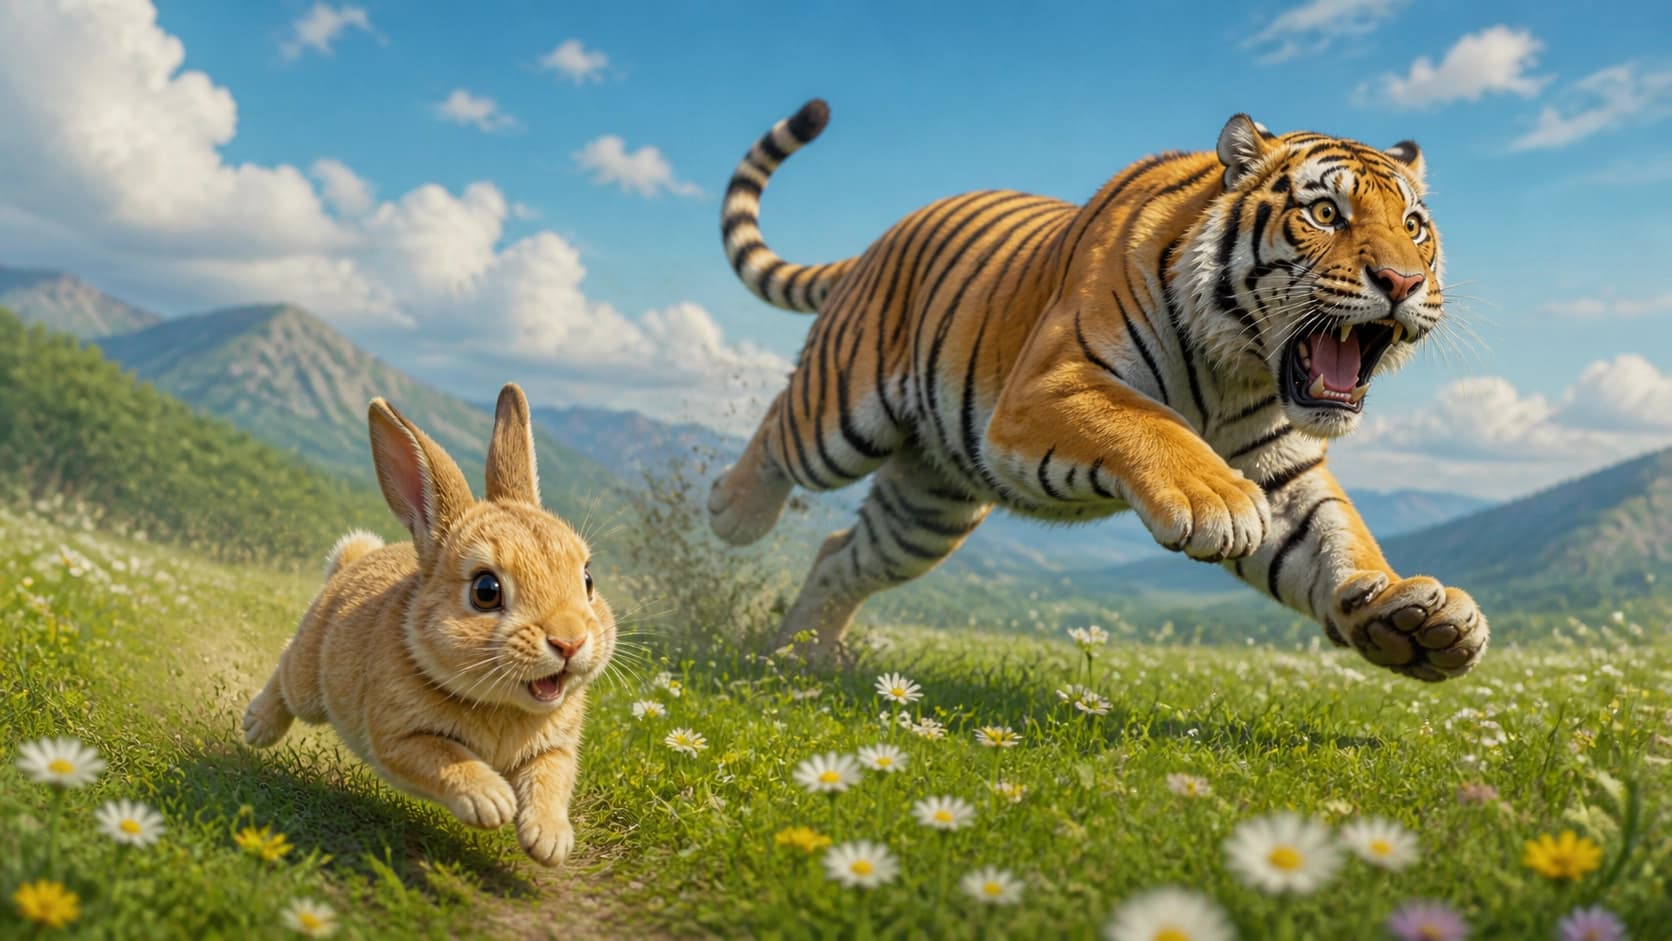
Imagine a cena: um coelho dispara por um prado, e à sua frente foge um tigre. A composição é precisa, os detalhes são nítidos, não há ambiguidade alguma — visualmente tudo é inequívoco. E, ainda assim, boa parte dos modelos multimodais abertos descreve essa cena ao contrário. Não porque enxergam mal, mas porque não acreditam no que veem.
É justamente esse paradoxo que o estudo «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, autores Chen Ling, Tongwei Zhang, Hanqian Li e Nai Ding) analisa. O trabalho foi publicado em janeiro de 2026 e, desde então, foi atualizado duas vezes — a última revisão é de agosto. Formalmente, é um artigo de visão computacional, mas suas conclusões são bem mais amplas: atingem a própria lógica de como os assistentes multimodais modernos são construídos.
O que exatamente foi testado
Os modelos multimodais há muito resolvem com segurança as tarefas "mainstream": descrever uma fotografia, encontrar um objeto a partir de uma consulta textual, responder a uma pergunta com base em um diagrama. Mas esses testes quase sempre se baseiam em cenas que coincidem com as expectativas cotidianas. Um gato no parapeito, uma pessoa com guarda-chuva na chuva, um carro na estrada — tudo isso o modelo já viu milhões de vezes nas legendas dos datasets.
E o que acontece se o mundo visual contrariar o senso comum? Para descobrir, a equipe montou o benchmark CAIT — 400 cenas sintéticas de alto nível de detalhe. Cada uma retrata uma ação que contradiz a imagem de mundo habitual: o próprio coelho perseguindo o tigre é um exemplo característico. As imagens são sintéticas e, portanto, controladas: é possível ter certeza de que a pista visual realmente existe e é inequívoca.
A ideia central da metodologia é que a resposta correta aqui não pode ser deduzida do texto da pergunta. Só é possível obtê-la de uma maneira: olhar para a imagem e aceitar o que nela está desenhado.
Humanos, modelos fechados e abertos: a diferença nos números
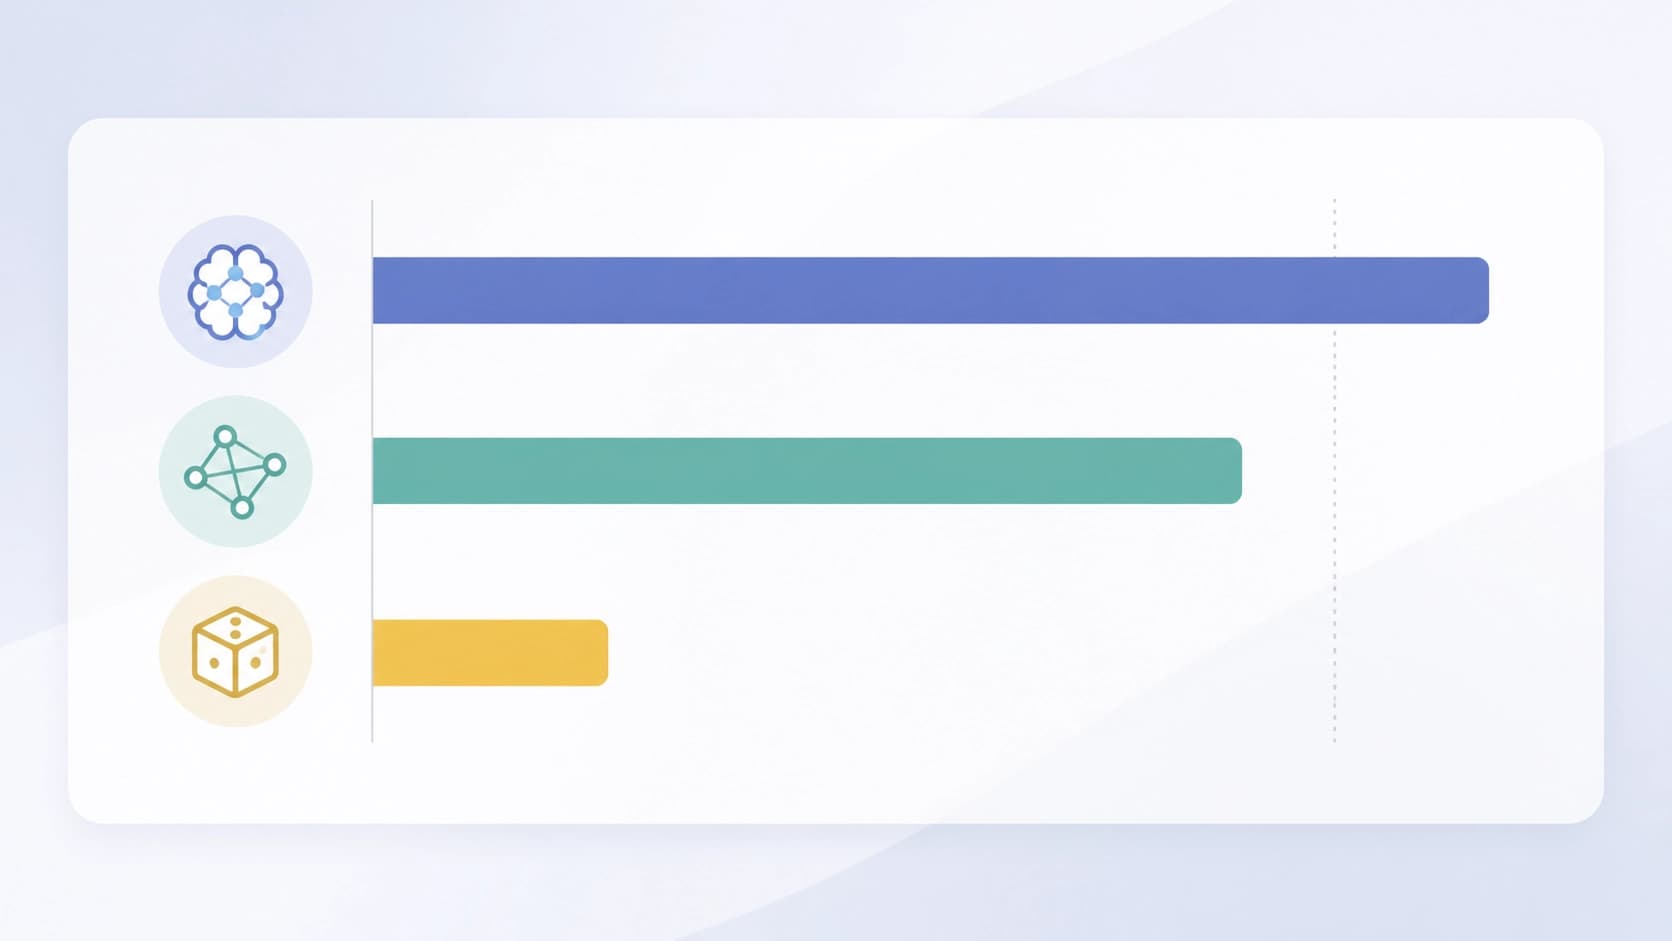
Os resultados se distribuíram em três níveis muito distintos.
- Humanos resolvem a tarefa quase impecavelmente — precisão em torno de 0,95. Para nós, não há nada difícil em ver uma cena incomum e simplesmente registrá-la.
- Modelos proprietários — o estudo envolveu as principais soluções, incluindo Claude e Gemini — demonstram compreensão consistente: a precisão chega a 0,88. Não é perfeito, mas o sistema claramente olha para a imagem em vez de adivinhar.
- Modelos abertos com instruction tuning — 14 representantes — despencam ao nível de chute aleatório. Em outras palavras, suas respostas quase não se correlacionam com o que está realmente desenhado.
É esse o enredo principal: a diferença entre o "tigre" das soluções fechadas e o "coelho" das abertas revelou-se não cosmética, mas fundamental. Não se trata de os modelos abertos se saírem um pouco pior em uma tarefa complexa — em cenas contraintuitivas, eles deixam de ser multimodais em qualquer sentido minimamente significativo.
O principal culpado — o prior linguístico
A análise dos erros mostra a mecânica da falha. Não é que o modelo não tenha enxergado o coelho. É que ele preferiu não acreditar nos próprios olhos.
Quando o sinal visual contradiz a estatística do texto, entra em ação um poderoso prior linguístico: o modelo automaticamente substitui a observação anômala pela descrição textual mais frequente. O tigre persegue o coelho — essa combinação aparece nos corpora o tempo todo. A ordem inversa — quase nunca. E na bifurcação entre "vi" e "esperava", o sistema escolhe a segunda opção.
Na prática, a entrada visual serve para esse tipo de modelo apenas como uma pista sobre qual frase recuperar da memória. Se a imagem confirma o padrão — tudo bem. Se discorda dele — o padrão vence. Daí a precisão no nível de cara ou coroa: o modelo responde por inércia da linguagem, não pelo conteúdo da imagem.
A armadilha do raciocínio: "repensar" a cena
A sugestão lógica é adicionar ao modelo uma cadeia de raciocínio (Chain-of-Thought). Que ele verbalize os passos, verifique a si mesmo, chegue a uma conclusão. Em parte, isso funciona: a precisão de fato aumenta.
Mas toda melhoria tem um preço, e o preço é duplo.
Em primeiro lugar, a resposta fica consideravelmente mais lenta — raciocínios detalhados exigem tempo e computação. Em segundo — e isso é mais interessante — surge um novo modo de falha. O modelo começa literalmente a repensar o que viu. Ele parece registrar a cena e depois descartá-la: isso não acontece, viola as leis físicas do mundo real, logo, provavelmente eu me enganei. Como resultado, o sistema se recusa a aceitar o conteúdo visual factual justamente porque ele é impossível.
O resultado é uma ironia peculiar: uma ferramenta criada para tornar a conclusão mais fundamentada às vezes se transforma em uma máquina de suprimir fatos incômodos.
O que ajuda: fine-tuning e prompting estruturado
A boa notícia é que o problema não é fatal. Os autores descrevem duas abordagens que atenuam consideravelmente a dependência dos priors linguísticos.
- Fine-tuning direcionado. O treinamento adicional com dados adequados reduz a tendência de substituir a observação pelo padrão e devolve peso ao canal visual.
- Prompting estruturado. Se for imposto ao modelo um formato de resposta em que ele é obrigado primeiro a registrar o observado e só depois a interpretar, a precisão aumenta sem retreinamento.
Em ambos os casos, os modelos abertos passam a fundamentar a conclusão em evidências visuais reais, e não na estatística do texto. Ou seja, a diferença em relação às soluções fechadas é uma questão de arquitetura e treinamento, não uma impossibilidade fundamental.
O que disso decorre na prática
Para o desenvolvedor que constrói um produto sobre um modelo multimodal aberto, as conclusões são bastante concretas.
Vale lembrar que uma resposta confiante não é igual ao que foi visto. Onde a cena coincide com as expectativas, o modelo demonstra confiabilidade; onde diverge, ele silenciosa e discretamente insere uma invenção plausível. O mais perigoso é que o erro não parece um erro: a descrição sai fluida, lógica e completamente incorreta.
Além disso, vale tratar o raciocínio como uma ferramenta com efeitos colaterais. O Chain-of-Thought não ajuda sempre nem em todas as tarefas — às vezes ele transforma o modelo em um cético que rejeita sua própria conclusão correta.
E, por fim, o principal. "O coelho persegue o tigre" não é uma curiosidade, mas um teste puro daquilo em que o modelo realmente confia. Enquanto a resposta a essa pergunta não for favorável à imagem, chamar o sistema de multimodal só é possível em termos condicionais.