Três modelos, uma licença e nenhuma ressalva
O Granite 4.2 já não é um assistente voltado para seguir instruções, como eram os lançamentos anteriores da linha. A IBM reestruturou a família em torno do raciocínio explícito: qualquer um dos modelos primeiro verbaliza uma cadeia de passos e só depois formula a resposta. O lançamento traz três tamanhos — 3B, 8B e 30B de parâmetros.
A principal novidade para as empresas não está nos benchmarks, mas na licença. Os três modelos são distribuídos sob Apache 2.0: baixar, fazer fine-tuning e rodar em produção não exigem aprovações adicionais nem impõem restrições ao uso comercial. Para empresas de setores regulados, a possibilidade de manter os pesos on-prem muitas vezes pesa mais do que qualquer linha em tabelas de métricas.
Em paralelo, foram lançados dois modelos de fala Granite Speech 5.0 Turbo CTC, com 470 milhões de parâmetros cada — sobre eles, falaremos separadamente abaixo.
O modo de operação é alternado diretamente no chat template. Há o thinking, há o non-thinking e, entre eles, o low-effort: um orçamento curto de raciocínio para perguntas simples, para não gastar tokens onde a tarefa não justifica. Na prática, o mesmo modelo atende tanto ao "pense com calma" quanto ao "responda rápido".
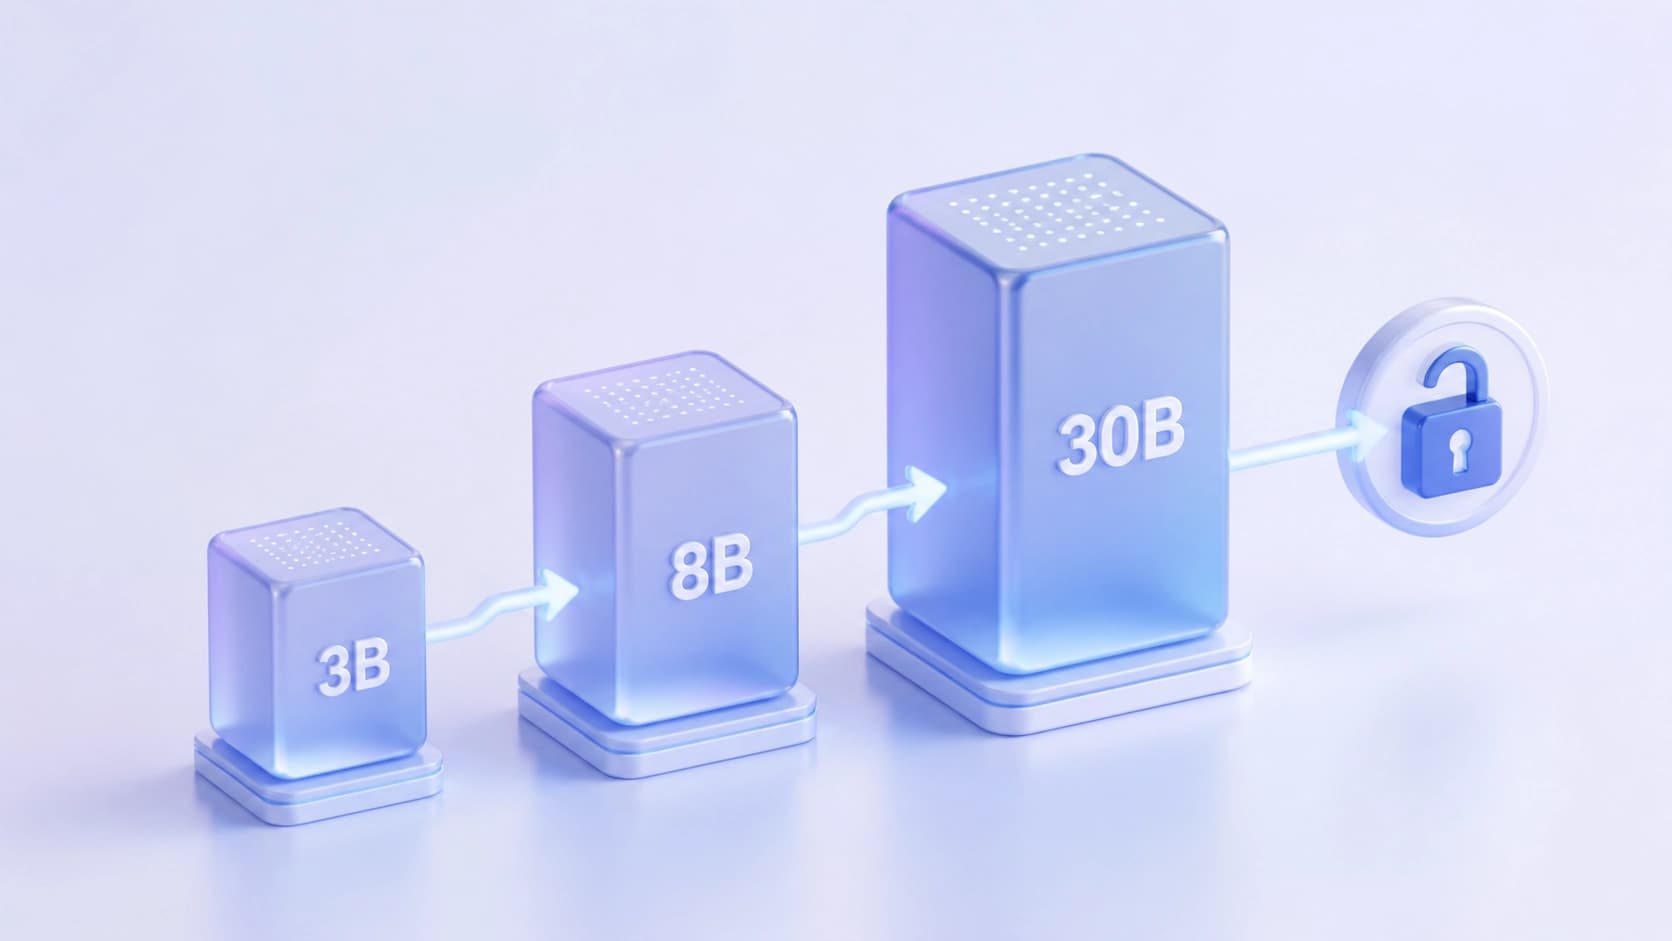
Qual tamanho para quem
3B — o notebook do desenvolvedor individual
O modelo menor é voltado para desenvolvedores individuais e startups pequenas. É possível rodá-lo localmente via Ollama ou LM Studio, inclusive em quantizações GGUF publicadas até Q4_K_M. É o cenário "instalei no notebook e experimento sem me preocupar com a conta da API".
8B — uma GPU moderna por equipe
O tamanho intermediário é destinado a equipes de médio porte: uma placa de vídeo atual basta para manter o modelo no ambiente de trabalho.
30B — o ambiente corporativo
A variante maior exige capacidade no nível de A100 ou H100, além de operação em FP8 ou NVFP4 no vLLM. Em compensação, é o caso em que o modelo pode ser instalado dentro do perímetro e os dados não precisam sair para fora.
Setores que a IBM mira explicitamente: desenvolvimento de software e ferramentas para desenvolvedores, serviços financeiros, saúde, telecom, setor público e contact centers — estes últimos justamente para os novos modelos de fala. Cenários típicos: agentes para escrever código, automação de terminal e DevOps, pesquisa e busca aprofundadas, RAG sobre documentos longos, chamada estruturada de ferramentas e transcrição em massa.
Arquitetura: transformer denso sem truques
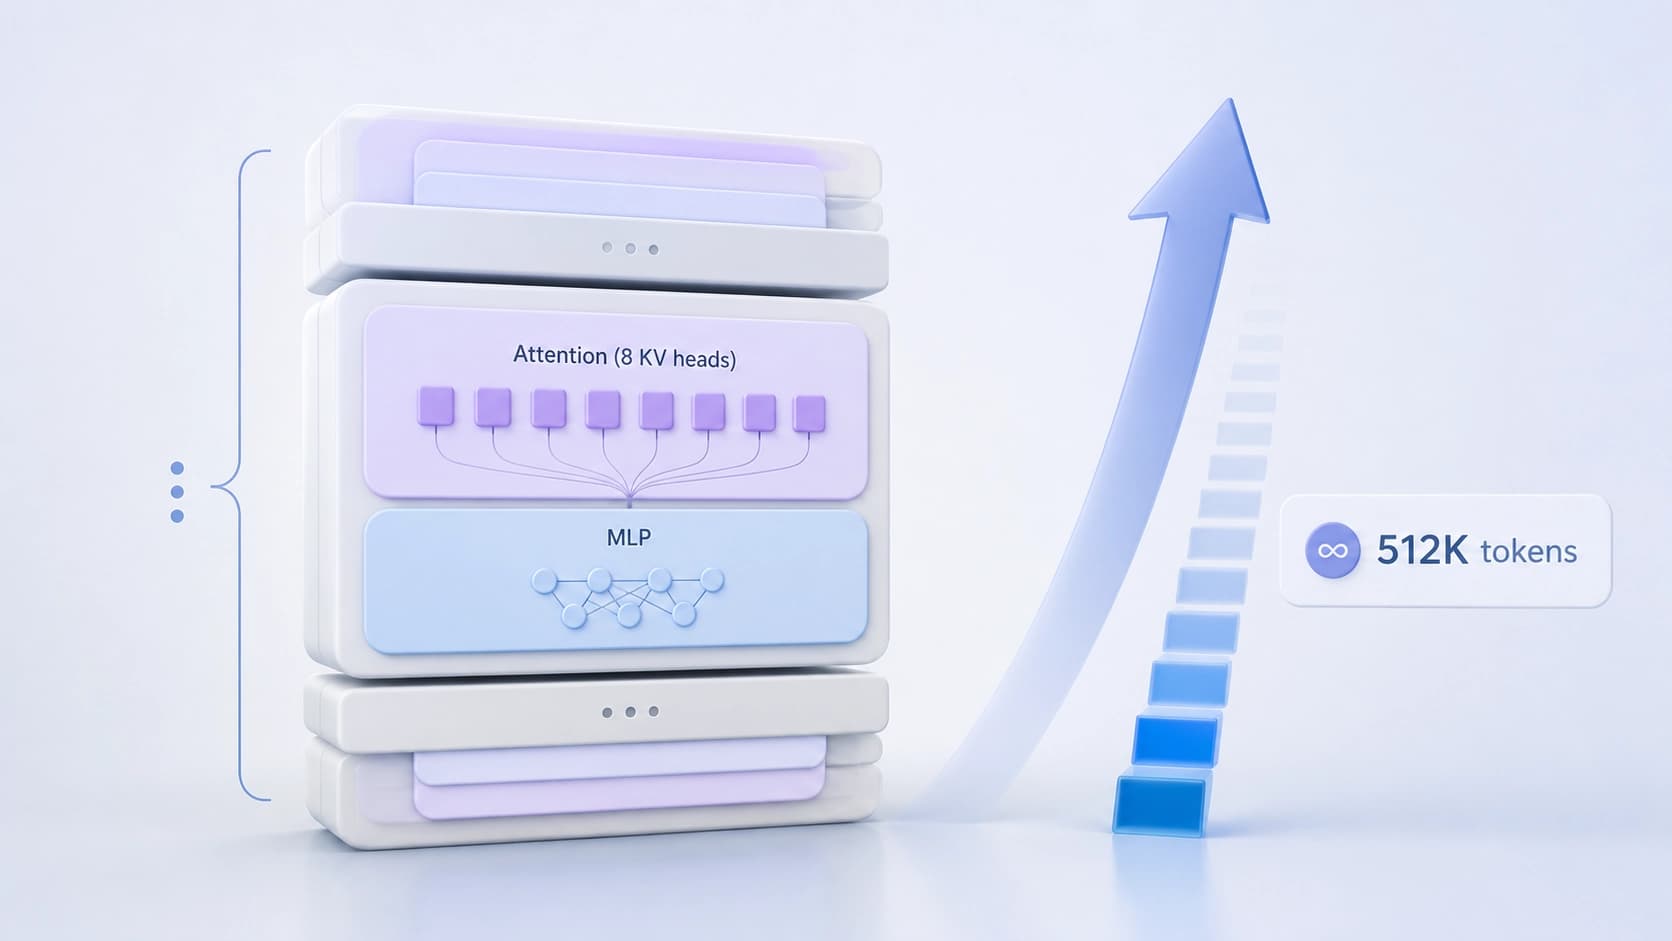
O Granite 4.2 é um transformer denso decoder-only. Nada de hibridismo, nada de mixture-of-experts: a aposta foi na previsibilidade de comportamento e na simplicidade de implantação, o que faz sentido para o ambiente corporativo.
Detalhes técnicos:
- Grouped Query Attention com 8 KV heads;
- RoPE com θ = 10 000 000;
- SwiGLU no MLP;
- RMSNorm com ε = 1e-5;
- embeddings de entrada e saída não compartilhados;
- precisão bfloat16.
Os tamanhos se diferenciam assim: o 3B tem 40 camadas e embeddings de 2560; o 8B tem as mesmas 40 camadas, mas embeddings de 4096; o 30B tem 64 camadas e tamanho oculto do MLP de 32 768.
Na tabela de arquitetura publicada, o comprimento de sequência indicado é de 131 072 tokens, ou seja, 128K. Ao mesmo tempo, o pré-treinamento consistiu em cinco fases e incluiu uma etapa de contexto longo de até 512K tokens. O treinamento do zero foi feito com cerca de 15 trilhões de tokens.
Treinamento: SFT e depois RL em várias etapas
A etapa de supervised fine-tuning baseou-se em cerca de 7,2 milhões de amostras — aproximadamente 100 bilhões de tokens, dos quais cerca de 65 bilhões são treináveis. A mistura de dados se distribui assim: 31,6% de exemplos agênticos contra 68,4% de não agênticos, sendo que engenharia de software responde por 69% da parte agêntica.
As trajetórias foram coletadas em harnesses — entre eles OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex e Goose. A qualidade foi filtrada de duas formas: GPT-OSS-120B e Gemma 4 atuaram como juízes, além de deduplicação por SHA-256 nos campos tools e messages.
O pós-treinamento não é um único passo, mas uma cadeia de RL em vários ambientes. Cada etapa é uma execução assíncrona separada de GRPO, que faz warm-start a partir do checkpoint anterior; em vez de uma value network, usa-se uma linha de base leave-one-out, e a amostragem de importância truncada limita o desvio em off-policy. A ordem é: primeiro RLVR, depois skill boosters, em seguida SWE, Terminal e Search, e, no final, RLHF.
Aqui está a limitação mais importante do lançamento: o bloco de RL agêntico foi aplicado apenas ao 8B e ao 30B. O 3B menor passa apenas pelo RL básico e pelo alinhamento — e é isso que explica em grande parte a diferença de capacidades entre os tamanhos. O treinamento foi feito com NeMo-RL e NeMo-Gym em um cluster NVIDIA GB200 NVL72 hospedado na CoreWeave. Além disso, o pipeline incluiu 1 trilhão de tokens de código sintético do CodeAlchemy e uma camada de decodificação especulativa para acelerar o atendimento.
O que as métricas da IBM mostram
Os números são declarados pela própria IBM, então devem ser lidos como referência, não como verificação independente. A ordem dos valores é 3B / 8B / 30B:
- SWE-Bench Verified: sem avaliação para o 3B; 47.6 para o 8B e 57.00 para o 30B;
- Terminal-Bench 2.1: 20.56 e 29.24, respectivamente;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38.
Um detalhe curioso — no teste de chamada de funções, o 8B fica ligeiramente atrás do 3B (50.29 contra 52.41). É um lembrete de que o tamanho por si só não garante vantagem em cada habilidade isolada, e escolher o modelo para a tarefa importa mais do que perseguir o checkpoint maior.
Fala: 470 milhões de parâmetros sem backbone de LLM
Os modelos de fala Granite Speech 5.0 Turbo CTC funcionam de maneira fundamentalmente diferente dos sistemas ASR habituais baseados em modelos de linguagem: aqui não se usa backbone de LLM, e a conversão de áudio em texto é feita via connectionist temporal classification. Daí a compactação — 470 milhões de parâmetros.
A IBM afirma um RTFx de cerca de 12 600 em uma única H200, enquanto os atuais líderes de velocidade no Open ASR leaderboard mostram cerca de 6 000. Para contact centers com grandes volumes de gravações, a diferença de throughput se converte diretamente em dinheiro. É possível testar o modelo em uma demonstração no WebGPU.
Em resumo
A IBM montou um produto previsível para o mercado corporativo: modelos densos sem exotismo arquitetural, licença aberta, implantação no próprio hardware e modos de raciocínio para diferentes tipos de tarefa. As capacidades agênticas estão concentradas no 8B e no 30B, então faz sentido enxergar o 3B como um ponto de entrada barato e um modelo para cenários simples, e não como um "irmão menor" sem perdas. Vale conferir os detalhes no blog do IBM Research, na descrição técnica e no repositório no GitHub, cujos links são fornecidos junto com o lançamento.