O produto não se reduz a um único ponto no espaço
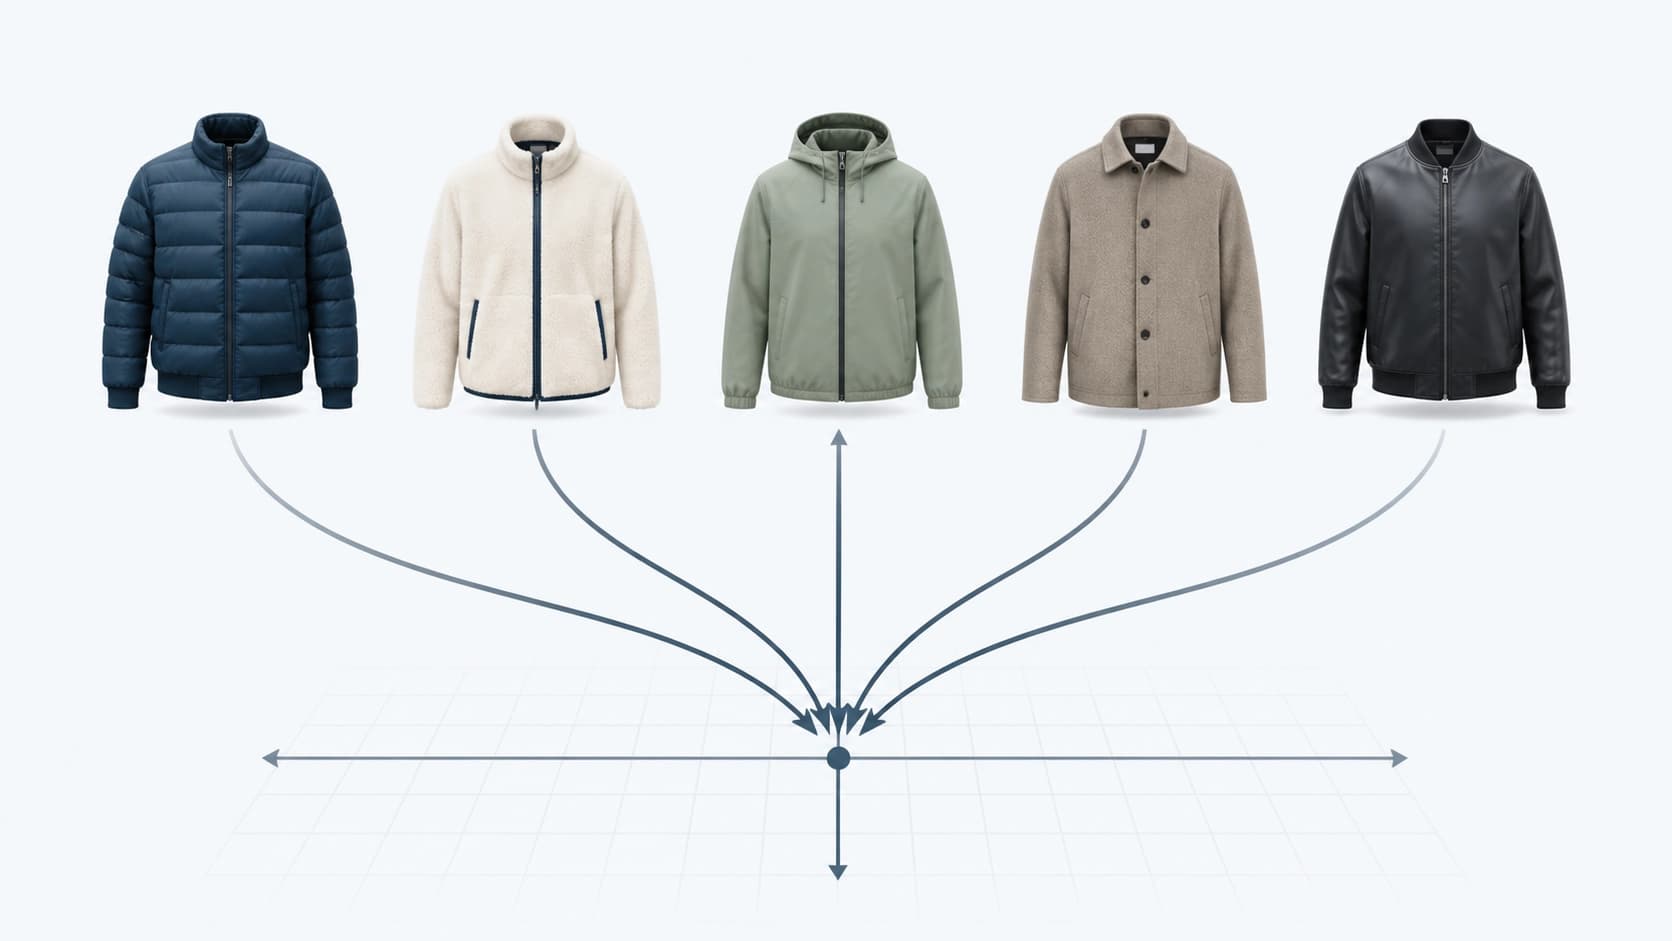
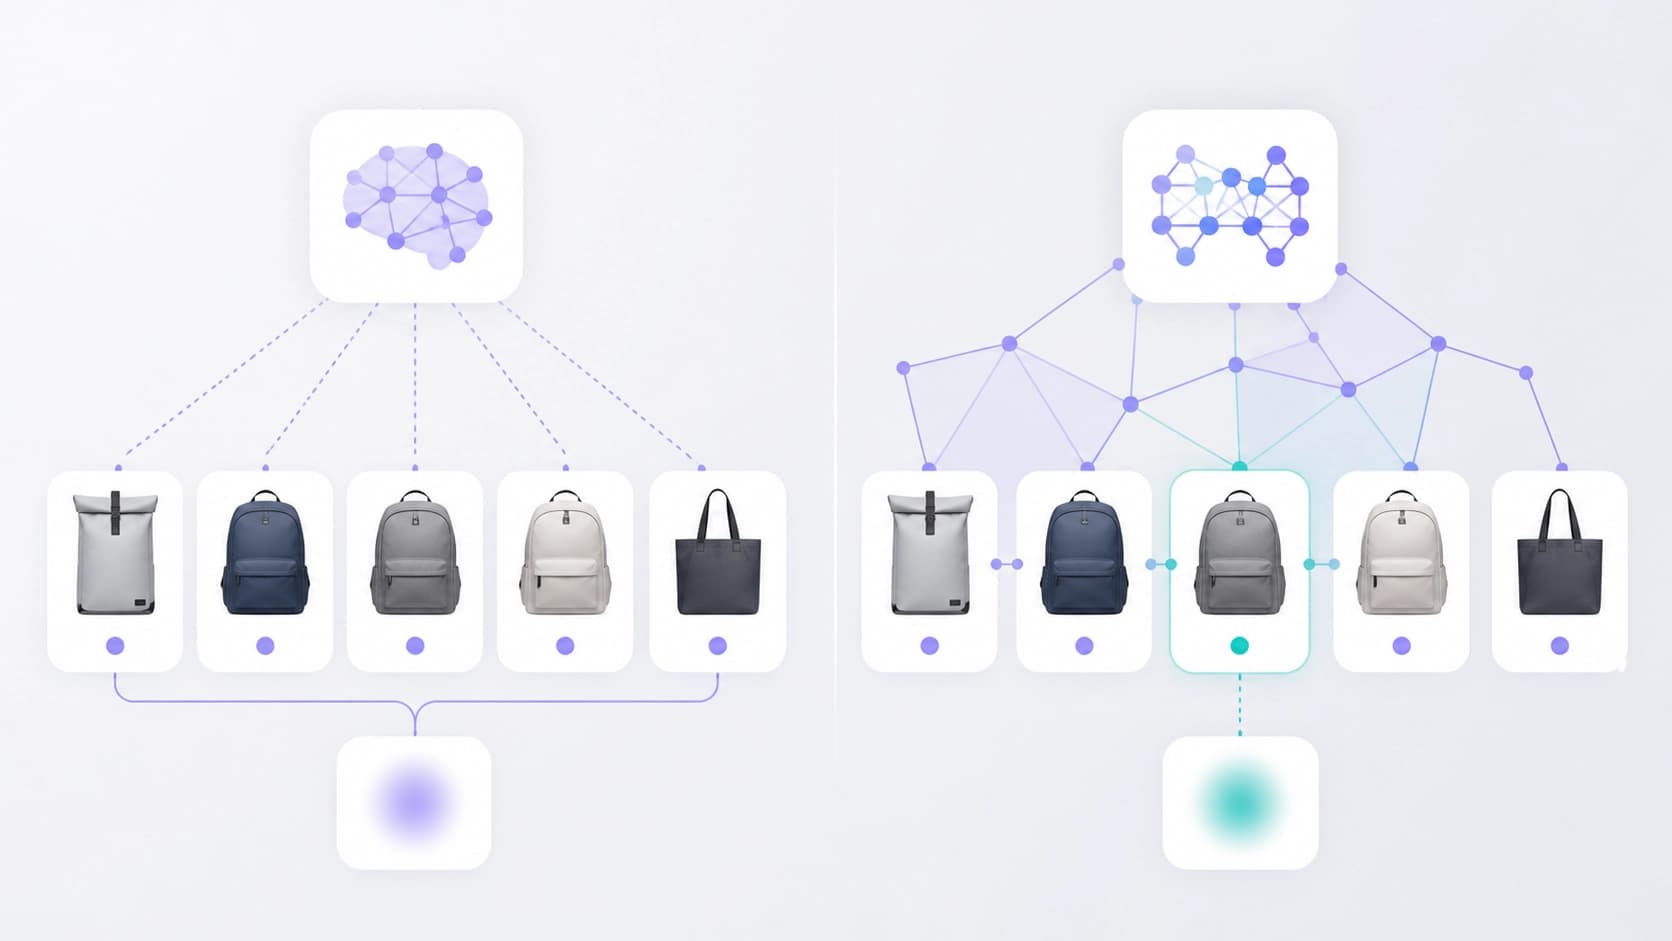
Os modelos de linguagem multimodais de grande porte aprenderam a "entender" razoavelmente bem as fichas de produtos: eles conectam a fotografia, o nome e a descrição em um único campo semântico. Mas esse esquema tem um custo oculto. As informações do produto são comprimidas em um único embedding global — um vetor médio, no qual os detalhes se dissolvem. Quanto mais o modelo tenta abranger tudo de uma vez, menos especificidade resta no vetor final.
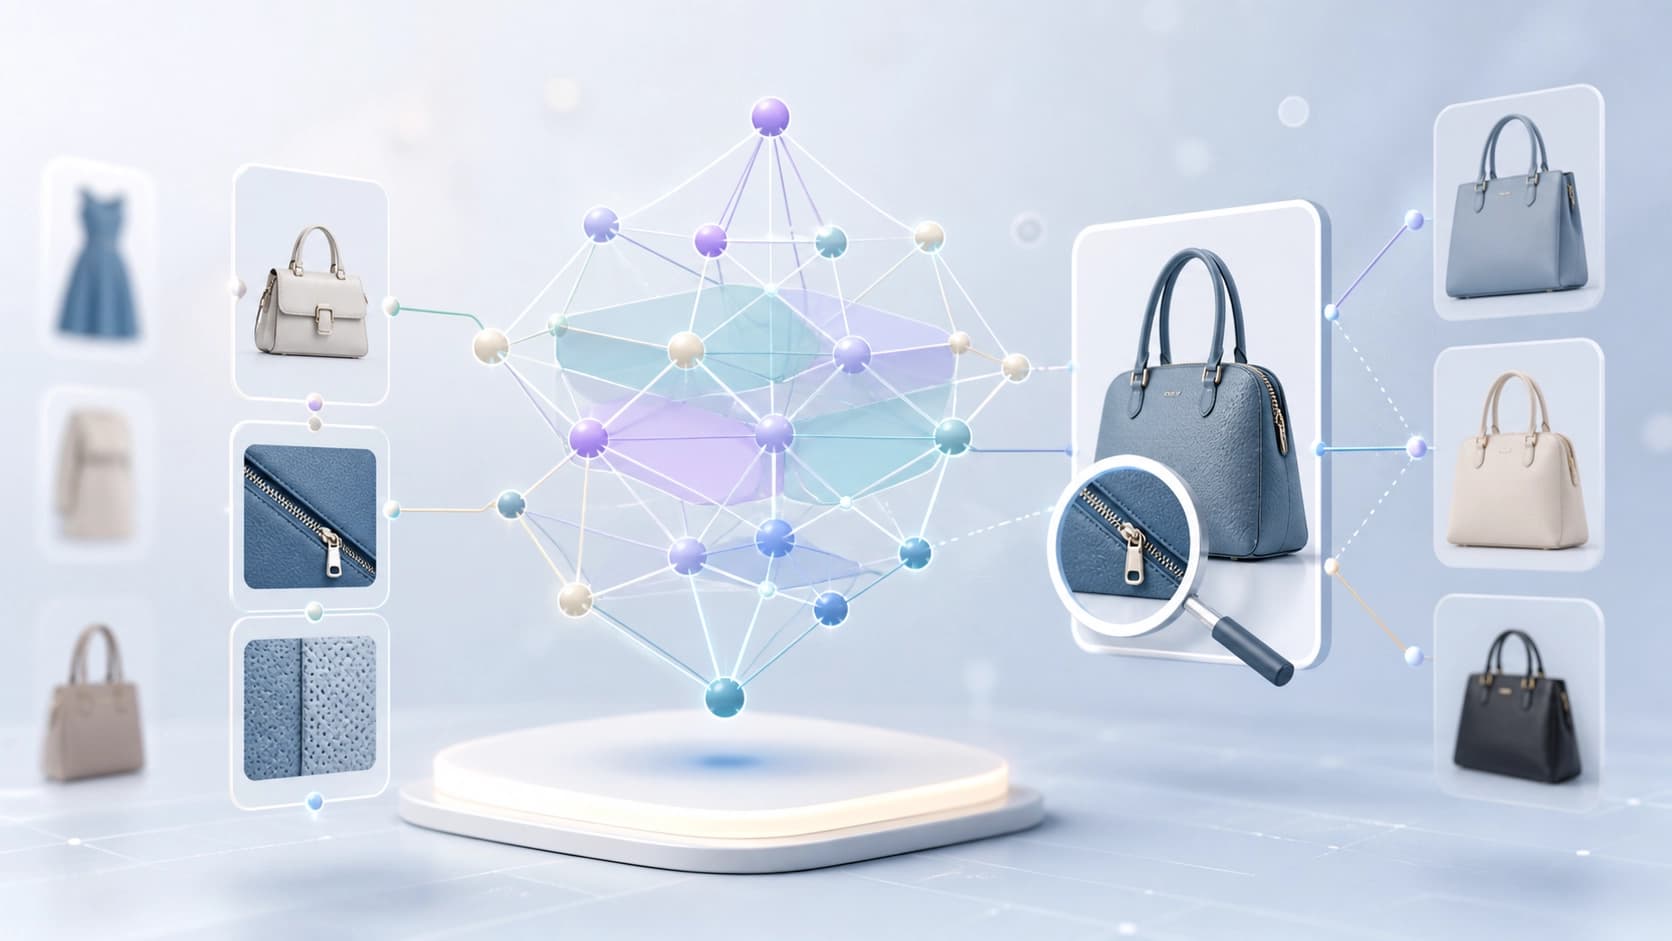
O preço dessa compactação fica visível em tarefas nas quais são justamente os detalhes que importam. Duas jaquetas de materiais diferentes, duas canecas com esmalte quase idêntico, dois cabos com conectores diferentes — visualmente são quase gêmeos e, no espaço de embeddings, acabam quase no mesmo ponto. O usuário, no entanto, não busca "algo parecido", mas sim um material específico, compatibilidade ou uma característica. É justamente nessas consultas que a média começa a atrapalhar: o modelo não distingue os atributos e, portanto, a ordenação também fica aproximada.
O artigo arXiv:2608.24467 (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, agosto de 2026) faz o diagnóstico de forma direta: os embeddings globais codificam implicitamente o produto como um todo, e isso limita a captura de atributos de granularidade fina. Isso se resolve simplesmente "fazendo um vetor maior"? Pela lógica do trabalho — não, o problema não está na dimensionalidade, mas na forma de representação.
Hipergrafo em vez de uma lista plana de embeddings
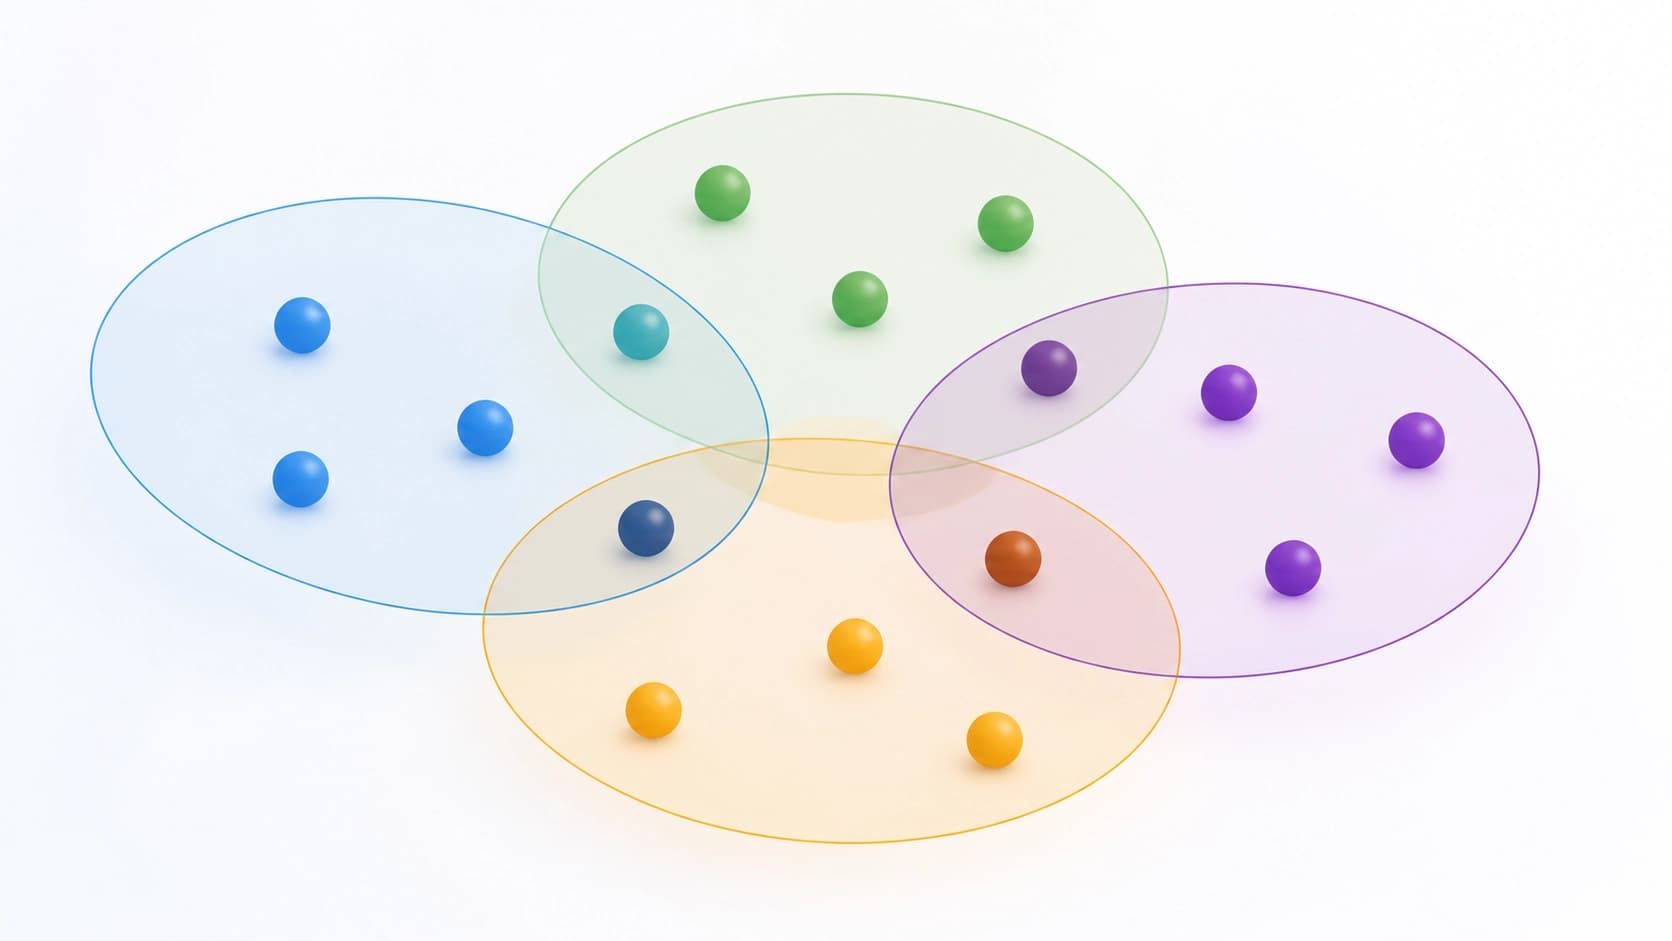
Os autores propõem o HMGCLIP — um framework de embeddings multimodais baseado em um hipergrafo heterogêneo. A diferença em relação ao grafo habitual é fundamental. Uma aresta comum conecta dois objetos; uma hiperaresta conecta um grupo inteiro — por exemplo, todos os produtos de uma categoria, unidos por um atributo comum. Essa construção permite descrever relações que não podem ser decompostas em pares: "estas sete posições são uma mesma linha de materiais", "estas quatro são análogos intercambiáveis".
Em seguida, a topologia do hipergrafo atua em duas direções. Primeiro, dela são extraídos negativos complexos estruturalmente conscientes — aqueles exemplos parecidos, mas incorretos, com os quais o modelo aprende a distinguir. Esse é um ponto importante: os negativos complexos não são escolhidos aleatoriamente do corpus, eles são sugeridos pela própria estrutura das conexões. Segundo, por meio do hipergrafo, a semântica multigranular é harmonizada — tanto no nível das relações quanto no nível das hiperarestas. Em termos simples, o modelo alinha entre si não apenas produtos individuais, mas grupos semânticos inteiros.
Para que serve o mecanismo de inferência de duas granularidades
Um detalhe à parte — a inferência de dupla granularidade (dual-granularity inference). Na saída, o sistema combina dinamicamente as evidências atributivas de modo a operar com a mesma confiança tanto em tarefas de granularidade fina quanto em tarefas de granularidade ampla. O sentido prático é que uma consulta precisa de um nível geral ("mostre tênis"), enquanto outra precisa de um nível extremamente restrito ("tênis com membrana e um tipo específico de solado"). Um modelo voltado apenas para os detalhes perde em amplitude; voltado apenas para o geral, perde em precisão. Aqui, pressupõe-se que o próprio sistema decide em que nível observar.
Conjunto de dados e validação
Os autores não se limitaram à arquitetura: eles lançaram um conjunto de dados abrangente de granularidade fina para comércio eletrônico, para que a tarefa ganhasse um benchmark reproduzível para comparações futuras. Essa é, talvez, uma parte não menos valiosa do trabalho — sem um conjunto de dados público, discutir distinção de granularidade fina é inútil, cada um mede no seu próprio.
Os experimentos foram realizados no novo conjunto de dados e no benchmark público MAVE. O resultado é declarado de forma inequívoca: a abordagem supera encoders multimodais fortes, LLMs multimodais e soluções básicas para comércio eletrônico. Os números concretos e as tabelas estão no próprio trabalho; aqui o importante é a conclusão de que uma abordagem estrutural de representação proporciona um ganho que não se consegue alcançar apenas complicando o modelo.
Onde isso será útil na prática
O primeiro e mais óbvio — a busca e a seleção de análogos. Quando o comprador procura um substituto para um item que parou de funcionar, ele precisa de compatibilidade por atributos, e não de semelhança geral da imagem. O segundo — as recomendações: elas ganham se conseguem distinguir a variante com outro material do mesmo produto em outra configuração. O terceiro — a limpeza do catálogo: duplicatas e quase duplicatas, que hoje são agrupadas pela automação ao acaso, com uma representação de granularidade fina se separam de forma mais significativa.
Há também uma camada menos óbvia — a explicabilidade. As hiperarestas formam uma estrutura pela qual se vê por que os produtos acabaram próximos. Para as equipes que lidam com erros de ordenação, isso é mais útil do que um vetor de natureza incompreensível.
O que ainda permanece em aberto
Qualquer trabalho com estrutura de grafo esbarra no custo: o hipergrafo precisa ser construído e, ao atualizar o catálogo, mantido em estado atualizado. Quão barato isso é em milhões de fichas e com que frequência ele terá de ser reconstruído, os autores não revelam no resumo.
A segunda questão é a portabilidade. O conjunto de dados foi coletado em um único domínio, e não se sabe quão bem o padrão de comportamento das hiperarestas se manterá na transição, digamos, de roupas para eletrônicos, onde os atributos são estruturados de forma completamente diferente. A terceira — como essa abordagem convive com pipelines de produção já em funcionamento: substituir a forma de representação geralmente significa reindexar todo o índice de busca.
De qualquer forma, a direção está claramente delineada. A discussão não é sobre qual modelo é maior, mas sobre como armazenar corretamente o significado do produto: em um único ponto médio ou em uma rede de conexões, onde os detalhes não se dissolvem.