
Método Genesis Steering: direcionamento de ativações com dados usados no ajuste fino
O método extrai um vetor de controle a partir de exemplos contrastivos presentes nos dados de fine-tuning e, quando estes não estão disponíveis, seleciona prováveis amostras de treino através de inferência de membership e cria um conjunto proxy. A parte teórica descreve o desvio ótimo em direção à fronteira de decisão e a avaliação com dados proxy; empiricamente, os dados internos do Tülu-3-8B produzem um efeito mais acentuado do que os conjuntos externos, enquanto a utilidade do proxy MIA no Llama-3.1-8B-Instruct é limitada pela relação entre os desvios de direção.
O que é Genesis Steering
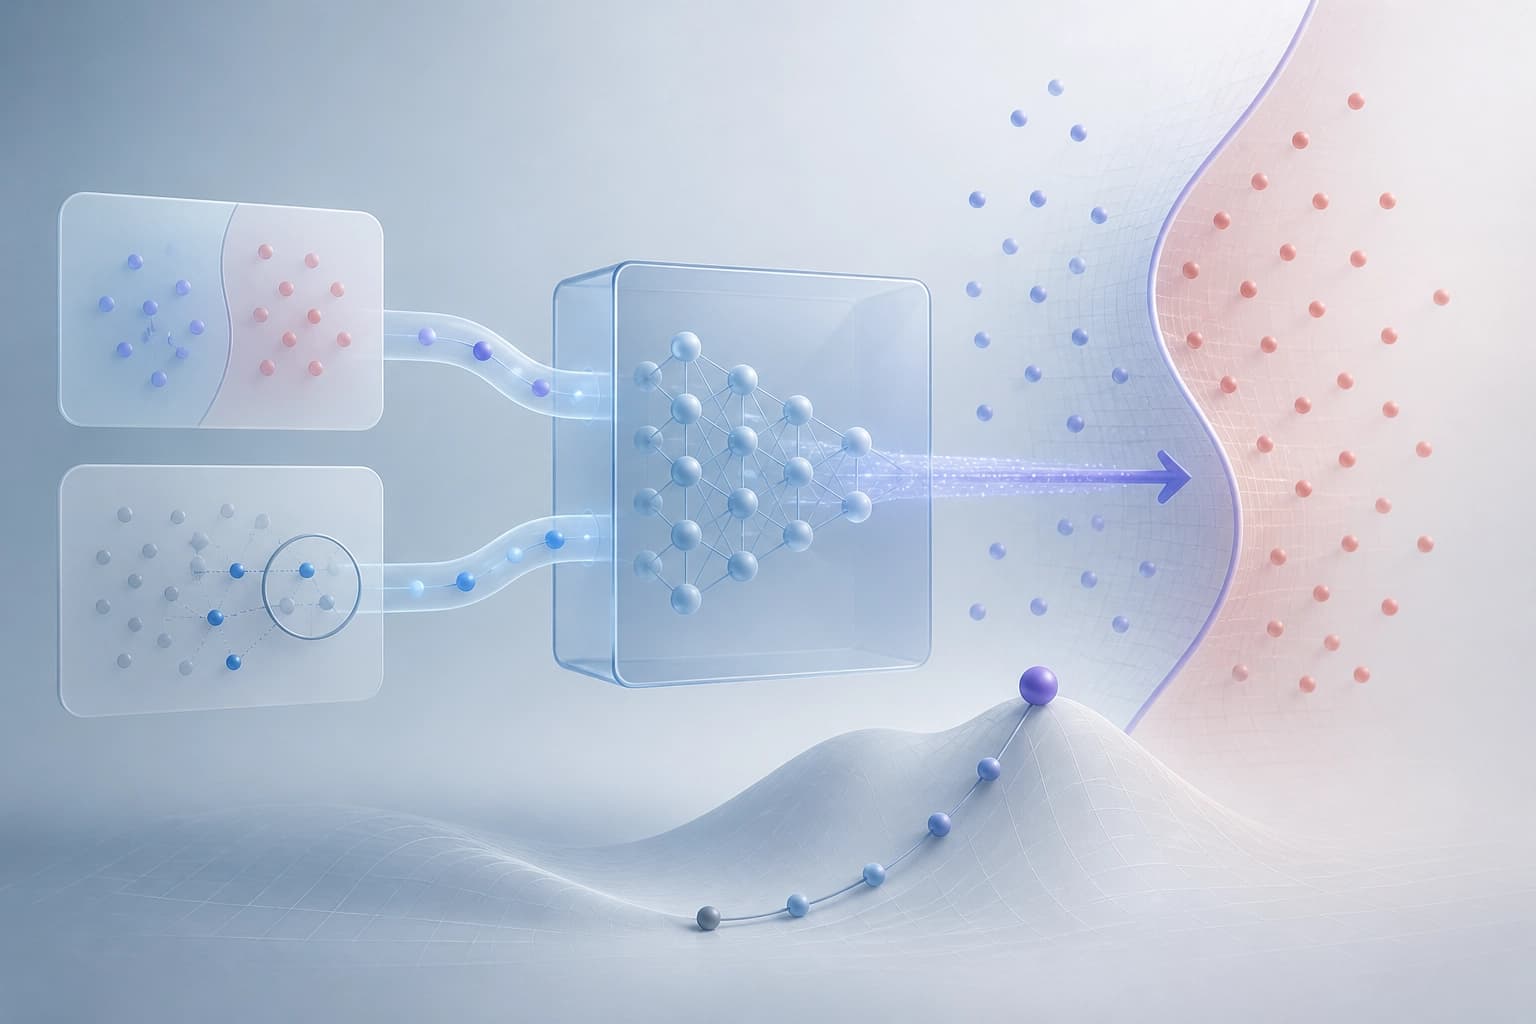
O direcionamento de ativações controla grandes modelos de linguagem durante a inferência. A eficácia do método depende da escolha dos dados de referência. O Genesis Steering constrói um vetor genesis com exemplos contrastivos dos próprios dados de ajuste fino do modelo.
Se esses dados não estiverem disponíveis, o método recorre a abordagens da literatura sobre inferência de pertencimento. Essas abordagens identificam exemplos de treino prováveis e compõem um conjunto de dados proxy.
O artigo «Genesis Steering: Better Activation Steering Through Training Data» foi submetido em 13 de outubro de 2026 (v1). Atualização — 19 de outubro de 2026 (v2). Autores: Tora Bodin, Eric Aubinais, Ilaria Torre, Chih-Hong Cheng.
Conclusão: o Genesis Steering associa o direcionamento aos dados de ajuste fino. O parâmetro fundamental é a origem dos exemplos contrastivos.
Como é construído o vetor genesis
O método usa exemplos contrastivos dos dados de ajuste fino. Com base neles, constrói-se um vetor de direção. Esse vetor é aplicado ao modelo durante a inferência.
Os autores estabelecem dois resultados teóricos. O primeiro diz respeito ao deslocamento ideal em direção à fronteira de decisão. O segundo, à redução do viés na avaliação com dados proxy.
Conclusão: a teoria define orientações para o deslocamento. A qualidade do vetor depende da escolha dos exemplos contrastivos.
Dados proxy através da inferência de pertencimento
Quando os dados de ajuste fino não estão disponíveis, o método recorre à inferência de pertencimento. Esta abordagem procura exemplos de treino prováveis. Os exemplos encontrados são usados para compor um conjunto de dados proxy.
O conjunto de dados proxy substitui os dados originais na construção do vetor genesis. O método usa os exemplos encontrados como referência. A diferença está na origem dos exemplos.
Conclusão: o conjunto de dados proxy amplia a aplicabilidade do método. O critério para usá-lo é não ter acesso aos dados de ajuste fino.
O que as avaliações dos modelos revelaram
As avaliações foram realizadas nos modelos Tülu-3-8B e Llama-3.1-8B-Instruct. Os dados de ajuste fino do Tülu-3-8B estão disponíveis publicamente. O Llama-3.1-8B-Instruct foi usado como modelo de controlo.
Os dados de segurança da mistura de treino do Tülu-3-8B proporcionaram um direcionamento mais forte do que os conjuntos de dados externos. Isso foi observado em ambos os modelos.
No Tülu-3-8B, as avaliações de pertencimento coincidiram em grande medida na identificação dos exemplos de treino. Os vetores construídos com os exemplos com as pontuações mais altas produziram resultados comparáveis aos de subamostras aleatórias do mesmo tamanho.
Os resultados no Llama-3.1-8B-Instruct estabelecem uma condição para a MIA. O método só produzirá um efeito positivo se o deslocamento médio da direção dos dados intradomínio filtrados pela MIA for significativamente inferior ao deslocamento dos dados OoD.
Conclusão: os próprios dados de ajuste fino proporcionam um direcionamento mais forte do que os conjuntos de dados externos. A MIA exige verificar a condição relativa ao deslocamento da direção.
Critérios práticos de escolha
A escolha do método depende do acesso aos dados de ajuste fino. A tabela abaixo relaciona a situação, a ação e a verificação.
| Situação | Ação | Verificação |
|---|---|---|
| Os dados de ajuste fino estão disponíveis | Construção do vetor genesis com exemplos contrastivos desses dados | Comparação com conjuntos de dados externos |
| Os dados não estão disponíveis | Procura de exemplos de treino prováveis através da inferência de pertencimento e criação de um conjunto de dados proxy | Verificação da condição relativa ao deslocamento médio da direção |
| O conjunto de dados proxy foi criado | Construção de vetores com os exemplos com as pontuações mais altas | Comparação com subamostras aleatórias do mesmo tamanho |
Conclusão: o Genesis Steering é escolhido em função da disponibilidade dos dados de ajuste fino. Para o conjunto de dados proxy, verifica-se a condição relativa ao deslocamento e comparam-se os resultados com os de subamostras aleatórias.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Aprendizagem em contexto para dados tabulares com especialistas esparsos: a compacta OrionMoE-Small-v1.0
É apresentado um modelo base compacto para tarefas tabulares, que prevê novas observações a partir de uma tabela de referência rotulada, sem ajustar parâmetros. A seleção adaptativa de especialistas, tendo em conta o conjunto de dados e as representações das características, produz resultados competitivos, sobretudo com pouco contexto e elevada dimensionalidade.
15 novembro 2026
Busca local de deslocamentos de covariáveis para perfis com previsões não confiáveis
O artigo descreve um pipeline de diagnóstico que primeiro identifica grupos interpretáveis de pacientes para os quais o modelo apresenta baixa confiança e, em seguida, verifica a presença de um deslocamento prejudicial de covariáveis dentro desses grupos. Em experimentos com o MIMIC-IV, três tarefas clínicas e três deslocamentos artificiais de subgrupos, a abordagem ajudou a localizar um deslocamento relacionado à idade, pouco perceptível na avaliação agregada.
15 novembro 2026
FedPix: transmissão de imagens comprimidas do cliente para reduzir o vazamento no aprendizado federado
O artigo analisa que informações devem ser permitidas ao cliente enviar ao servidor e propõe treinar o envio de imagens compactas e visualmente verificáveis, em vez de pesos do modelo ou representações intermediárias. Em BloodMNIST, CIFAR-10, FashionMNIST e MNIST, a abordagem apresenta baixo PSNR na reconstrução e reduz o tempo no cliente em até 96,0%, com uma precisão de 65,63–99,18%.
15 novembro 2026