
Aprendizagem em contexto para dados tabulares com especialistas esparsos: a compacta OrionMoE-Small-v1.0
É apresentado um modelo base compacto para tarefas tabulares, que prevê novas observações a partir de uma tabela de referência rotulada, sem ajustar parâmetros. A seleção adaptativa de especialistas, tendo em conta o conjunto de dados e as representações das características, produz resultados competitivos, sobretudo com pouco contexto e elevada dimensionalidade.
Aprendizagem tabular em contexto: essência do regime
O modelo prevê observações não vistas com base numa tabela de suporte anotada. O modelo não atualiza os parâmetros para uma tarefa específica. O artigo descreve o OrionMoE-Small-v1.0 — um modelo-base tabular compacto para aprendizagem em contexto.
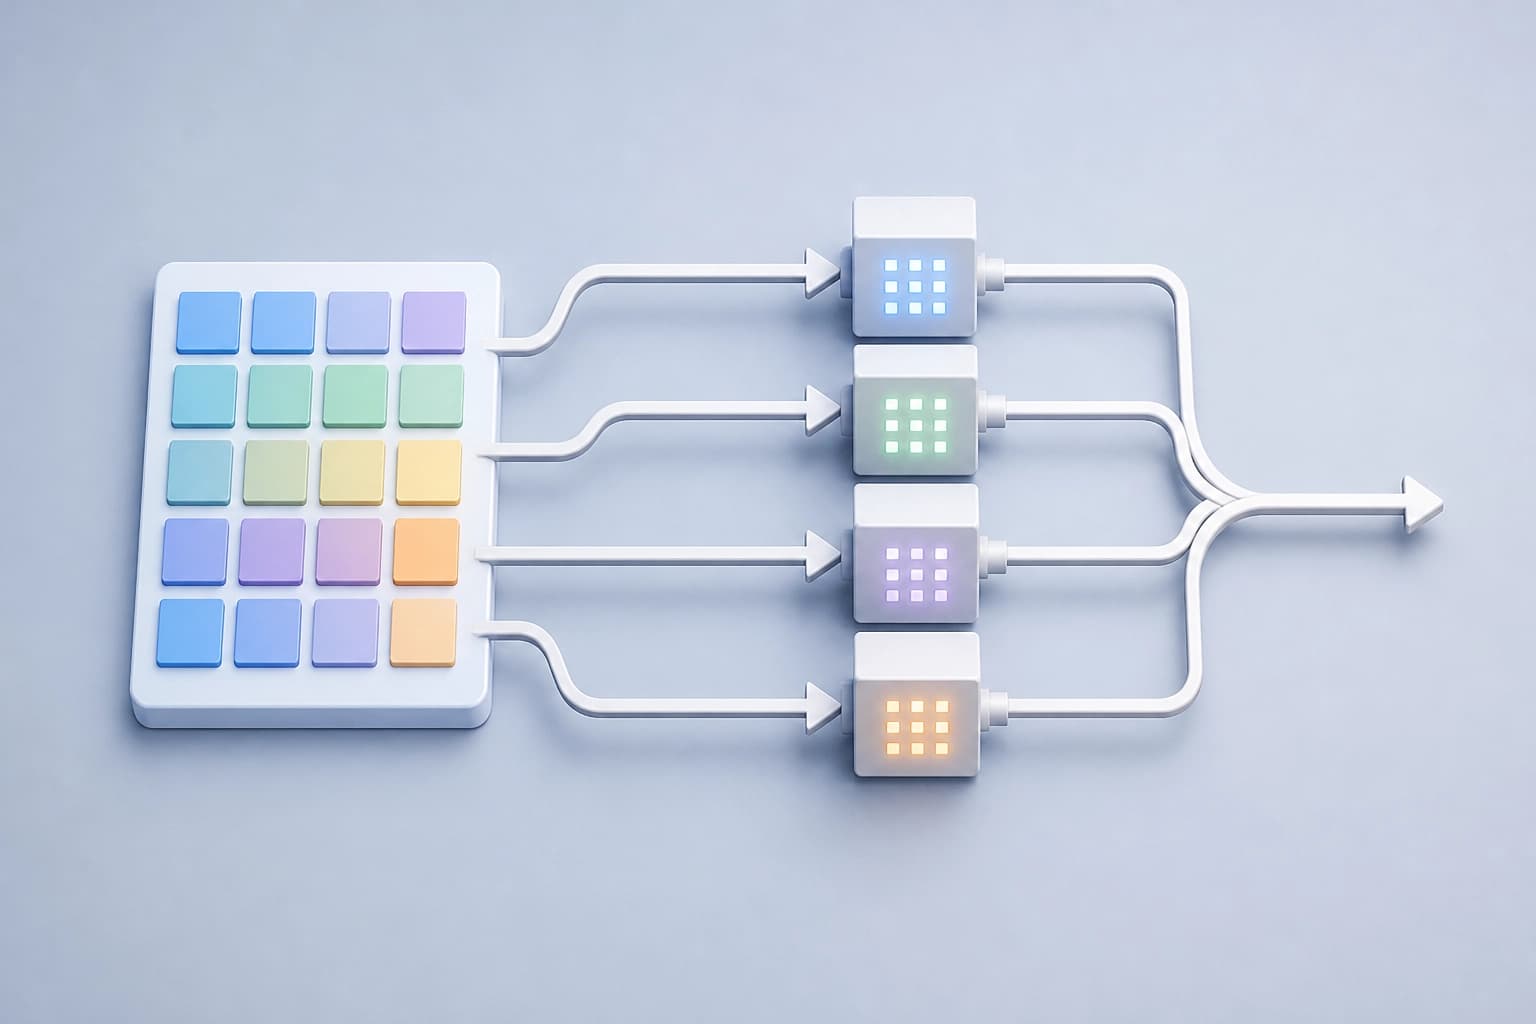
Elementos-chave do regime:
- entrada — uma tabela de suporte anotada;
- objetivo — prever observações não vistas;
- adaptação — sem atualização dos parâmetros para uma tarefa específica;
- regime — aprendizagem em contexto.
Critério prático: a tarefa permite fazer previsões com base numa tabela de suporte anotada. Não é necessária uma adaptação à tarefa por gradiente.
Arquitetura: transformer de eixo duplo e especialistas esparsos
O OrionMoE-Small-v1.0 assenta numa arquitetura de transformer de eixo duplo. O modelo combina representações que têm em conta a distribuição dos dados com computação esparsa de mistura de especialistas. Esta computação é condicionada pelo conjunto de dados. A seleção dos especialistas ativados tem em conta as representações de células individuais e o contexto do conjunto completo.
Estrutura do modelo:
- arquitetura — transformer de eixo duplo;
- representações — com consideração pela distribuição dos dados;
- computação — mistura esparsa de especialistas, condicionada pelo conjunto de dados;
- seleção de especialistas — com base nas representações das células e no contexto do conjunto;
- distribuição da computação — adaptativa entre tarefas tabulares heterogéneas;
- percurso de computação — comum a diferentes tarefas.
Critério prático: as tarefas tabulares heterogéneas exigem uma distribuição adaptativa da computação. O modelo mantém um percurso de computação comum para diferentes tarefas.
Treino: tarefas de classificação sintéticas
O modelo foi pré-treinado exclusivamente em tarefas de classificação sintéticas. Estas tarefas assentam numa distribuição prévia causal estruturada. Para tarefas subsequentes, o modelo faz previsões sem adaptação por gradiente. A anotação indica o nome OrionMoE-Small-v1.0.
Autores do artigo: Mohamed Bouadi, Nassim Bouarour, Aditya Tanna, Vinay Kumar Sankarapu. Os autores submeteram o artigo a 14 de outubro de 2026. A última revisão foi publicada a 18 de outubro de 2026. A versão do artigo é a v2.
O que se sabe sobre o treino:
- dados — exclusivamente tarefas de classificação sintéticas;
- base — uma distribuição prévia causal estruturada;
- tarefas subsequentes — sem adaptação por gradiente.
Critério prático: a fonte descreve o pré-treino apenas em tarefas de classificação sintéticas. Não são apresentados dados sobre outros tipos de tarefas.
Resultados e critérios de aplicação
O OrionMoE-Small-v1.0 apresentou resultados competitivos em vários benchmarks tabulares. A comparação foi feita com modelos-base substancialmente maiores. A análise destacou resultados especialmente fortes em conjuntos de dados com contexto reduzido e elevada dimensionalidade. Uma análise adicional revelou resultados relativos favoráveis perante o desequilíbrio de classes.
| Cenário | O que a análise revelou |
|---|---|
| Comparação com modelos-base substancialmente maiores | resultados competitivos |
| Contexto reduzido e elevada dimensionalidade | resultados especialmente fortes |
| Desequilíbrio de classes | resultados relativos favoráveis |
| Composição de características | a análise destacou a sua importância |
Critério prático: contexto reduzido e elevada dimensionalidade são condições em que os resultados são especialmente fortes. O desequilíbrio de classes e a composição de características são pontos de análise distintos.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Reparação limitada de táticas em Lean 4 com base no diagnóstico do compilador
É proposto um módulo passo a passo que, em vez de descartar uma tática rejeitada, pede ao modelo de correção que a corrija até R vezes, tendo em conta o erro do Lean; com K candidatos, isso aumenta a proporção de problemas resolvidos. As experiências no LeanDojo e no Lean Workbook mostram ganhos sobretudo graças a falhas de execução pouco profundas, à custa de um aumento do tempo de pesquisa.
16 novembro 2026
Método Genesis Steering: direcionamento de ativações com dados usados no ajuste fino
O método extrai um vetor de controle a partir de exemplos contrastivos presentes nos dados de fine-tuning e, quando estes não estão disponíveis, seleciona prováveis amostras de treino através de inferência de membership e cria um conjunto proxy. A parte teórica descreve o desvio ótimo em direção à fronteira de decisão e a avaliação com dados proxy; empiricamente, os dados internos do Tülu-3-8B produzem um efeito mais acentuado do que os conjuntos externos, enquanto a utilidade do proxy MIA no Llama-3.1-8B-Instruct é limitada pela relação entre os desvios de direção.
16 novembro 2026
Busca local de deslocamentos de covariáveis para perfis com previsões não confiáveis
O artigo descreve um pipeline de diagnóstico que primeiro identifica grupos interpretáveis de pacientes para os quais o modelo apresenta baixa confiança e, em seguida, verifica a presença de um deslocamento prejudicial de covariáveis dentro desses grupos. Em experimentos com o MIMIC-IV, três tarefas clínicas e três deslocamentos artificiais de subgrupos, a abordagem ajudou a localizar um deslocamento relacionado à idade, pouco perceptível na avaliação agregada.
15 novembro 2026