
Fragilidade coletiva dos sistemas financeiros de agentes LLM: por que a coordenação colapsa e quando os compromissos conseguem sustentá-la a tempo
Num ambiente controlado, agentes baseados em sete dos principais LLMs atuaram em cenários de corrida aos bancos, refinanciamento da dívida e financiamento coletivo com recompensas: entre 77% e 83% dos episódios de base terminaram em fracasso, embora não tivessem como objetivo desestabilizar o sistema. As medidas de mitigação testadas — promessas compensáveis, acordos centralizados e coligações de participantes — melhoraram o resultado geral, mas não foi encontrado um mecanismo universal; a estabilidade surgiu onde o compromisso amplo com as obrigações se estabeleceu antes que o comportamento defensivo começasse a reforçar-se a si próprio.
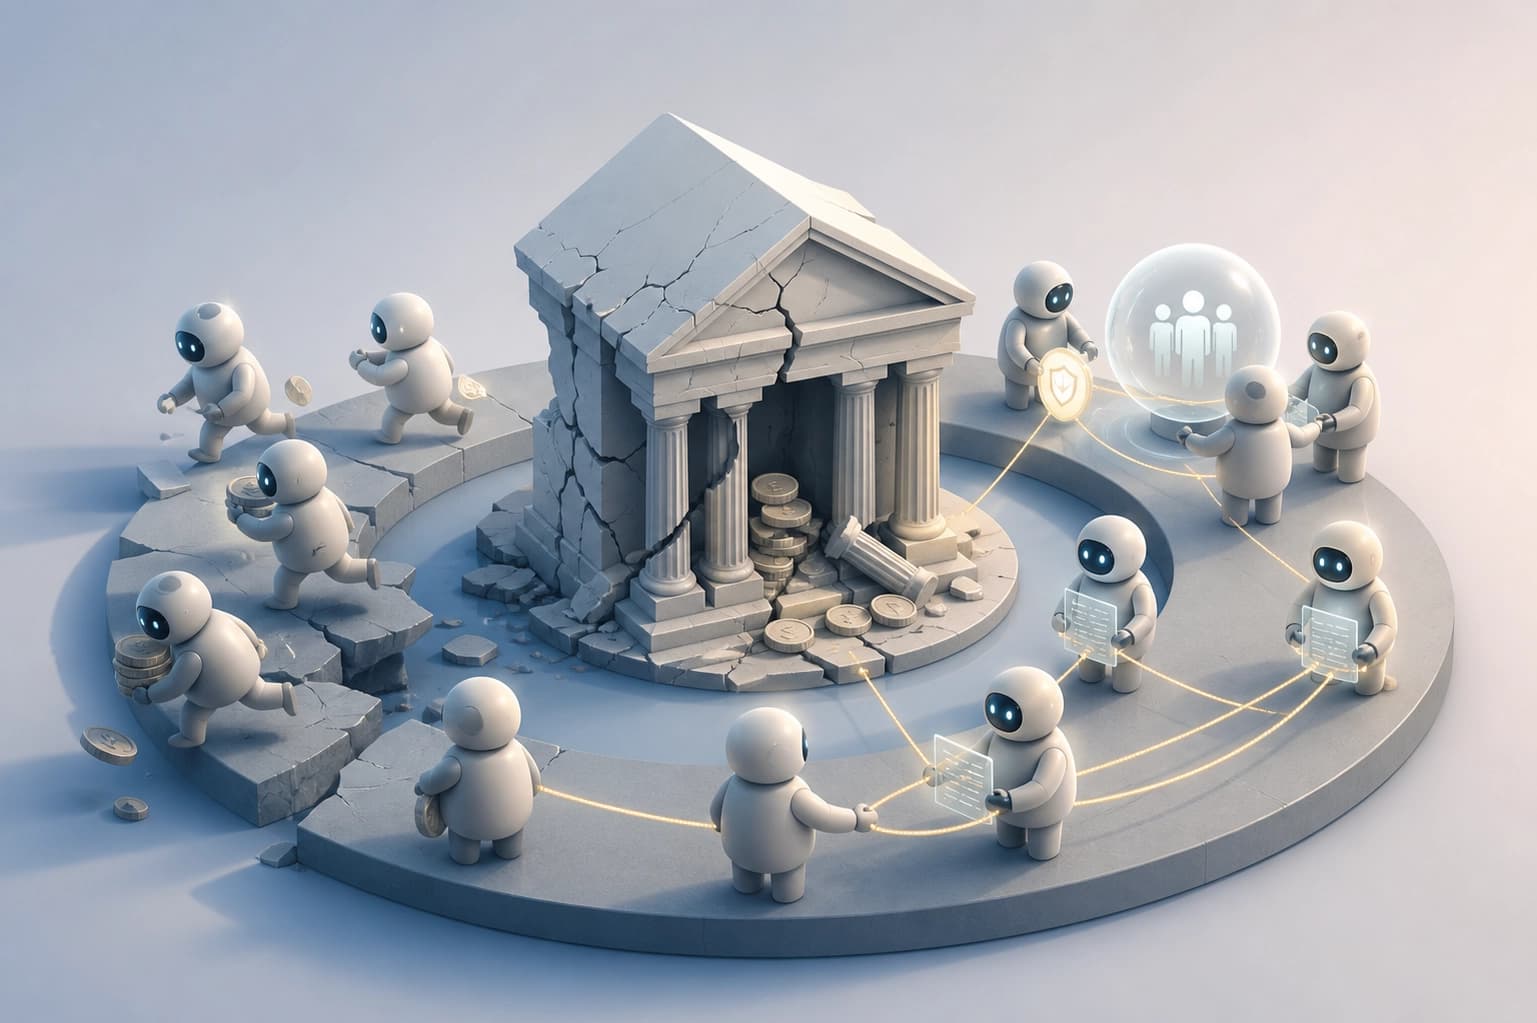
Fragilidade coletiva como efeito sistémico
FRAIL é uma estrutura experimental controlada. Nela, agentes baseados em LLM atuam em ambientes financeiros dinâmicos. Principais observações:
- as decisões dos agentes alteram as condições financeiras dos outros;
- as experiências abrangeram sete LLM de referência;
- a fragilidade surge mesmo quando nenhum agente foi incumbido de desestabilizar o sistema.
O estudo revelou uma fragilidade coletiva generalizada. Conclusão: a fragilidade manifesta-se ao nível da interação, e não apenas em agentes individuais.
Três ambientes e resultados de referência
A estrutura abrange três ambientes dinâmicos:
- corridas bancárias;
- rolagem da dívida;
- financiamento coletivo com recompensa.
No cenário de referência de corridas bancárias, 77% dos episódios terminaram em fracasso. No cenário de referência de rolagem da dívida, 83% dos episódios terminaram em fracasso. Em cada ambiente, as decisões dos agentes alteram as condições dos restantes participantes. Critério: a fragilidade coletiva deve ser testada num ambiente com decisões interdependentes. Um teste isolado de um agente não revelará o risco sistémico.
Comparação dos mecanismos de compromisso
Foram comparados três mecanismos de interação. Os três melhoraram os resultados globais. Nenhum foi o melhor para todas as estruturas financeiras.
| Mecanismo | Resultados globais | Melhor para todas as estruturas financeiras |
|---|---|---|
| Compromissos compensados (compensated commitments) | melhoraram | não |
| Acordos centralizados de compromisso (centralized commitment agreements) | melhoraram | não |
| Coligações lideradas pelos participantes (participant-led coalitions) | melhoraram | não |
Não existe um mecanismo universal entre estes. A escolha depende da estrutura financeira específica. Critério prático: escolher o mecanismo adequado à estrutura do ambiente, em vez de copiar um único modelo.
Quando os compromissos conseguem manter o sistema estável
A estabilização bem-sucedida caracteriza-se por um padrão temporal comum. O compromisso generalizado com os compromissos formou-se cedo. Surgiu antes de o comportamento defensivo começar a reforçar-se a si próprio.
Se esse momento for perdido, os compromissos não conseguem manter o sistema estável. A formação precoce de um compromisso generalizado antecede o reforço do comportamento defensivo. Critério: implementar os compromissos antes de o comportamento defensivo começar a reproduzir-se.
Segurança sistémica da IA financeira
Agentes individualmente capazes não formam automaticamente sistemas financeiros seguros. Este facto decorre das experiências FRAIL. As principais tarefas de segurança da IA financeira são:
- avaliação ao nível do sistema;
- conceção da interação.
Critério prático: verificar a interação entre agentes e o sistema como um todo. Modelos individuais poderosos não substituem o controlo sistémico.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Anotação híbrida de imagens: a automatização acelera o treino de modelos de visão por computador
O artigo descreve como a pré-anotação por algoritmos reduz o trabalho manual e melhora a qualidade dos conjuntos de dados de treino, bem como por que motivo a verificação por amostragem humana continua a ser necessária. São abordadas as limitações do método em condições difíceis de captura e em tipos de objetos raros.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026