
Método CHOIR: a enumeração livre revela posições divergentes dos modelos dentro de sistemas coletivos
Os autores propõem a abordagem CHOIR, na qual conjuntos solicitam repetidamente listas ordenadas de respostas e, em seguida, comparam a proeminência de conceitos agrupados entre modelos, formulações de prompts e condições de papel. O trabalho mostra que uma elevada semelhança externa entre respostas abertas não significa necessariamente que haja consenso: a identidade do modelo subjacente continua a ser o fator de distinção mais estável, enquanto as configurações de persona deslocam os conceitos manifestados.
O que o CHOIR oferece
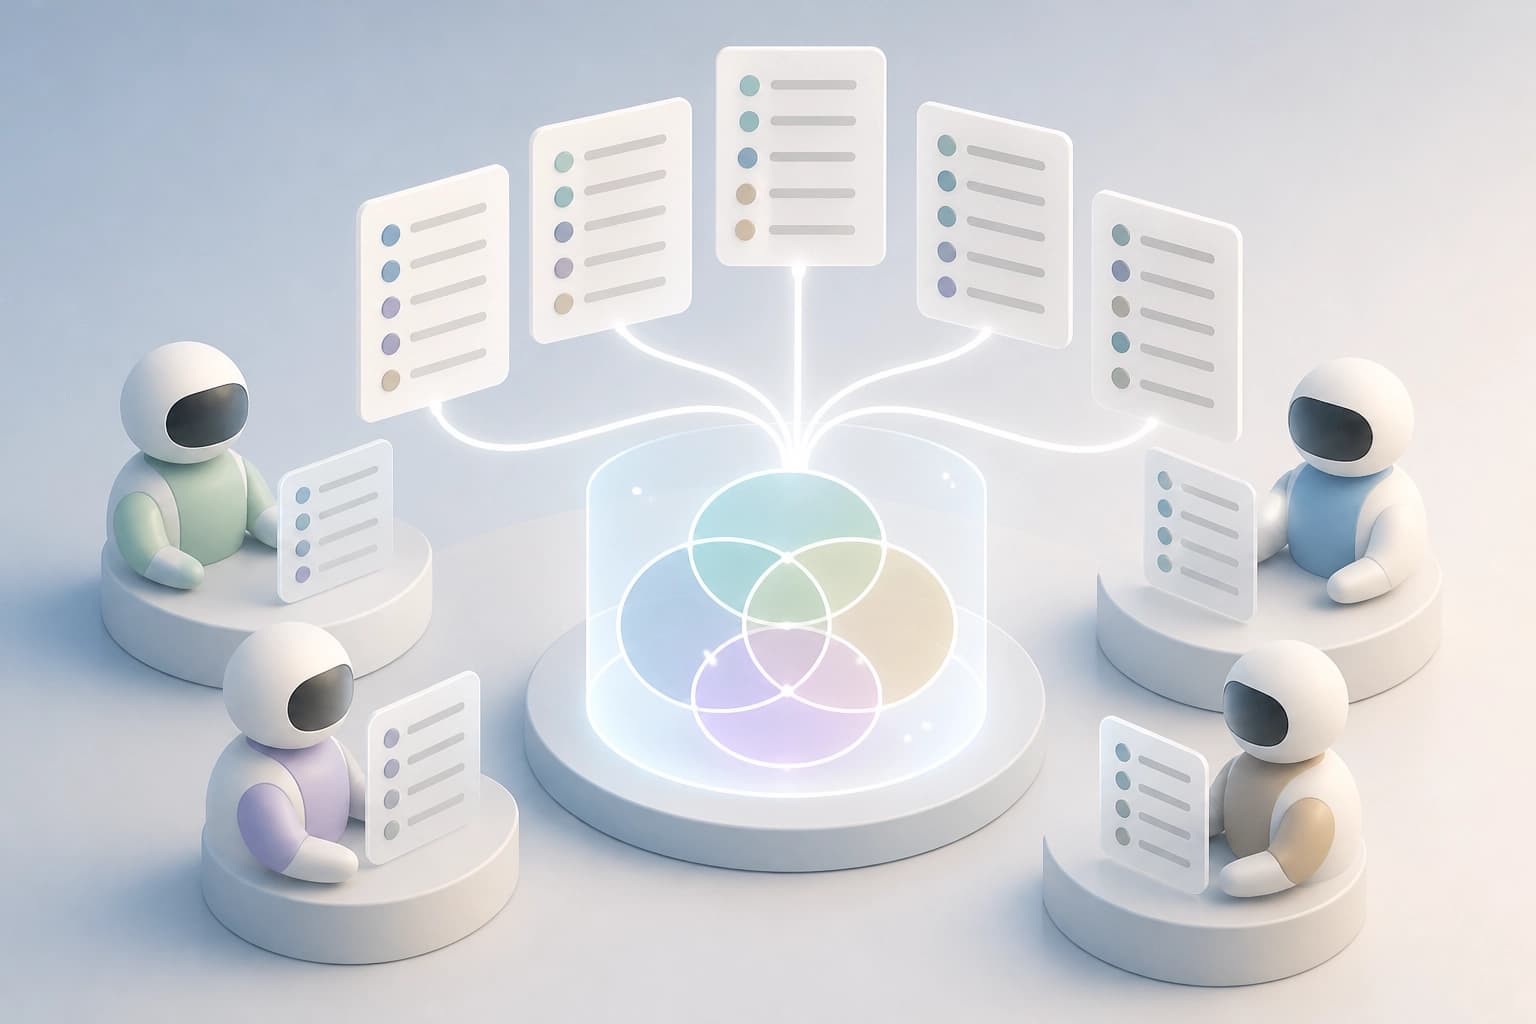
CHOIR é a sigla de Collective Hierarchically-Ordered Inquiry Responses. A abordagem adapta a elicitação por lista livre a ensembles de LLMs. O seu objetivo é revelar os pontos em que os modelos do ensemble divergem. A concordância superficial entre as respostas oculta essas divergências.
O método trabalha com listas, e não com formulações prontas. Consultas repetidas permitem recolher material sobre os temas que os próprios modelos levantam. Depois, esse material é normalizado para permitir a comparação.
Critério prático: recorrer ao CHOIR quando as respostas do ensemble parecem iguais, mas é preciso perceber exatamente em que pontos os modelos divergem.
Etapas do método
O método assenta em três etapas.
- Consultas repetidas aos modelos do ensemble para obter listas ordenadas.
- Agrupamento dos elementos das listas em conceitos ao nível do prompt.
- Medição da saliência dos conceitos entre modelos, variantes de prompts e condições com personas.
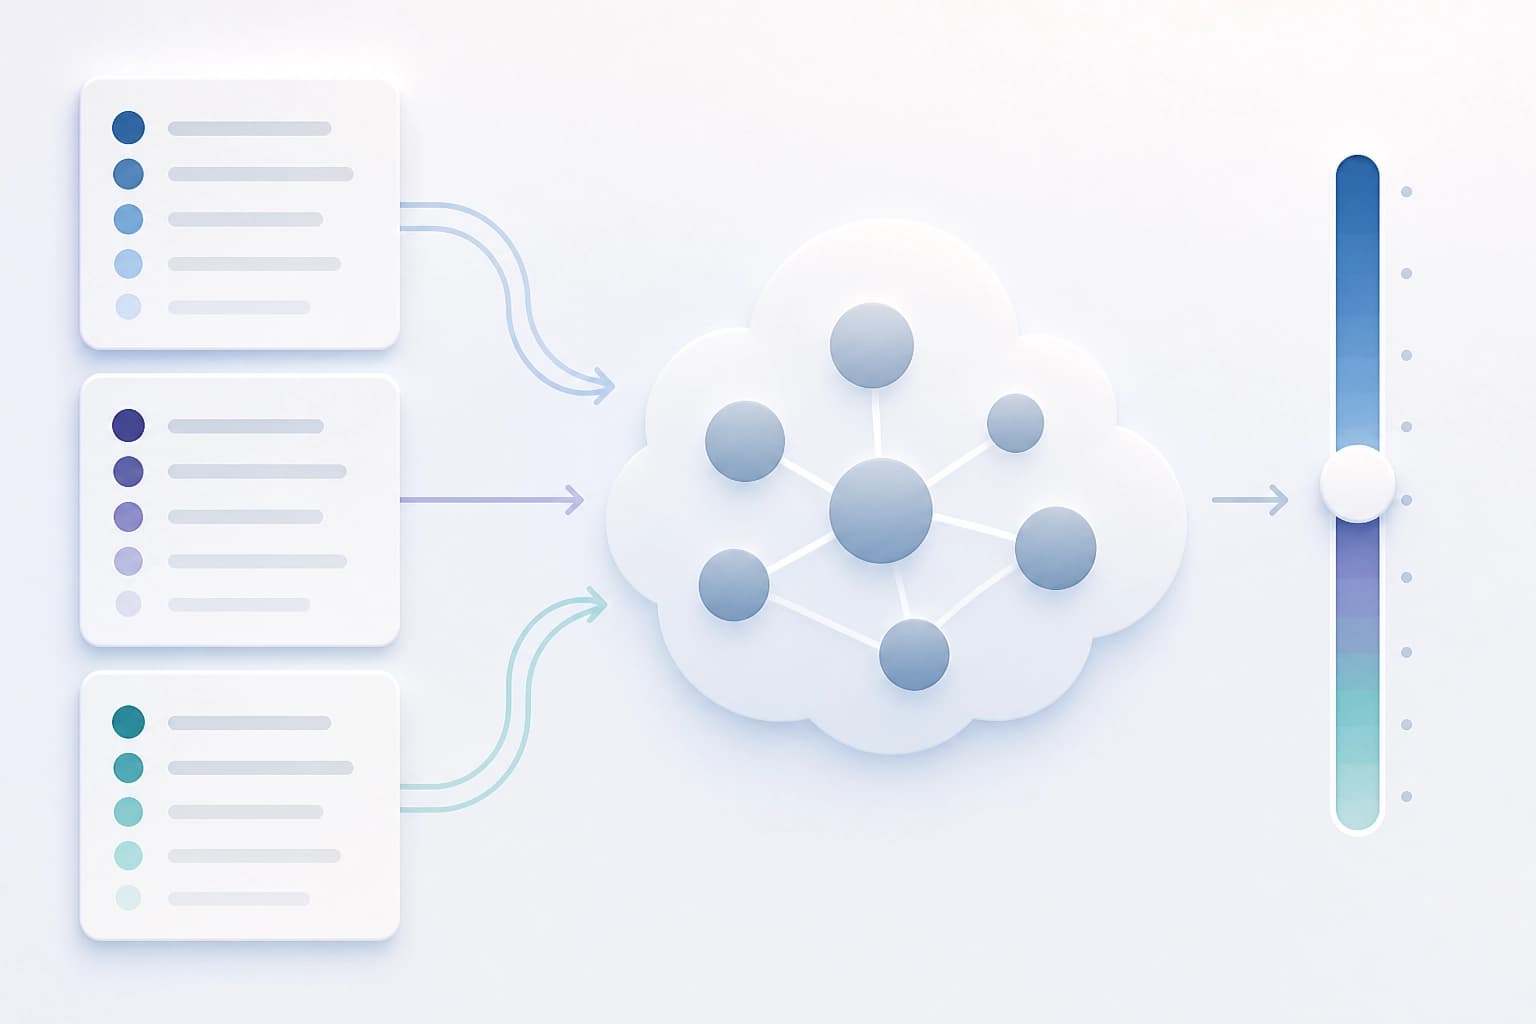
Cada etapa acrescenta uma dimensão. As listas fornecem o material em bruto, o agrupamento normaliza-o para permitir a comparação e a medição da saliência revela as diferenças. Sem a agregação em conceitos, a comparação continua ao nível de palavras isoladas.
Critério prático: avaliar se o método preserva as diferenças depois de agrupar os elementos em conceitos.
Em que conjuntos foi testado
| Conjunto | O que é | O que revelou |
|---|---|---|
| Infinity-Chat 100 | Conjunto externo de prompts de um trabalho recente sobre a homogeneidade das respostas abertas dos modelos | Reproduz uma elevada concordância superficial: 93/100 prompts acima do nível aleatório. Distingue prompts estreitos de prompts amplos, nos quais se revela uma profundidade oculta nas respostas |
| Conjunto de diagnóstico direcionado | 27 perguntas destinadas a identificar diferenças ao nível dos mecanismos | Serve para verificar de forma direcionada as divergências entre modelos |
Os conjuntos têm objetivos diferentes. O conjunto externo mostra o panorama geral da concordância e, ao mesmo tempo, distingue prompts amplos de prompts estreitos. O conjunto direcionado foi concebido para identificar diferenças ao nível dos mecanismos.
Critério de escolha: usar o conjunto externo de prompts para obter um panorama da concordância e o conjunto de diagnóstico para analisar os mecanismos.
Que sinais de diferenças são visíveis
As observações dividem-se em três grupos.
- A identidade do modelo de base continua a ser o sinal mais forte que pode ser recuperado. Isto é válido tanto para as verificações direcionadas como para o conjunto externo de prompts.
- Os prompts com personas alteram os conceitos que se manifestam nas assinaturas dos modelos de base.
- Um módulo de classificação que desconhece a origem identifica candidatos raros, mas estáveis, para análise posterior.
As personas alteram a manifestação dos conceitos, mas não se sobrepõem ao sinal do modelo de base. A classificação sem conhecimento da origem funciona como um filtro para análise posterior.
Critério prático: identificar primeiro o modelo de base e, depois, avaliar o efeito da persona.
Um enquadramento de diagnóstico em vez da constatação de concordância
Os autores propõem encarar a homogeneidade das respostas abertas como um problema de diagnóstico. A pergunta passa então a ser outra: em que pontos os modelos convergem, porque convergem e o que mais é possível descobrir.
- Onde convergem — mapa dos conceitos coincidentes entre modelos.
- Porque convergem — motivos por trás da concordância superficial.
- O que mais é visível — candidatos identificados pela classificação sem conhecimento da origem.
O artigo foi publicado nos Proceedings of the Third Conference on Language Modeling (COLM 2026), em 2026. Foi submetido ao arXiv em 29 de setembro de 2026. Os autores são Ben Wigler e Maria Tsfasman.
Critério: a homogeneidade das respostas não é uma conclusão final, mas o ponto de partida para diagnosticar a profundidade.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Avaliação de agentes de programação no desenvolvimento XR interativo: resultados do GenXR-Bench
Foi publicado o GenXR-Bench, um conjunto de 112 tarefas especializadas para avaliar de ponta a ponta agentes de programação no desenvolvimento interativo de XR: desde o aprimoramento de funcionalidades e a correção de defeitos até a criação de aplicações com verificação do comportamento em dispositivos de consumo. Entre os dez modelos testados, o melhor resultado foi de 50,9% no Pass@1; entre as falhas recorrentes estão o processamento de eventos assíncronos de sensores, a ancoragem de objetos no espaço real e a compreensão das interações em contextos físicos.
5 novembro 2026
Da recompensa escalar à fronteira de Pareto: síntese de RTL com aprendizagem por reforço multiobjetivo
É proposto um método para treinar um modelo de linguagem a gerar não apenas um esquema, mas um conjunto de candidatos RTL com diferentes compromissos entre área, latência e consumo de energia; a recompensa é calculada com base na contribuição de cada variante para o hipervolume da fronteira de Pareto. No RTLLM v2, o hipervolume relativo aumentou 13,3 p.p. em relação à versão de base sem otimização de PPA e 14,4 p.p. em relação ao treinamento por reforço com um único objetivo.
5 novembro 2026
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026