
CEG-Agent: análise causal de falhas em traces de agentes LLM por meio de grafos de erros
O trabalho propõe o CEG-Agent, um framework de ferramentas para o diagnóstico causal de traces de agentes. A classificação formal distingue anomalias, erros e falhas, e os grafos CEG tipados ligam eventos de execução a nós de diagnóstico e falhas finais; o benchmark CEG-Bench confirma a liderança da abordagem em precisão semântica e estrutural.
Onde falha o diagnóstico de rastros de agentes
Aplicações complexas recorrem a agentes baseados em LLM. Os rastros desses agentes são longos. Isso dificulta o diagnóstico de falhas.
Os métodos de diagnóstico existentes misturam anomalias, erros e falhas. Por isso, os objetivos do diagnóstico tornam-se ambíguos.
Os métodos não modelam de forma estruturada como os erros causalmente relevantes se propagam e se amplificam. As falhas finais das tarefas ficam sem uma atribuição fiável.
Critério prático: um método de diagnóstico deve distinguir os tipos de desvios e rastrear as relações causais entre eles.
O que é o CEG-Agent
O CEG-Agent é um framework de agentes que utiliza ferramentas. Executa o diagnóstico causal de rastros de agentes.
O framework introduz uma taxonomia explícita de anomalias, erros e falhas. Com base nela, constrói Causal Error Graphs (CEGs).
| Abordagem | Distinção entre anomalias, erros e falhas | Modelo de propagação de erros |
|---|---|---|
| Métodos de diagnóstico existentes | Misturam estes conceitos | Não modelam de forma estruturada |
| CEG-Agent | Introduz uma taxonomia explícita | Constrói CEGs com relações causais |
Critério de escolha: o framework deve fornecer objetivos de diagnóstico inequívocos e basear-se num modelo de causas tipificado.
Causal Error Graphs: uma representação tipificada das causas
Os CEGs são uma representação tipificada unificada. Ligam os elementos do rastro através de relações causais.
O grafo inclui três tipos de elementos:
- eventos de execução;
- nós de diagnóstico;
- resultados sob a forma de falhas.
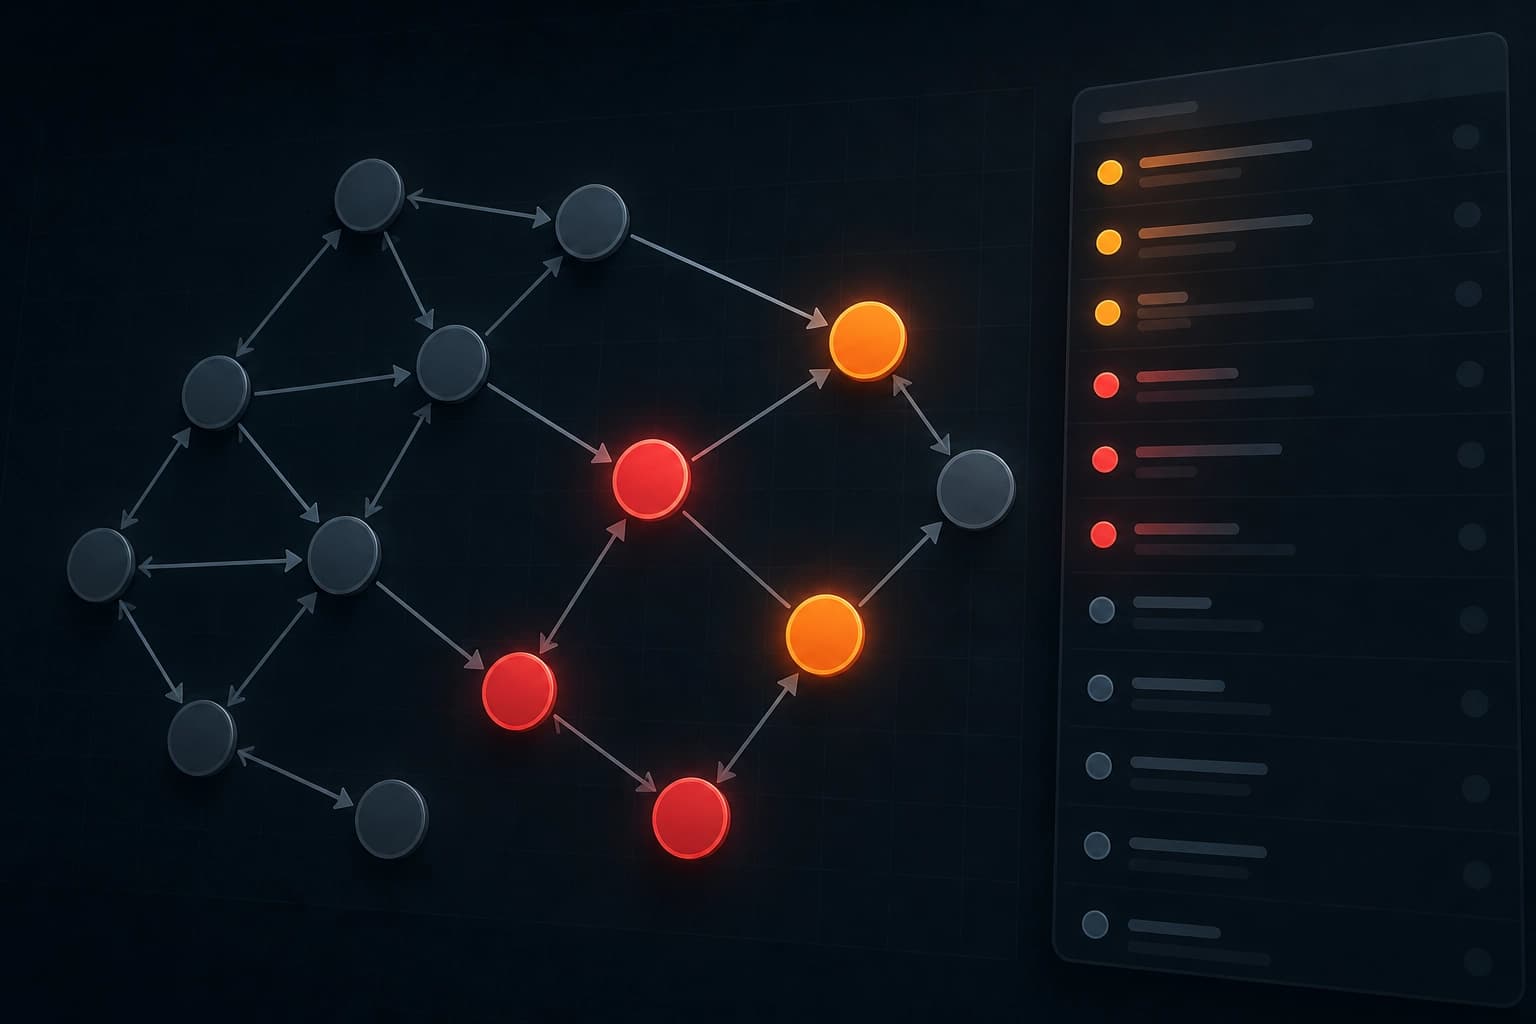
Todos os elementos estão ligados por relações causais num formato unificado. É isso que distingue o grafo de um conjunto de sinais dispersos.
Critério: a representação deve ligar o percurso de execução à falha final através de relações causais explícitas.
CEG-Bench e anotação através do AAAP
Foi criado o CEG-Bench para avaliar o diagnóstico causal de rastros. Trata-se de um benchmark com anotação realizada inteiramente por agentes.
As anotações CEG do benchmark foram obtidas através do Adversarial Agentic Adjudication Protocol (AAAP). As anotações são altamente fiáveis e consistentes.
As anotações foram verificadas com base num conjunto de referência elaborado por especialistas. As anotações automáticas demonstraram uma elevada correspondência com as dos especialistas.
Critério: um benchmark com anotações verificadas com base num conjunto de referência humano é adequado para comparar métodos de diagnóstico causal.
Resultados e critério de escolha
Nas experiências com o CEG-Bench, o CEG-Agent alcança resultados de estado da arte. A avaliação foi feita segundo dois critérios.
O primeiro critério é uma avaliação semanticamente relaxada. O segundo é uma avaliação estruturalmente rigorosa. O framework alcança resultados de estado da arte em ambos.
Critério de escolha: se a tarefa exigir correção semântica e estrutural na análise, um método com resultados deste nível serve de referência.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Os LLM médicos sabem que as recomendações foram revistas, mas muitas vezes respondem de acordo com as regras anteriores
Um estudo da ChronoEvo sobre 1709 alterações às recomendações clínicas mostra que, no modelo principal, 90,8% das respostas assinalavam a novidade, mas apenas 58,5% a aplicavam na íntegra, e a diferença de 32,3 pontos percentuais persistia em 14 modelos. Mesmo aumentar a visibilidade das atualizações não trouxe um aumento significativo da incorporação integral das novas regras nas recomendações clínicas.
4 novembro 2026
Modelo de mundo para agentes em LLMs proprietários: correção nos pontos de risco
É proposto o PAWM — um preditor externo que não duplica a observação passo a passo, mas é acionado quando há probabilidade de falha e afasta o agente de uma ação errada. Após SFT em cenários sintéticos e co-treinamento GRPO, o método apresentou um aumento de 24,3% no ScienceWorld e de 7,7% no WebArena-Lite para o Claude Sonnet 4.5.
4 novembro 2026
Camada de classificação sobre o SpeechLLM: onde supera a geração de rótulos no reconhecimento de emoções
Com base nos conjuntos de dados IEMOCAP e MELD, comparam-se a geração de rótulos emocionais e um classificador linear aplicado às representações ocultas de uma SpeechLLM compacta. O ganho de desempenho do classificador não é universal: depende do corpus e de serem usadas transcrições de referência ou resultados de ASR.
4 novembro 2026