O que a simulação avalia
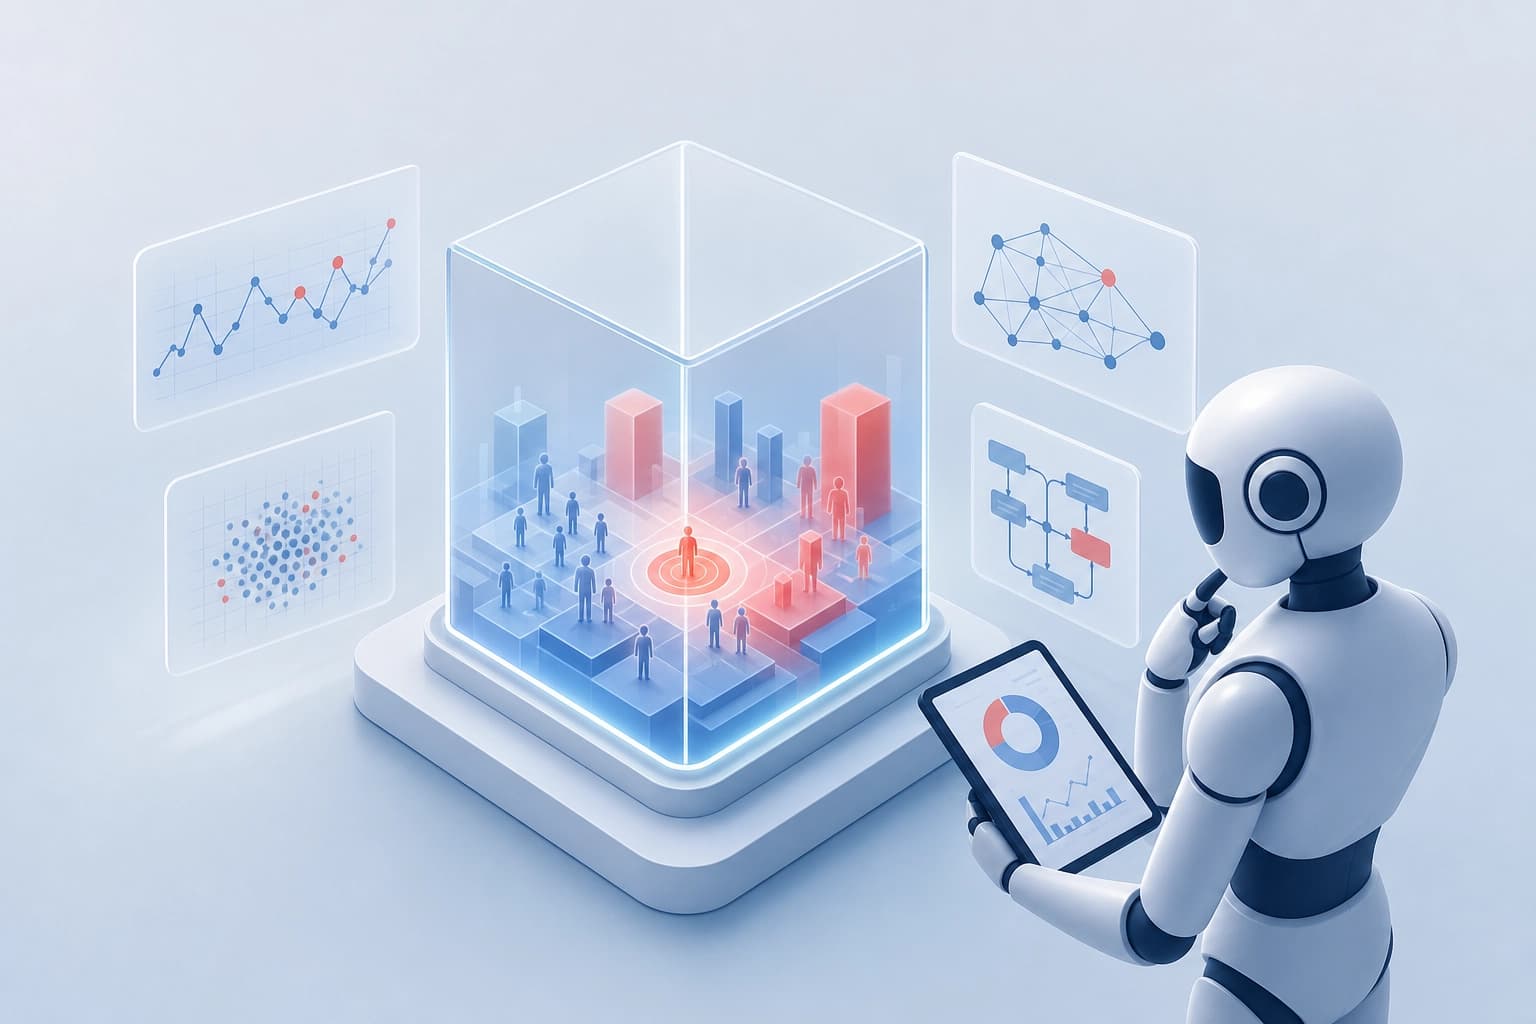
TRACE é um ambiente de diagnóstico para publicidade digital. Abrange 12 causas-raiz e atribuição detalhada de segmentos. Em cada episódio, o agente explora os dados com Python e SQL. Em seguida, identifica a causa-raiz e, quando aplicável, o segmento afetado.
TRACE é descrita num trabalho de Rui Sun, Zhan Shi e Bing He, submetido ao arXiv em 9 de setembro de 2026. O identificador do trabalho é arXiv:2609.10315.
Como a avaliação é estruturada
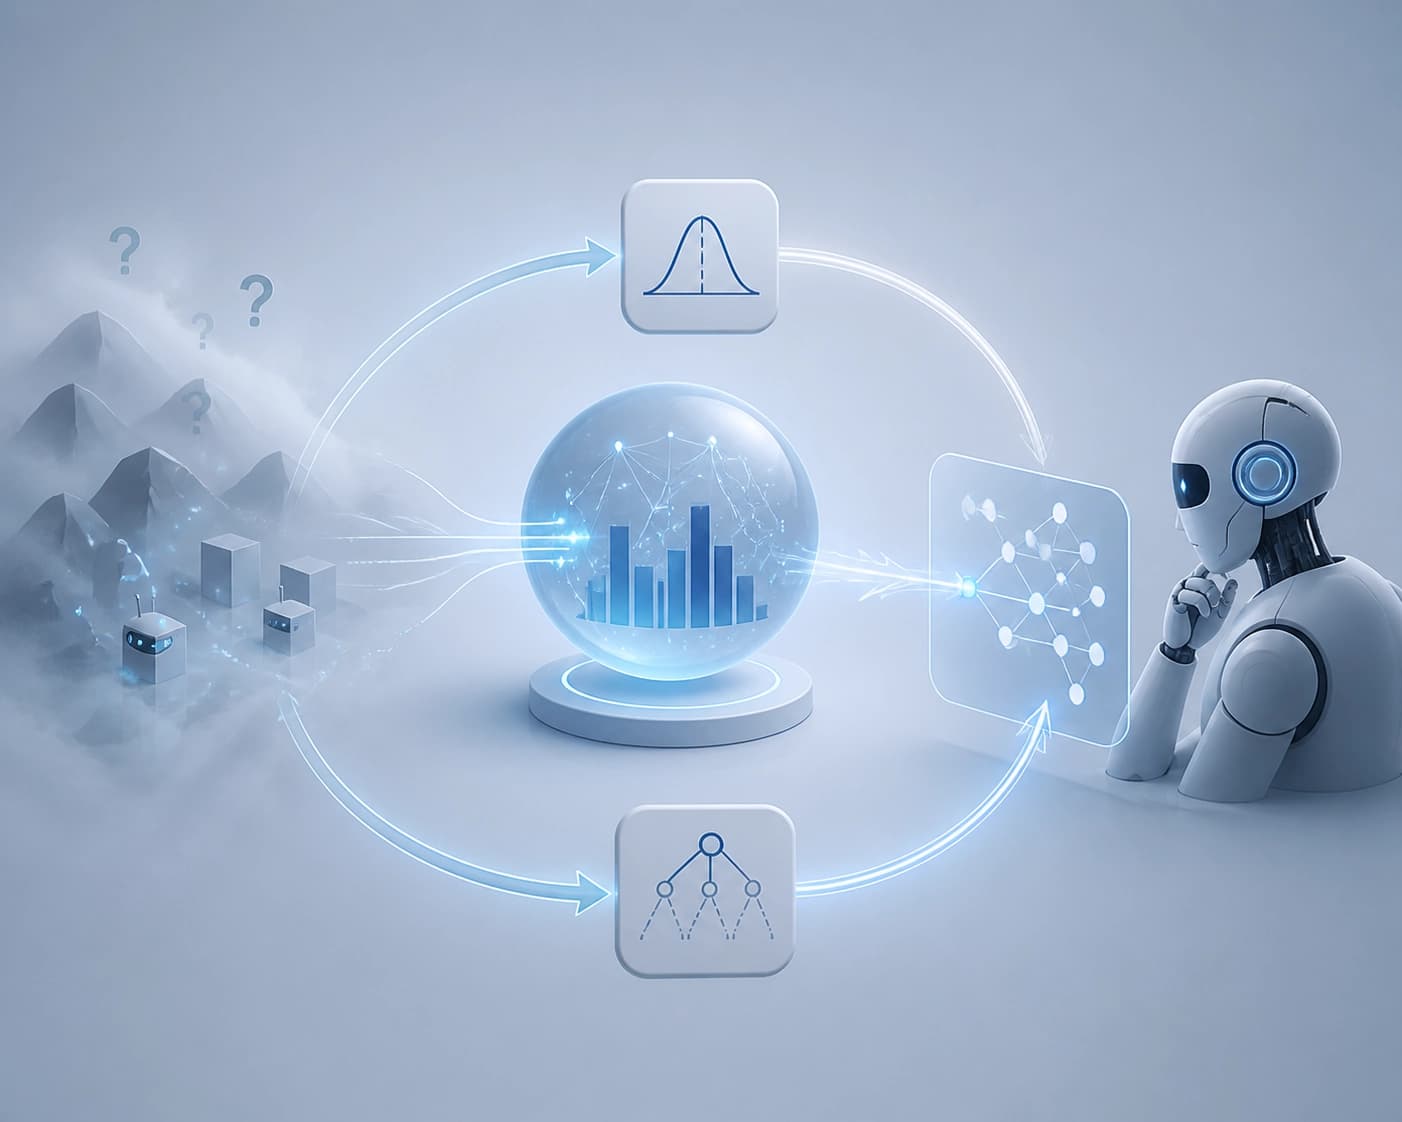
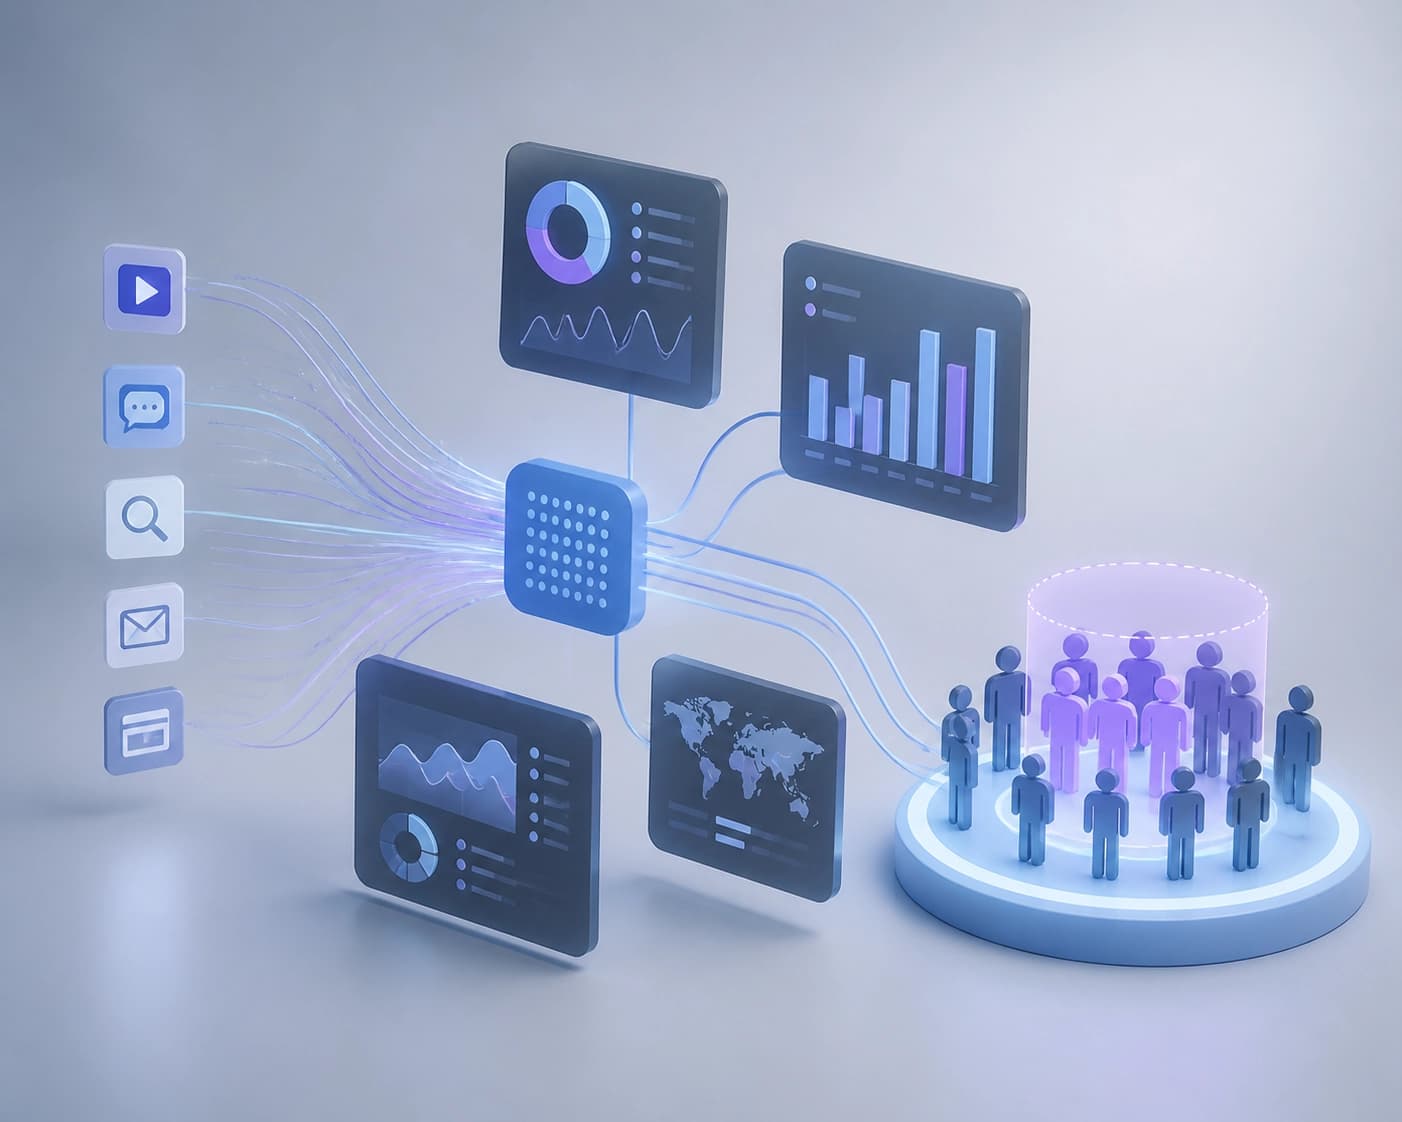
A avaliação é estruturada em torno de uma intervenção e das observações que ela provoca:
- Seleciona-se uma intervenção e introduz-se num simulador controlado.
- O simulador gera as observações correspondentes.
- O agente explora os dados e procura a causa da falha.
- A intervenção oculta serve de rótulo de referência e permite calcular uma recompensa objetiva.
O agente não recebe uma explicação pronta. Tem de relacionar evidências ruidosas, combinadas e distribuídas pelos dados. Assim, a simulação avalia a inferência causal, e não apenas o reconhecimento de uma resposta predefinida.
Como interpretar os resultados
Os autores avaliaram os modelos num conjunto de teste reservado com 235 episódios. O melhor baseline de prompting foi o Claude Opus 5, com um resultado de 0.686 FullAttr@1.
| Modelo ou etapa | Resultado |
|---|---|
| Qwen3.5-35B-A3B após fine-tuning supervisionado | 0.159 → 0.637 |
| O mesmo modelo após RL com recompensas sintetizadas | 0.757 |
| Qwen3.5-122B-A10B no baseline de prompting | Abaixo do resultado de 0.757 |
O resultado de 0.757 superou todos os baselines de prompting avaliados, incluindo modelos de fronteira de código fechado. Os autores também relatam que a policy resultante utilizou substancialmente menos chamadas de ferramentas do que a versão de prompting do modelo base de 35B.
O que os resultados mostram sobre o treino de agentes
Os autores consideram que o acesso a um sinal de treino objetivo e escalável pode ser uma limitação mais importante do que apenas a dimensão do modelo. Esta conclusão diz respeito aos resultados da tarefa descrita, não é uma regra universal para todos os sistemas de IA.
Uma avaliação por simulação pode tornar tarefas ambíguas de raciocínio diagnóstico adequadas ao treino por reforço escalável. A condição fundamental é ser possível comparar a conclusão do agente com a intervenção oculta e calcular uma recompensa objetiva.
Quando esta abordagem é adequada
A simulação é adequada para avaliar inferências causais se o problema permitir:
- definir uma intervenção e introduzi-la num ambiente controlado;
- gerar observações relacionadas com ela;
- manter a intervenção como um rótulo de referência oculto;
- avaliar tanto a causa-raiz como o segmento afetado, quando aplicável.
Se a tarefa não permitir este tipo de comparação com um rótulo de referência, o mecanismo de recompensa objetiva descrito não fica assegurado. O critério prático de escolha é saber se é possível verificar a conclusão do agente com base na causa oculta, sem a revelar durante a análise.