Por que os LLMs erram com observações incompletas
Os autores atribuem os erros de agentes LLM em ambientes parcialmente observáveis à ausência de uma distribuição explícita de crenças sobre o estado oculto. Em geral, o agente atua como uma política condicionada pelo histórico de ações e observações.
O artigo descreve três erros característicos:
- decisão prematura diante de feedback ambíguo;
- viés em favor de uma hipótese incorreta após uma observação informativa;
- desvio da política à medida que o histórico cresce.
O problema não se resume à qualidade da resposta a uma solicitação isolada. Falta ao agente uma representação explícita daquilo que considera possíveis estados ocultos.
Como funciona o circuito bayesiano externo
Belief-State Engine (BSE) é um módulo de inferência externo ao LLM. Ele mantém uma distribuição a posteriori de Bayes sobre os estados ocultos de um modelo POMDP definido — um processo de decisão de Markov parcialmente observável.
A cada passo, o circuito funciona assim:
- O BSE atualiza a distribuição de crenças sobre o estado oculto.
- O LLM recebe apenas essa distribuição.
- O registro original de ações e observações permanece inacessível ao LLM.
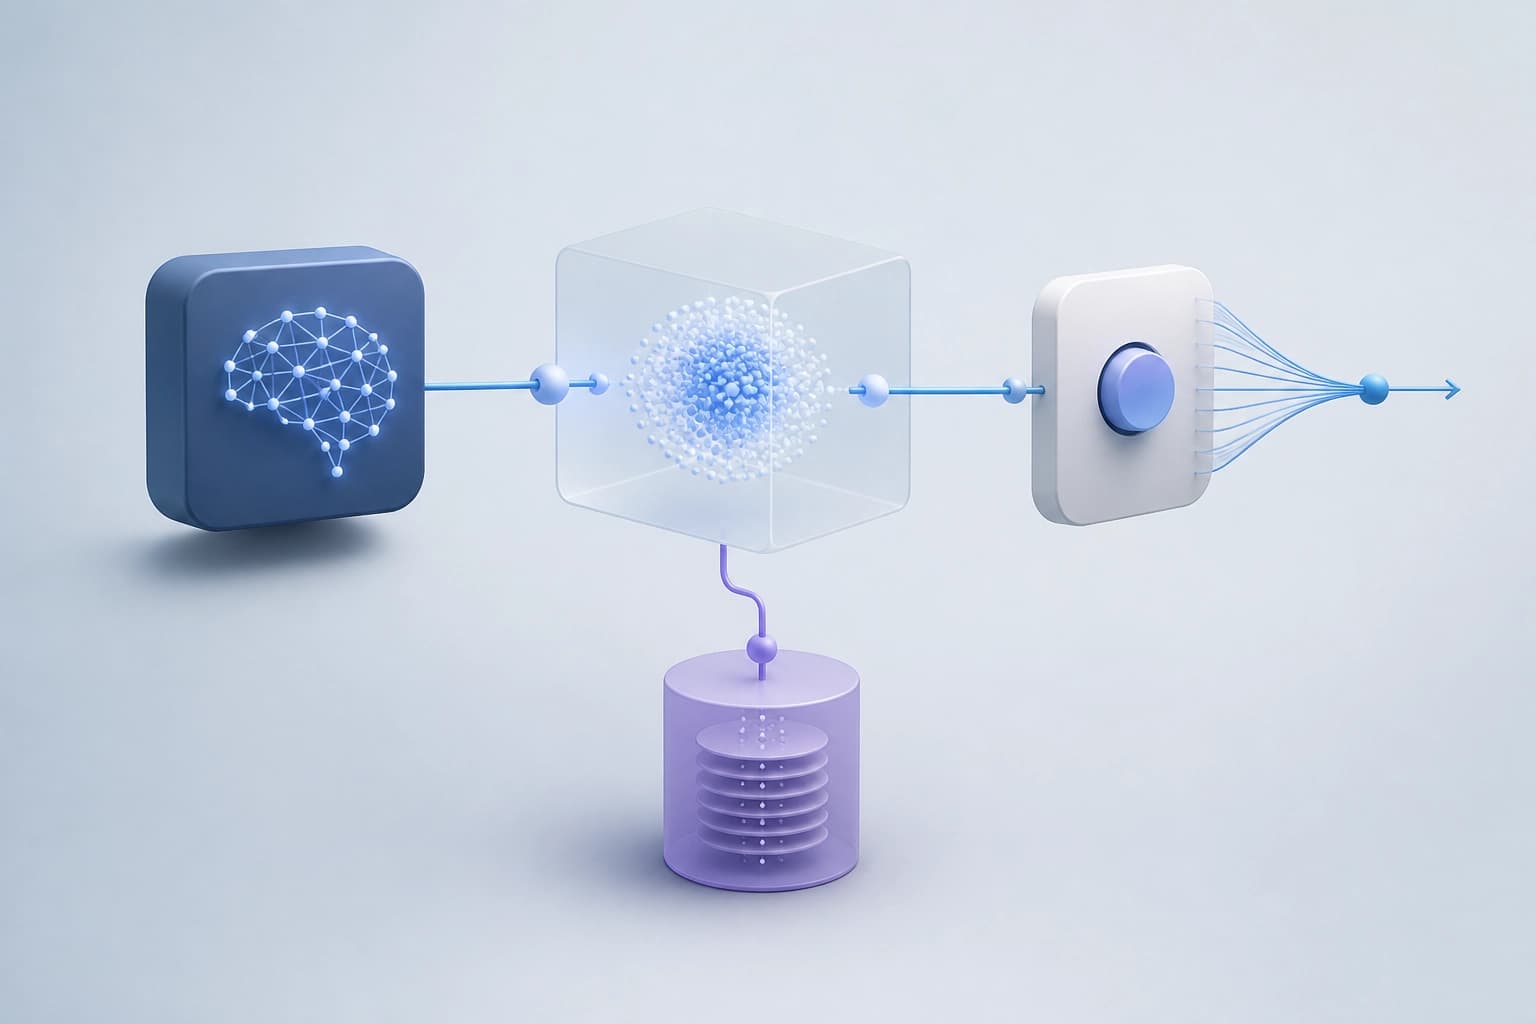
Esta abordagem separa o tratamento da incerteza do modelo de linguagem. A condição fundamental da arquitetura é que o LLM não receba o histórico original.
Que garantias dependem da arquitetura
Os autores definem uma especificação mínima, composta por quatro axiomas, para um estado interno alinhado com as crenças. O conteúdo dos axiomas não é apresentado aqui.
Os autores provam que a combinação de LLM e BSE forma uma política de Markov válida num belief MDP induzido pelo POMDP original. Desde que o LLM nunca tenha acesso ao histórico original, a combinação herda as garantias de otimalidade de Bellman da teoria clássica de POMDP.
Critério prático: estas garantias aplicam-se à combinação descrita e dependem da restrição de acesso ao histórico. Não podem ser dissociadas das condições da arquitetura.
O que a avaliação demonstrou
A arquitetura foi testada no Tiger POMDP e numa tarefa de grafo de ataque red-team. A comparação incluiu seis métodos de referência.
| Método de referência | Resultado do BSE em ambos os domínios |
|---|---|
| Reactive LLM | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
| Chain-of-Thought | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
| ReAct | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
| Natural-language belief tracker | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
| QMDP | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
| POMCP | Maior retorno da tarefa, melhor calibração das crenças e maior consistência das decisões |
O resumo também afirma que o efeito não é específico de um único modelo. Dez ablações direcionadas destinam-se a isolar a contribuição de decisões arquitetónicas individuais.
Quando vale a pena considerar esta abordagem
O BSE suporta uma distribuição sobre os estados ocultos de um POMDP definido. Por isso, a descrição da tarefa no âmbito de um modelo deste tipo é um critério central para determinar a aplicabilidade da abordagem.
A avaliação do artigo abrange os dois domínios indicados. Não confirma que os resultados se generalizem a quaisquer tarefas com dados incompletos.
O que está disponível para verificação
O preprint Belief-State Engine: Augmenting LLMs for Principled Planning Under Partial Observability inclui código, especificações dos ambientes, modelos de prompts e registos de seeds.
O artigo de Arnab Chattopadhayay e Debdipta Halder foi submetido ao arXiv em 9 de setembro de 2026. A conclusão prática deve ser avaliada tendo em conta os ambientes, as comparações e as condições de acesso do LLM ao histórico descritos.