
CaLR: otimização latente com restrições causais para inferência robusta de modelos de difusão
O trabalho apresenta o CaLR — uma abordagem que reduz o raciocínio à otimização com restrições no espaço latente; a estrutura é fornecida por uma matriz de topologia causal de um modelo especializado, e o treino baseia-se em diferenciação implícita. O método aumenta a coerência e permite corrigir resultados intermédios durante a geração paralela, o que proporciona melhores resultados em conjuntos de dados complexos e em tarefas com restrições rigorosas, incluindo o sudoku.
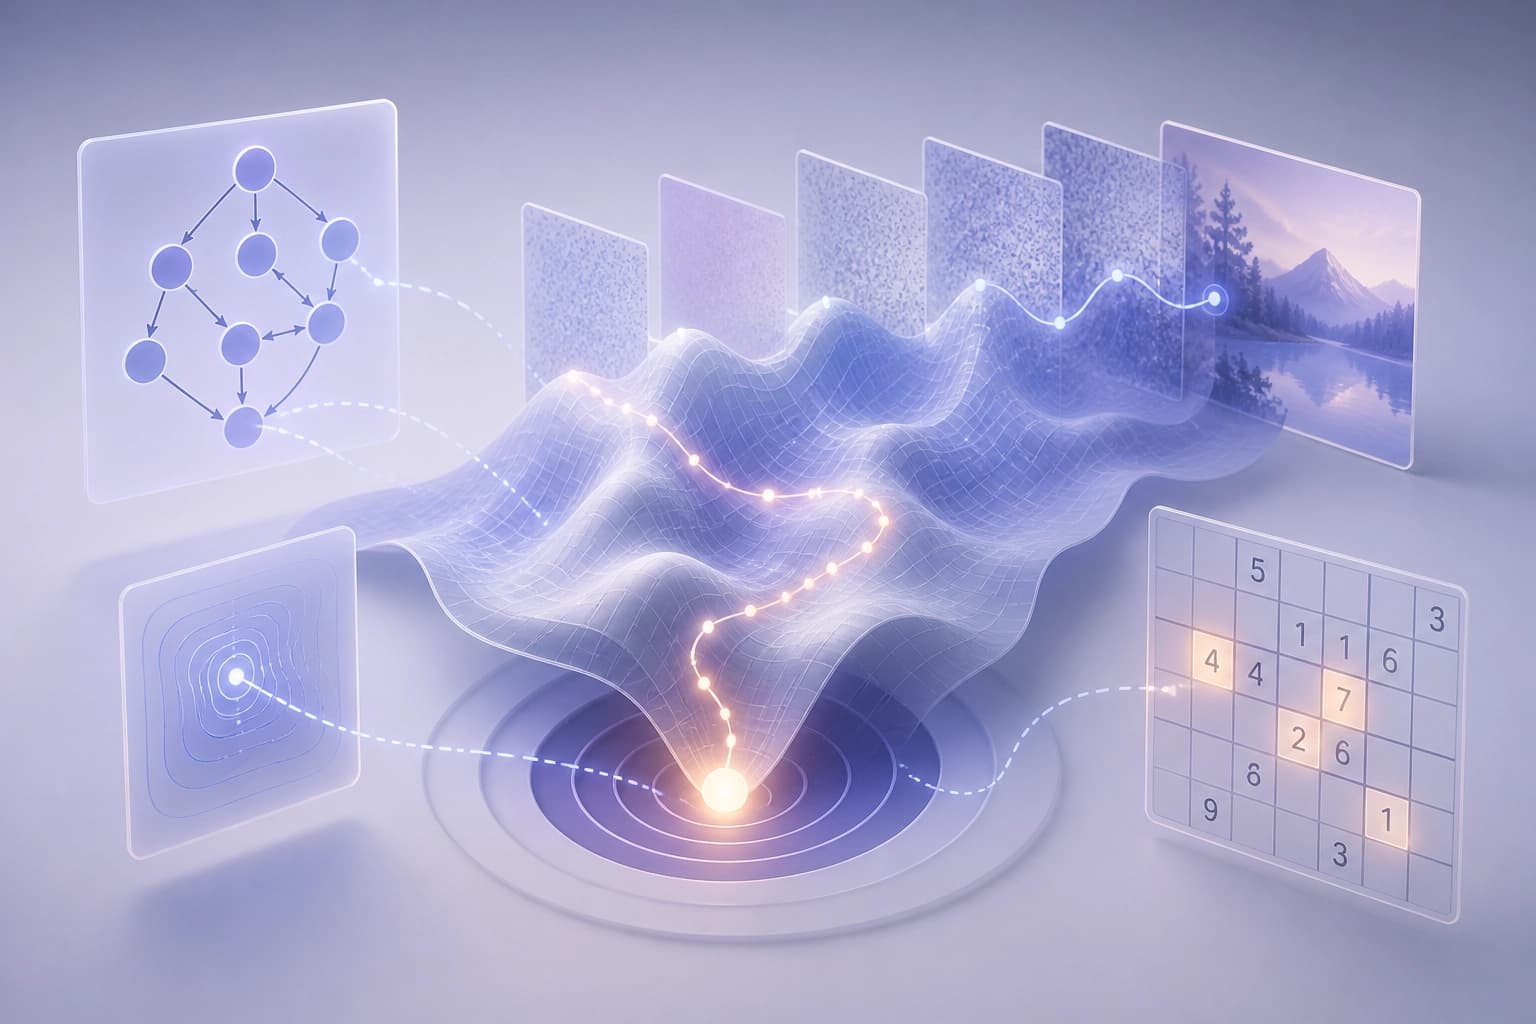
Problema: ganância local das AR e causalidade fraca das DLM
Os modelos autorregressivos sofrem de ganância local. Muitas vezes, os modelos de linguagem de difusão não dispõem de uma estrutura causal rigorosa para o raciocínio.
| Tipo de modelo | Limitação |
|---|---|
| AR | Ganância local |
| DLM | Falta de uma estrutura causal rigorosa para o raciocínio |
Conclusão: o raciocínio precisa de um mecanismo que associe a geração a restrições causais. Critério prático: verificar como o modelo mantém a estrutura lógica nas etapas intermédias.
Framework e objetivo
CaLR é um framework para inferência robusta de modelos de difusão. Formula o raciocínio como otimização latente com restrições. Nome completo: «CaLR: Causal Latent Revision for Robust Diffusion Reasoning». Autores: Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. Data de submissão: 17 de setembro de 2026.
Conclusão: CaLR associa a inferência robusta à otimização da representação latente. Critério prático: escolher o método se a tarefa exigir estrutura causal no raciocínio.
Componentes da abordagem
CaLR utiliza três elementos. O primeiro é a matriz de topologia causal (CTM). A matriz é obtida a partir de um modelo especialista. O segundo é a diferenciação implícita. O terceiro é a «revisão do pensamento» orientada por gradientes.
Matriz de topologia causal (CTM)
A CTM é uma matriz de topologia causal. A sua origem é um modelo especialista.
Diferenciação implícita
CaLR utiliza diferenciação implícita.
«Revisão do pensamento» orientada por gradientes
Esta operação destina-se a garantir a coerência lógica. Destina-se também à autocorreção dinâmica das etapas intermédias durante a geração paralela.
Conclusão: a CTM fornece a estrutura causal, a diferenciação implícita faz parte da otimização e a revisão do pensamento corrige as etapas. Critério prático: verificar se existe uma fonte de estrutura causal e um mecanismo de correção.
Resultados anunciados
CaLR alcança um desempenho SOTA de DLM em benchmarks complexos. O framework supera fortes baselines de AR. Demonstra maior robustez em tarefas com restrições, como o Sudoku.
| Propriedade | Resultado |
|---|---|
| Desempenho de DLM | SOTA em benchmarks complexos |
| Comparação com AR | Supera fortes baselines de AR |
| Robustez | Maior robustez em tarefas com restrições, como o Sudoku |
Conclusão: as vantagens anunciadas dizem respeito a benchmarks complexos e a tarefas com restrições. Critério prático: comparar os requisitos da tarefa com a robustez em tarefas com restrições. Para outros cenários, não há dados no resumo.
Perguntas mais frequentes
Materiais semelhantes
Todos os materiais
Invariantes polinomiais canónicos no diagnóstico de falhas em simuladores de RL: onde são realmente úteis
O estudo avalia se a incorporação de leis físicas em modelos de dinâmica treináveis se justifica: os invariantes extraídos das trajetórias e reduzidos à forma canónica por meio de bases de Gröbner proporcionam ganhos modestos nas previsões, mas são eficazes no diagnóstico — permitem localizar a restrição violada e identificar o parâmetro específico incorreto.
10 novembro 2026
AURA-Eval: como verificar se o agente de LLM reconheceu o risco e mudou o próximo passo
O framework avalia o comportamento de agentes LLM não pelo veredito final, mas pela reação ao risco em pontos-chave: as trajetórias de chamadas a ferramentas são interrompidas, após o que o modelo deve continuar o raciocínio e a ação, enquanto um painel de juízes LLM analisa a detecção de riscos, a natureza e a segurança da ação. Em 1.249 tarefas reunidas a partir de 157 trajetórias do R-Judge, as ações inseguras tornam-se mais frequentes entre 20 modelos quando não há um caminho seguro, e a remoção da supervisão antes da execução transforma 52,3% dos casos inicialmente seguros em casos inseguros.
10 novembro 2026
Memória do reservatório de Chern–Simons: dinâmica autónoma de conectividade e transporte de densidade
O artigo analisa como um reservatório preserva o histórico dos sinais de entrada simultaneamente na distribuição de densidade e nos graus de liberdade geométricos. A comparação de quatro mecanismos mostra que a corrente cria uma componente de conectividade separada, que altera a resposta subsequente da densidade, e que considerar todas as características medidas proporciona um pequeno ganho na descodificação da ordem dos impulsos.
10 novembro 2026