
MAPLE: transfer anggaran pakar yang dirutekan antar lapisan model MoE tanpa mengubah bobot
Penelitian ini menunjukkan bahwa jumlah pakar yang dirutekan secara seragam untuk semua lapisan secara sistematis kalah dibandingkan tata letak yang tidak merata, dan mengusulkan mekanisme pluggable yang bertumpu pada penilaian sensitivitas lapisan. Pada empat model MoE, pendekatan ini dengan anggaran pakar 75% mengungguli baik skema seragam maupun pemangkasan pakar, dan pada SGLang menurunkan latensi layanan sebesar 32,2% serta meningkatkan throughput sebesar 47,4%.
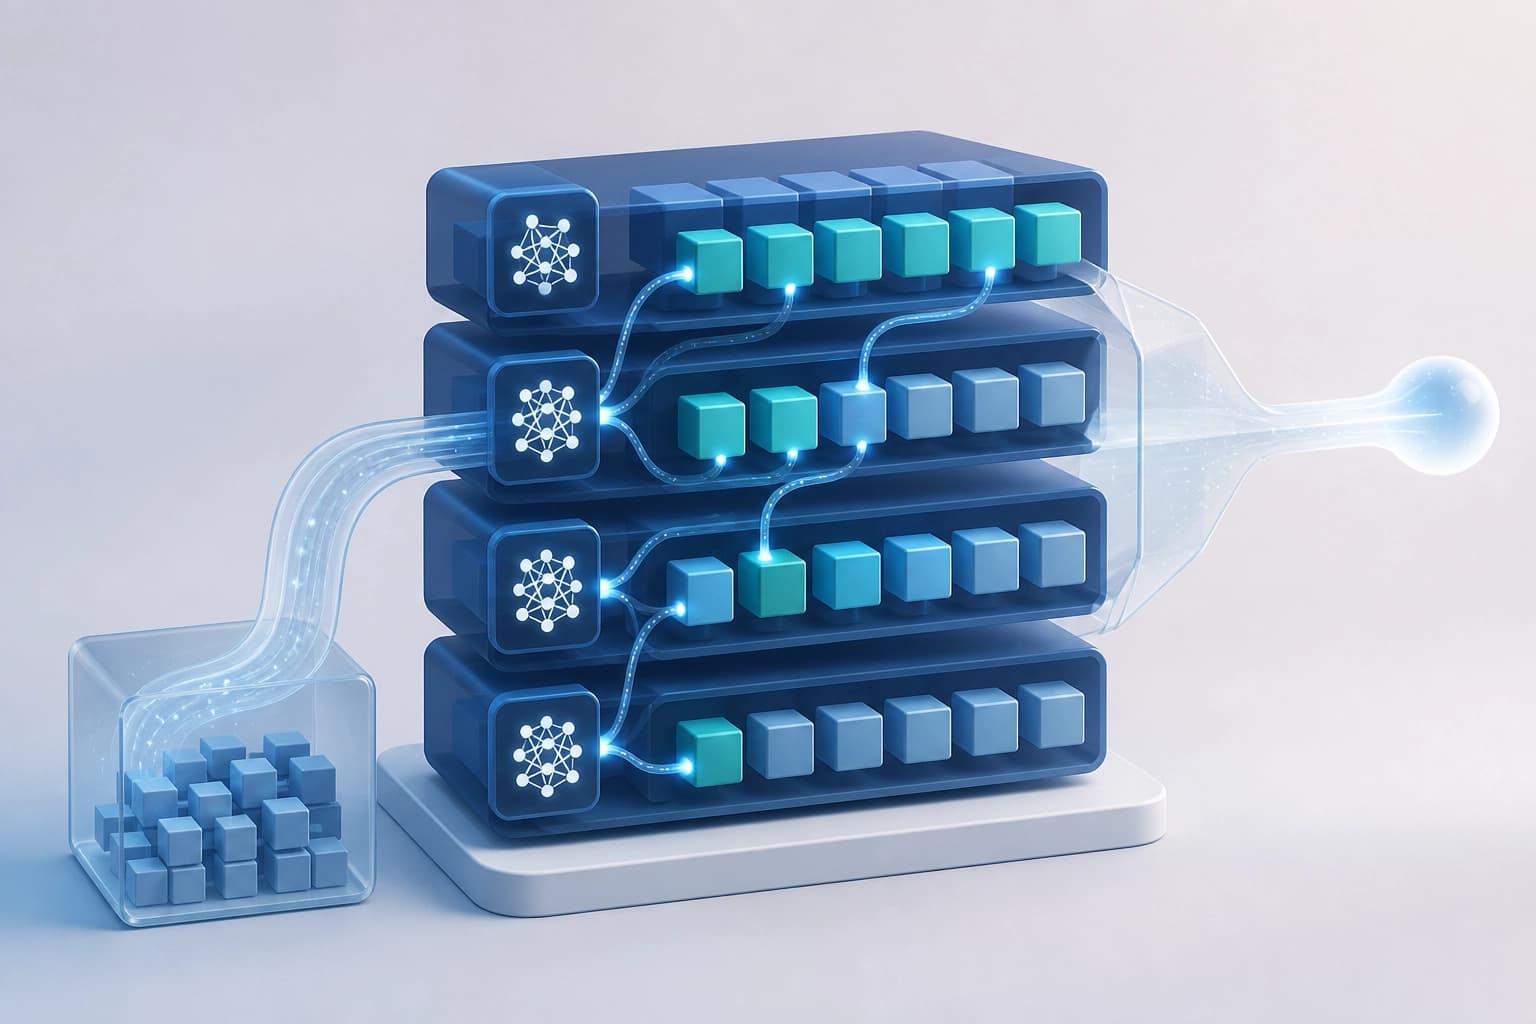
Masalah anggaran ahli yang seragam
Transformer MoE dengan aktivasi sparse menetapkan jumlah ahli yang dirutekan yang sama di semua lapisan. Ini mengabaikan heterogenitas redundansi antar lapisan yang telah terdokumentasi.
MAPLE adalah framework plug-and-play. Ia mendistribusikan ulang anggaran ahli yang dirutekan antar lapisan pada MoE LLM yang telah dilatih sebelumnya. Metode ini tidak mengubah bobot dan tidak memerlukan pelatihan ulang.
Properti utama:
- Distribusi anggaran yang heterogen per lapisan.
- Tidak ada perubahan bobot model.
- Tidak ada pelatihan ulang.
- Dapat diterapkan pada MoE LLM yang telah dilatih sebelumnya.
Kriteria praktis: pendekatan ini diperlukan ketika ingin mengubah distribusi ahli tanpa mengubah bobot dan tanpa pelatihan ulang.
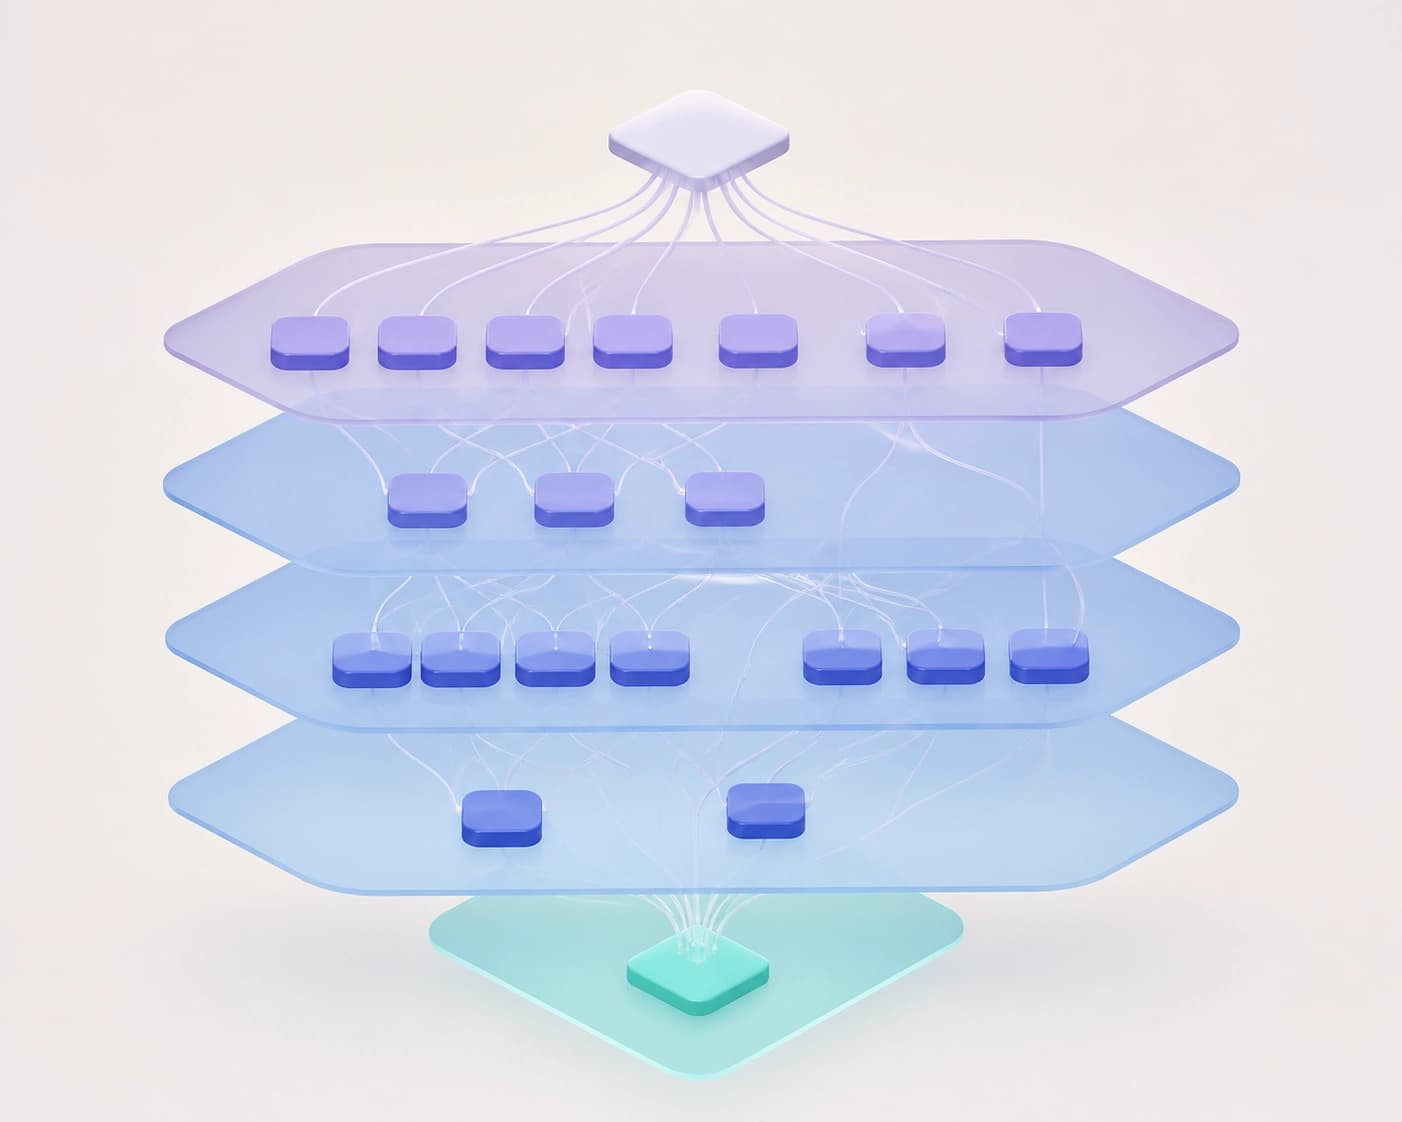
Sensitivitas lapisan dan formula tertutup
MAPLE menyelidiki setiap lapisan. Metode ini memeriksa respons lapisan terhadap perubahan jumlah ahli. Sensitivitas diukur secara kuantitatif dengan tiga ukuran.
Tahapan pemindahan anggaran:
- Penyelidikan setiap lapisan.
- Evaluasi respons terhadap perubahan jumlah ahli.
- Pengukuran sensitivitas secara kuantitatif dengan tiga ukuran.
- Penurunan distribusi anggaran yang optimal secara analitis.
- Penyempurnaan dengan pencarian genetika yang dibatasi oleh sensitivitas.
Distribusi analitis mengarahkan kapasitas ke lapisan yang sensitif. Pada lapisan yang redundan, pengurangan anggaran dapat diserap. Pencarian genetika menggunakan sensitivitas per lapisan sebagai prior. Ini menghasilkan konvergensi yang lebih cepat dan kualitas distribusi yang lebih baik.
Kesimpulan: pemindahan anggaran bertumpu pada sensitivitas yang terukur, bukan pada aturan yang seragam.
Perbandingan dengan pendekatan seragam dan pruning
MAPLE mengungguli baseline seragam dan berbasis pruning pada empat model MoE dengan skala dan arsitektur yang berbeda. Perbandingan dilakukan pada anggaran ahli yang dirutekan sebesar 75%.
| Varian | Anggaran ahli yang dirutekan | Hasil |
|---|---|---|
| Baseline seragam | 75% | Kalah dari MAPLE |
| Baseline berbasis pruning | 75% | Kalah dari MAPLE |
| MAPLE | 75% | Mengungguli kedua baseline |
| Baseline seragam | 100% | Kalah dari MAPLE dengan 75% pada DeepSeek-MoE-16B untuk ARC-E, ARC-C, dan BoolQ |
Pada DeepSeek-MoE-16B, MAPLE hanya menggunakan 75% ahli. Meskipun demikian, ia mengungguli baseline seragam 100% pada ARC-E, ARC-C, dan BoolQ.
Peningkatan akurasi:
- ARC-E: dari 65,09 menjadi 71,40.
- ARC-C: dari 48,49 menjadi 51,50.
- BoolQ: dari 80,03 menjadi 82,38.
Kesimpulan: distribusi yang heterogen dapat lebih efektif daripada sekadar mengaktifkan lebih banyak ahli.
Efisiensi pada penyajian di SGLang
Implementasi MAPLE di SGLang menurunkan latensi penyajian end-to-end pada satu GPU sebesar 32,2%. Throughput meningkat sebesar 47,4%.
Metode ini tidak mengubah bobot. Karena itu, ia dapat diintegrasikan ke dalam stack penyajian MoE yang ada. Ini menjadikan pemindahan anggaran sebagai tuas praktis untuk inferensi.
Kriteria praktis: untuk penyajian single-GPU melalui SGLang, metode ini memberikan penurunan latensi dan peningkatan throughput.
Kriteria pemilihan
MAPLE layak dipertimbangkan dalam beberapa kasus:
- Perlu mengurangi anggaran ahli yang dirutekan tanpa pelatihan ulang.
- Modelnya adalah MoE LLM yang telah dilatih sebelumnya.
- Perlu memperhitungkan ketidakhomogenan per lapisan, bukan aturan yang seragam.
- Perlu meningkatkan efisiensi inferensi MoE.
Kesimpulan: distribusi ahli yang heterogen menjadi poros yang fundamental dan praktis untuk meningkatkan efisiensi MoE.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pemeriksaan halusinasi LLM melalui tampilan sumber SQL tanpa fine-tuning
Penelitian ini menguji apakah LLM dapat memanfaatkan keterampilan simbolik dasar—menyusun basis data SQL dari dokumen sumber—untuk melakukan grounding ke sumber tanpa supervisi dalam deteksi halusinasi. Pada RAGTruth dan DiaHalu, pipeline neuro-simbolik ini lebih akurat daripada prediksi langsung dan sebanding dengan metode mutakhir, tanpa memerlukan fine-tuning khusus domain.
9 November 2026
MathAdv: Apa yang Tersembunyi di Balik Akurasi Akhir Pembuktian Mesin
Kumpulan tugas diagnostik dari 13 bidang matematika tingkat universitas dan pascasarjana ini mengevaluasi sistem pembuktian otomatis di Lean 4 tidak hanya berdasarkan hasil akhir, tetapi juga penguasaan materi, kualitas penalaran informal, dan ketahanan terhadap perumusan ulang soal. Analisis per komponen menunjukkan bahwa menerjemahkan soal ke dalam bentuk formal masih menjadi kendala utama, sementara tingkat keberhasilan sangat bergantung pada bidang matematika dan cara soal dirumuskan.
9 November 2026
AffordanceWAM: affordance sebagai perantara antara prediksi adegan dan kendali manipulator
Karya ini menjelaskan model generatif yang secara bersamaan memprediksi observasi RGB masa depan, medan skalar dan peta panas affordance, serta perintah robot kontinu, dengan memanfaatkan video manusia untuk memperluas keragaman interaksi tanpa anotasi tindakan dan retargeting. Pada RoboCasa, CALVIN ABC→D, dan tugas dunia nyata, pendekatan ini memberikan peningkatan yang konsisten dibandingkan baseline yang hanya menggunakan RGB dan yang hanya menggunakan data robot.
9 November 2026