Mengapa lintasan adalah satuan pengukuran yang buruk
Metode penalaran selama inferensi modern bekerja dengan skema yang sama: model menghasilkan bukan satu jawaban, melainkan seluruh kumpulan rantai kandidat, setelah itu reward-model eksternal memilih yang terbaik. Logikanya sederhana — semakin banyak varian, semakin tinggi peluang bahwa di antaranya ada yang berhasil.
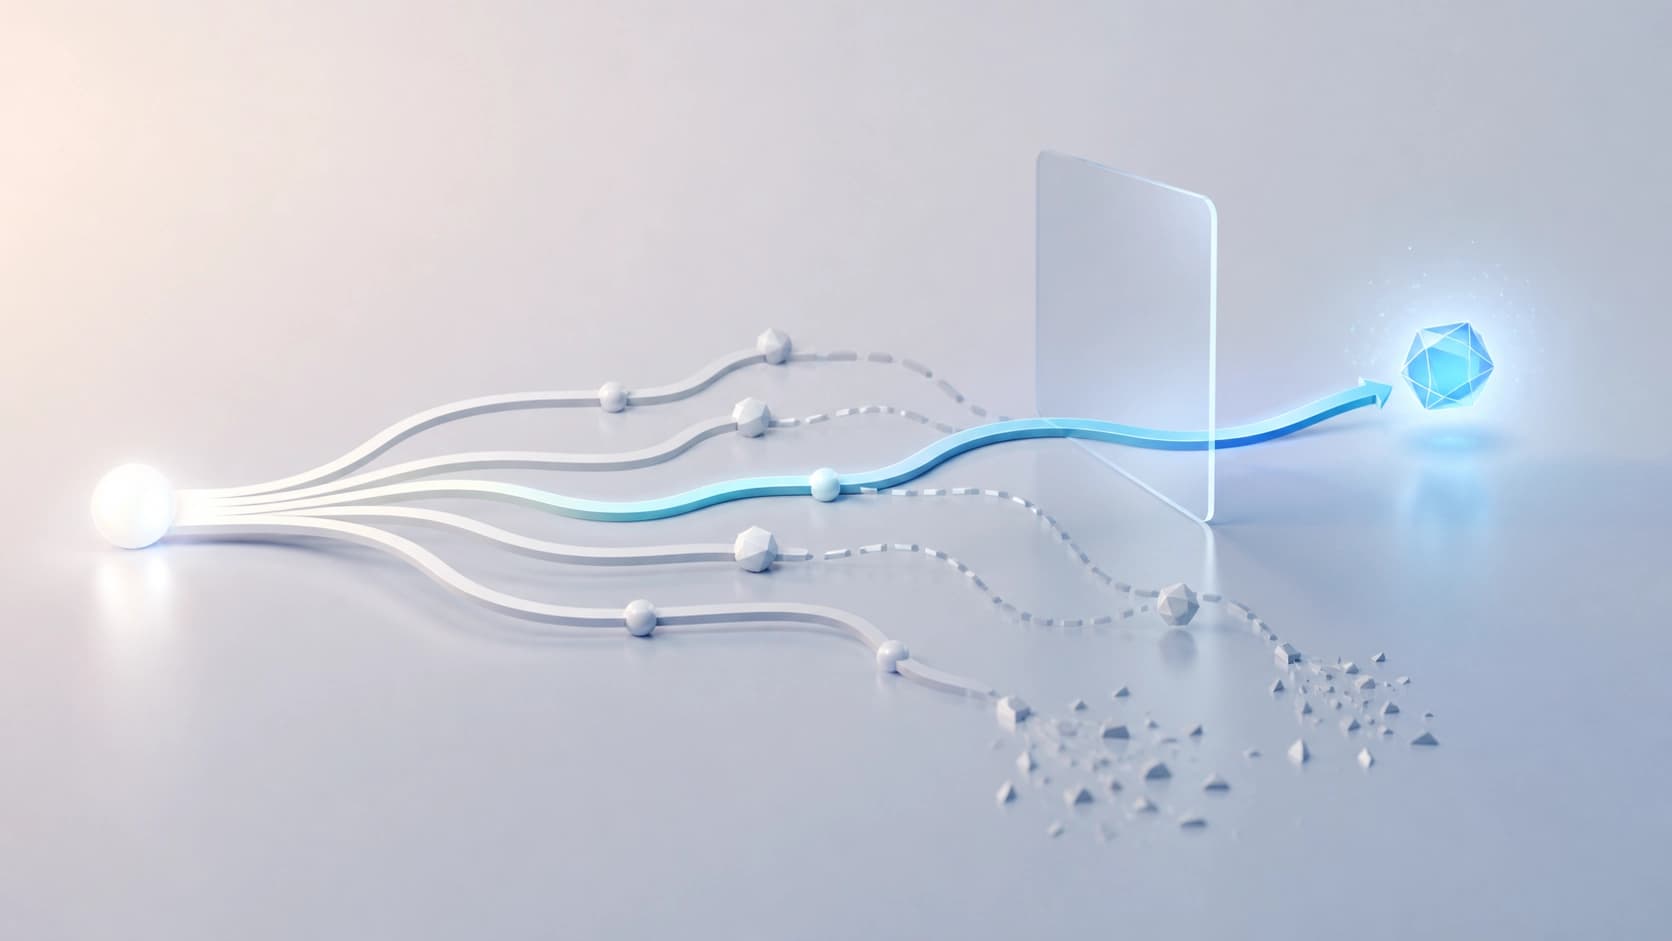
Titik lemahnya ada di tempat lain. Setiap kandidat dianggap sebagai kesatuan yang tak terbagi: ia diterima sepenuhnya, atau dibuang sepenuhnya. Namun penalaran panjang jarang bersifat homogen. Gambaran tipikalnya — awal yang percaya diri dan benar, perumusan masalah yang rapi, metode yang dipilih dengan tepat, lalu kegagalan: kesalahan aritmetika, pengulangan tanpa henti, penggantian kondisi. Secara formal seluruh rantai ditandai sebagai gagal, padahal paruh pertamanya cukup berfungsi.
Hasilnya — komputasi yang terbuang sia-sia. Kita membayar pembuatan token yang tadinya benar, lalu membuangnya bersama ekor yang rusak. Justru pada ketidakefisienan inilah para penulis karya Selective Regenerative Decoding menunjuk, yang diterbitkan sebagai arXiv:2608.24338 (cs.AI) pada 25 Agustus 2026.
SRD: tiga cabang alih-alih dua
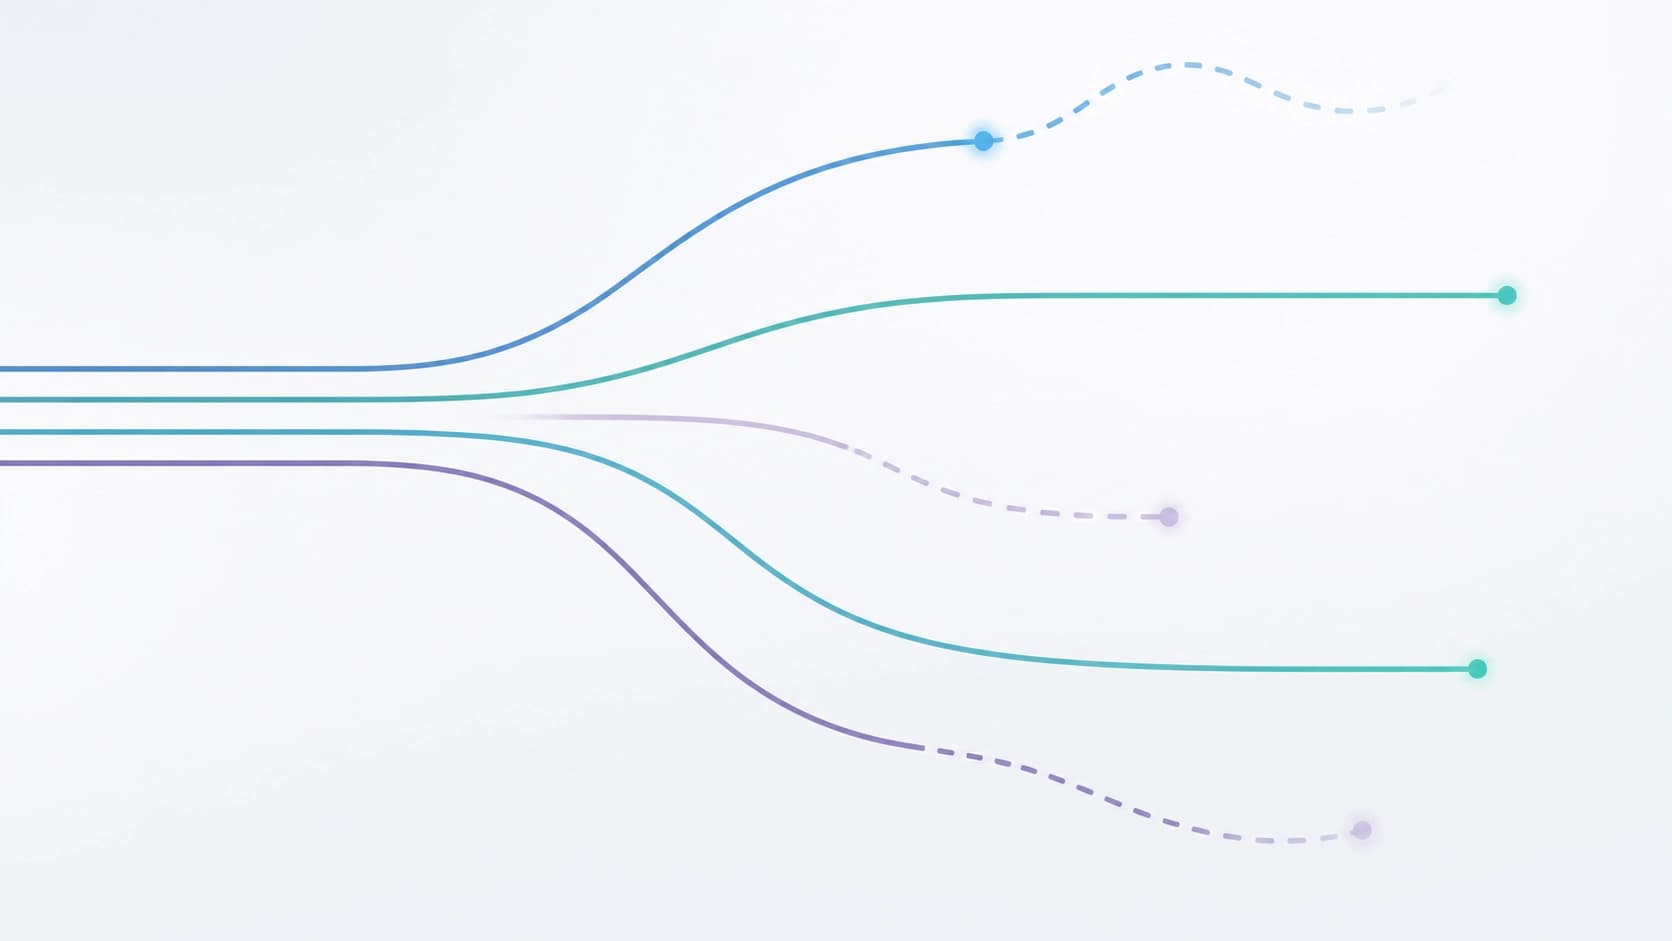
Selective Regenerative Decoding (SRD) mengusulkan untuk meninggalkan pilihan biner. Alih-alih "terima atau buang", setiap kandidat diarahkan ke salah satu dari tiga cabang:
- buang — jika rantai tidak berguna dari awal hingga akhir;
- pertahankan — jika ia lolos pemeriksaan secara keseluruhan;
- perbaiki — jika ada bagian yang berguna, tetapi sufiksnya jelas mengalami degradasi.
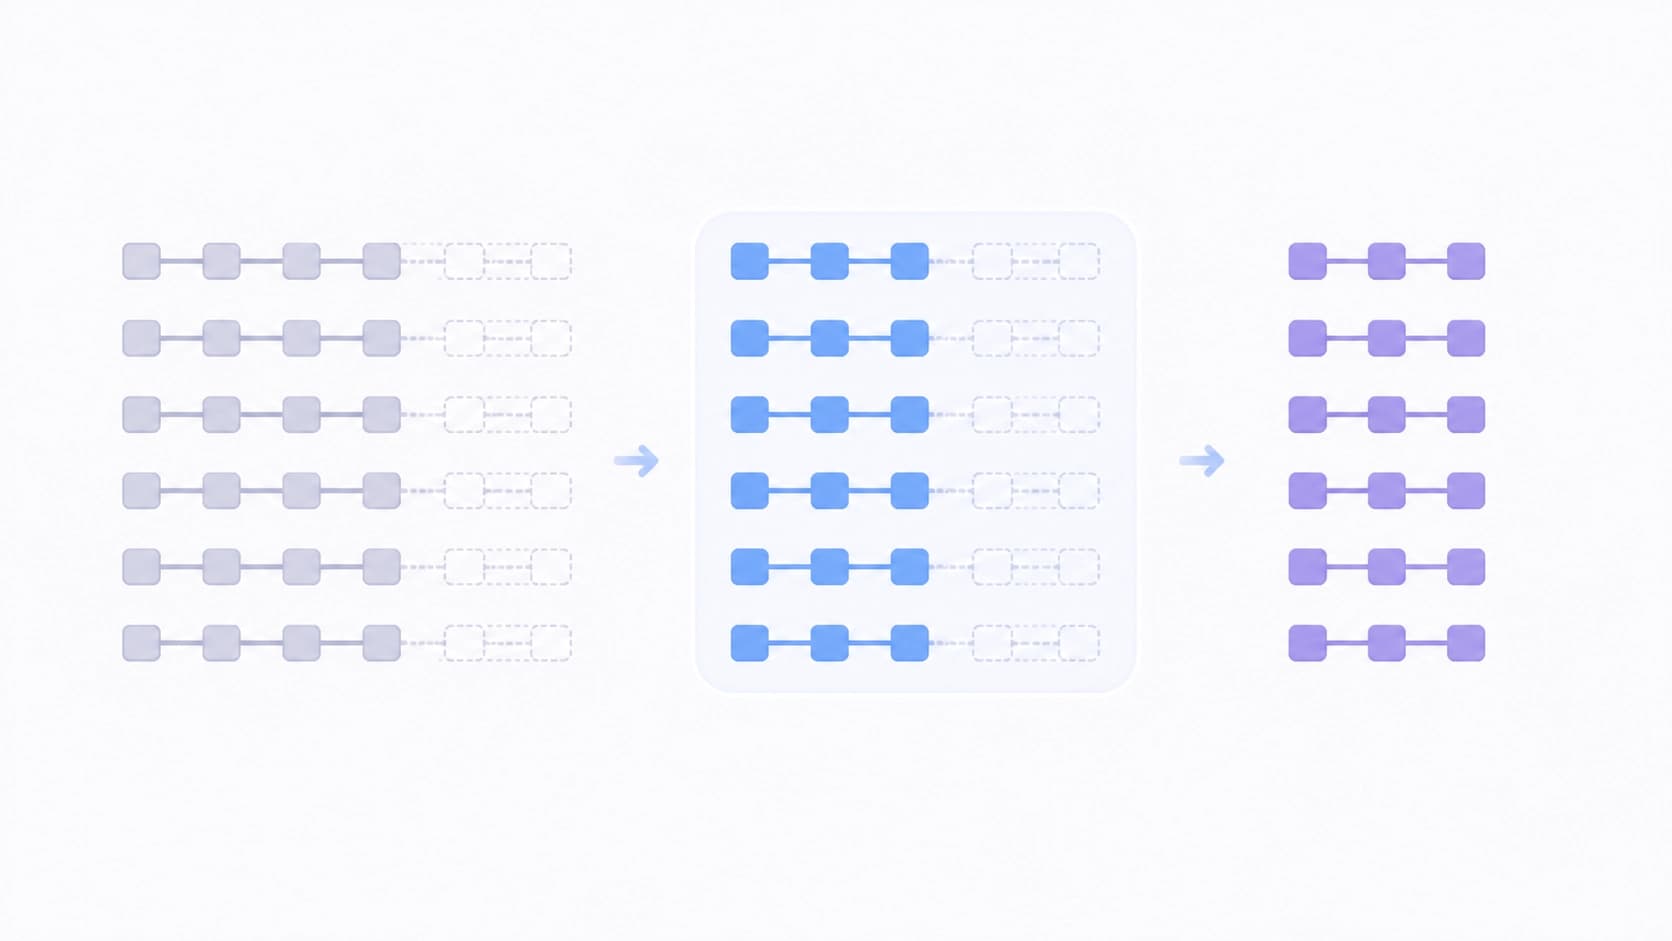
Dalam kasus ketiga, sistem tidak menulis ulang penalaran dari nol, melainkan mempertahankan prefiks yang berkualitas dan meregenerasi hanya bagian yang rusak. Ini lebih mirip menyunting draf daripada menulis teks baru: Anda tidak membuang pendahuluan yang berhasil hanya karena akhirnya gagal, melainkan memperbaiki apa yang rusak.
Secara terpisah, para penulis menekankan bahwa untuk intervensi semacam ini tidak diperlukan model-donor yang lebih besar. Tidak ada "guru pintar" yang menarik murid lemah, — seluruh pekerjaan berlangsung dalam kerangka sumber daya komputasi yang sudah ada. Inilah yang membuat metode ini terapan, bukan latihan teoretis.
Dari mana keuntungannya berasal
Yang paling menarik dalam karya ini bukan heuristiknya, melainkan dasar pembenarannya. Dengan asumsi yang lunak, SRD memberikan peningkatan efisiensi pengambilan sampel yang dapat dibuktikan sebesar 1,28–1,36 kali dibandingkan rejection sampling klasik, dan kualitas yang diharapkan dari lintasan akhir ternyata secara ketat lebih tinggi, bukan sekadar "tidak lebih buruk".
Intuisinya di sini dapat dipahami tanpa rumus. Kandidat yang telah melalui regenerasi sufiks sudah mengandung komputasi yang telah dibayar — token-token prefiks yang tidak perlu dihasilkan lagi. Semakin banyak kandidat batas semacam itu yang berhasil diselamatkan, semakin kecil porsi teks yang dihasilkan yang berakhir di keranjang sampah. Dan karena dengan bertambahnya kumpulan kandidat jumlah rantai "hampir berhasil" juga bertambah, keuntungannya tidak tetap — ia berskala seiring anggaran untuk generasi.
Di mana ini diuji
Bagian empirisnya mencakup empat jenis beban yang berbeda: MATH500 (soal matematika), GPQA Diamond (pertanyaan tingkat ilmiah), HotpotQA (pertanyaan multi-langkah berdasarkan dokumen), dan AlpacaEval (mengikuti instruksi dan penilaian preferensi). Pengujian dilakukan pada beberapa kombinasi "generator + reward-model", agar hasilnya tidak bergantung pada satu pasangan yang berhasil.
Hasil yang diklaim: SRD mencapai akurasi yang biasanya diperoleh dengan mode Best-of-N, tetapi menghabiskan token yang dihasilkan jauh lebih sedikit. Dan dalam skenario dengan komputasi terbatas, metode ini melampaui speculative rejection — yakni menang justru di tempat di mana setiap token tambahan berbiaya mahal.
Apa yang secara substantif ini ubah
Pergeseran utama yang dicatat para penulis adalah pergeseran metodologis. Sebelumnya pemilihan terjadi pada tingkat seluruh lintasan: reward-model memberi penilaian dan menentukan nasib seluruh penalaran. SRD memindahkan intervensi ke dalam lintasan, ke tingkat segmen, dan dengan demikian membuka wilayah kompromi antara akurasi dan komputasi yang hingga kini hampir tidak diteliti.
Kesimpulan praktis bagi mereka yang membangun pipeline inferensi: kualitas penalaran dan biaya untuk memperolehnya tidak harus selalu merupakan besaran yang terikat secara kaku. Sebagian komputasi "berlebih" dapat dikembalikan jika kita berhenti memperlakukan draf model sebagai monolit.
Apa yang tetap tersembunyi
Pertanyaan terbuka masih banyak. Yang kunci — bagaimana tepatnya batas antara prefiks yang sehat dan sufiks yang terdegradasi ditentukan: berapa banyak kandidat yang akan masuk ke cabang ketiga bergantung pada kriteria ini. Selanjutnya — biaya regenerasi itu sendiri (ia tidak gratis), sensitivitas terhadap pemilihan reward-model, dan sejauh mana kesimpulannya dapat dipindahkan ke luar empat benchmark yang digunakan.
Karya ini mencakup 20 halaman dan diajukan ke ARR, jadi untuk saat ini ia adalah pracetak versi pertama, bukan hasil yang telah ditinjau sejawat. Namun arahnya tampak menjanjikan: alih-alih menghasilkan lebih banyak dan menyeleksi lebih ketat, kita dapat mengelola dengan lebih cermat apa yang sudah ditemukan model.