
Mengapa kita perlu menguraikan kesalahan pipeline
Menilai sistem RAG dengan satu angka memang praktis, tetapi hampir tidak berguna. Metrik end-to-end menjawab pertanyaan "apakah jawabannya sesuai harapan", bukan pertanyaan "mengapa jawaban itu sampai di sana atau tidak sampai". Padahal RAG bukanlah blok monolitik, melainkan sebuah rantai: pertama sesuatu ditemukan di basis data, lalu sistem memutuskan apakah yang ditemukan sudah cukup, dan baru kemudian generator menulis teks. Kegagalan di salah satu mata rantai menghasilkan jawaban yang sama-sama "salah" di keluaran, meskipun penyebab dua kegagalan tersebut bisa jadi justru berlawanan.
Justru masalah inilah yang diangkat oleh karya The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, bagian cs.CL, dikirim 25 Agustus 2026). Para penulisnya — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak, dan Jan Deriu — mengusulkan untuk tidak mengukur pipeline secara keseluruhan, melainkan mendeskripsikannya sebagai model probabilistik, di mana setiap tahap adalah variabel acak tersendiri dengan keterkaitannya masing-masing. Selanjutnya, evaluasi sistem berubah menjadi tugas inferensi: nilai variabel tersembunyi mana yang paling masuk akal menjelaskan jawaban yang teramati dan anotasi.
Apa yang sebenarnya dimodelkan oleh kerangka Bayesian ini
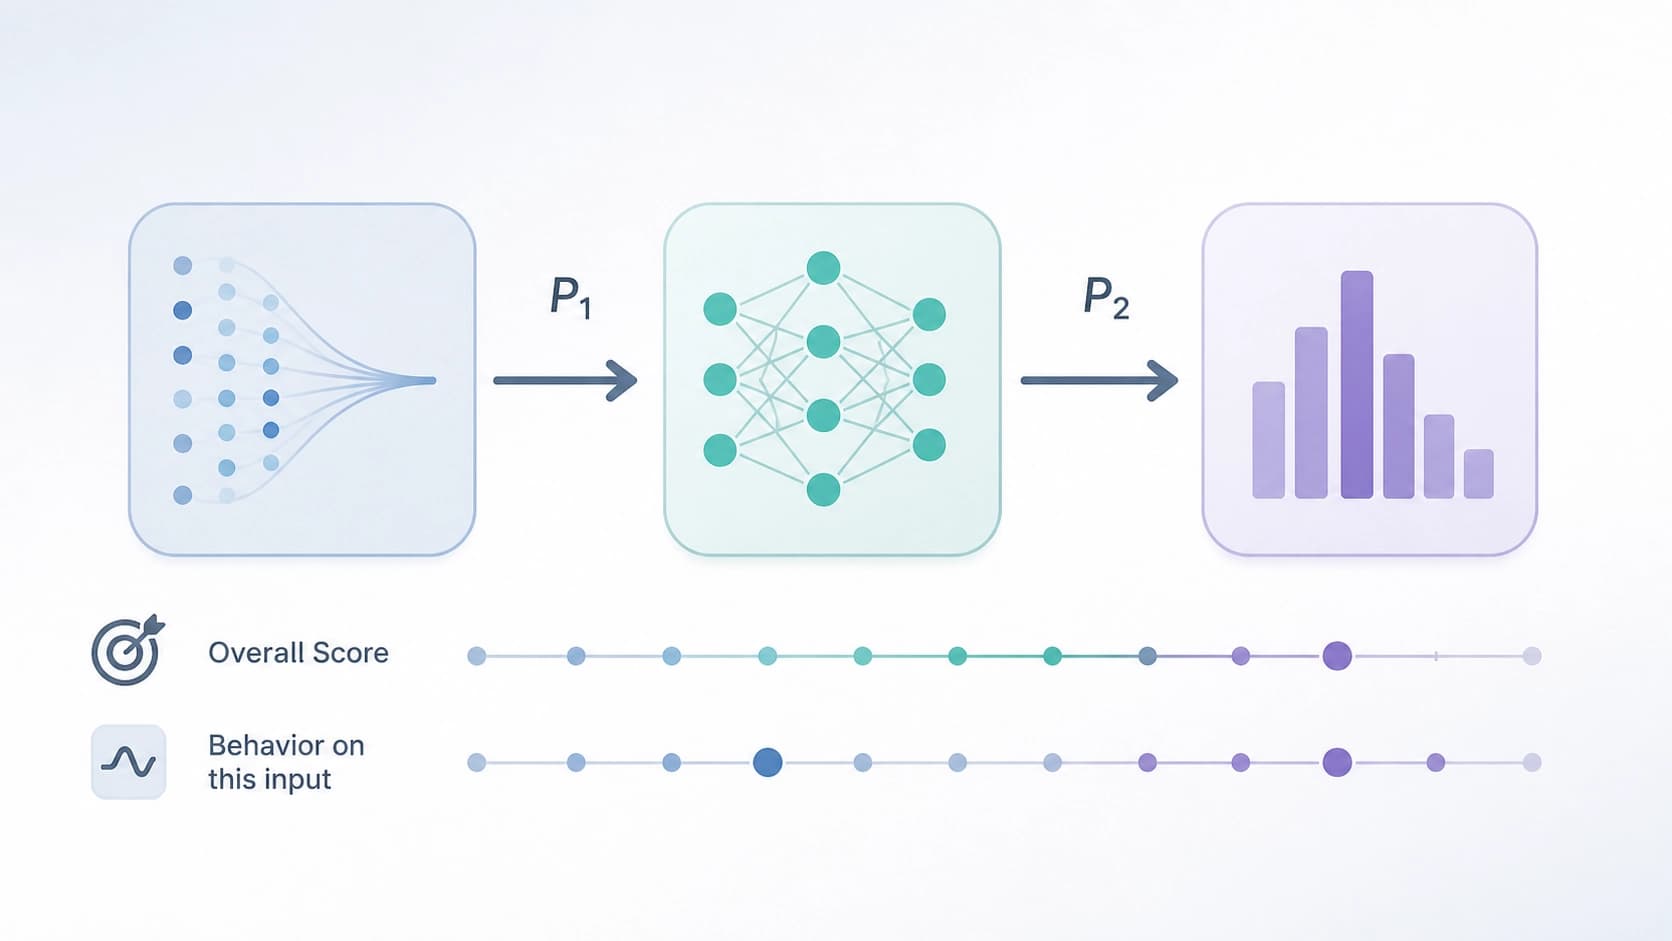
Ide kuncinya adalah faktorisasi berdasarkan aliran informasi. Variabel-variabel diperkenalkan bukan secara mekanis "per komponen pipeline", melainkan dalam urutan bagaimana informasi benar-benar mengalir melalui sistem: keberhasilan pencarian memengaruhi bagaimana generator seharusnya berperilaku, dan perilaku generator bersama hasil pencarian menentukan kebenaran jawaban akhir. Struktur seperti ini membuat ketergantungan menjadi eksplisit, bukan tersembunyi di dalam skor agregat.
Dengan begitu model The RAT memperoleh tiga lapisan bermakna yang biasanya melebur menjadi satu angka.
Task success dan generator success adalah dua pertanyaan yang berbeda
Lapisan pertama adalah task success: apakah pengguna pada akhirnya mendapat jawaban yang benar. Lapisan kedua adalah generator success: apakah generator berperilaku semestinya dengan masukan yang diterimanya. Secara formal, yang kedua adalah kualitas bersyarat: seberapa memadai perilaku model terhadap hasil pencarian yang diberikan, bukan secara umum.
Perbedaannya sangat mendasar. Sistem bisa menghasilkan jawaban benar meskipun pencariannya buruk — generator menebak dari memori parametriknya. Secara formal ini adalah keberhasilan tugas, tetapi perilakunya tidak tepat: sistem menjawab tanpa bersandar pada sumber, dan pada kueri lain kebiasaan seperti ini akan berujung pada halusinasi. Sebaliknya: pencarian menemukan semua yang dibutuhkan, generator menjawab dengan rapi — tetapi hasilnya tetap salah, karena pertanyaannya dipahami secara keliru. Metrik end-to-end tidak membedakan kedua kasus ini, metrik bersyarat membedakannya.
Abstain bukanlah kegagalan, melainkan keputusan
Elemen ketiga dari model ini adalah abstention behavior, perilaku menahan diri. Dalam konteks RAG, menolak menjawab kadang merupakan satu-satunya reaksi yang benar: jika tidak ada apa pun yang relevan di basis data, "saya tidak tahu" yang jujur lebih baik daripada karangan yang penuh keyakinan. Namun penolakan yang sama menjadi kesalahan ketika dokumen yang dibutuhkan telah ditemukan, tetapi sistem tidak memanfaatkannya.
Karena itu, abstain tidak bisa dinilai terlepas dari hasil pencarian — hanya secara bersyarat. Model The RAT memperhitungkan hal ini secara langsung: ia melihat apakah fakta penolakan atau jawaban cocok dengan apa yang sebenarnya ada dalam konteks. Pandangan seperti ini juga berguna untuk keputusan produk: jika sistem secara massal menahan diri padahal pencariannya berhasil, masalahnya bukan pada generator, melainkan pada bagaimana konteks disampaikan kepadanya.
Mengapa metrik marginal menipu
Para penulis menerapkan kerangka ini pada 27 konfigurasi — tiga himpunan data, tiga retriever, dan tiga generator, yang dikombinasikan dalam semua kemungkinan. Pencacahan menyeluruh di sini bukanlah tujuan akhir: ia menunjukkan bagaimana dekomposisi berperilaku ketika tepat satu mata rantai berubah, sementara yang lain tetap.
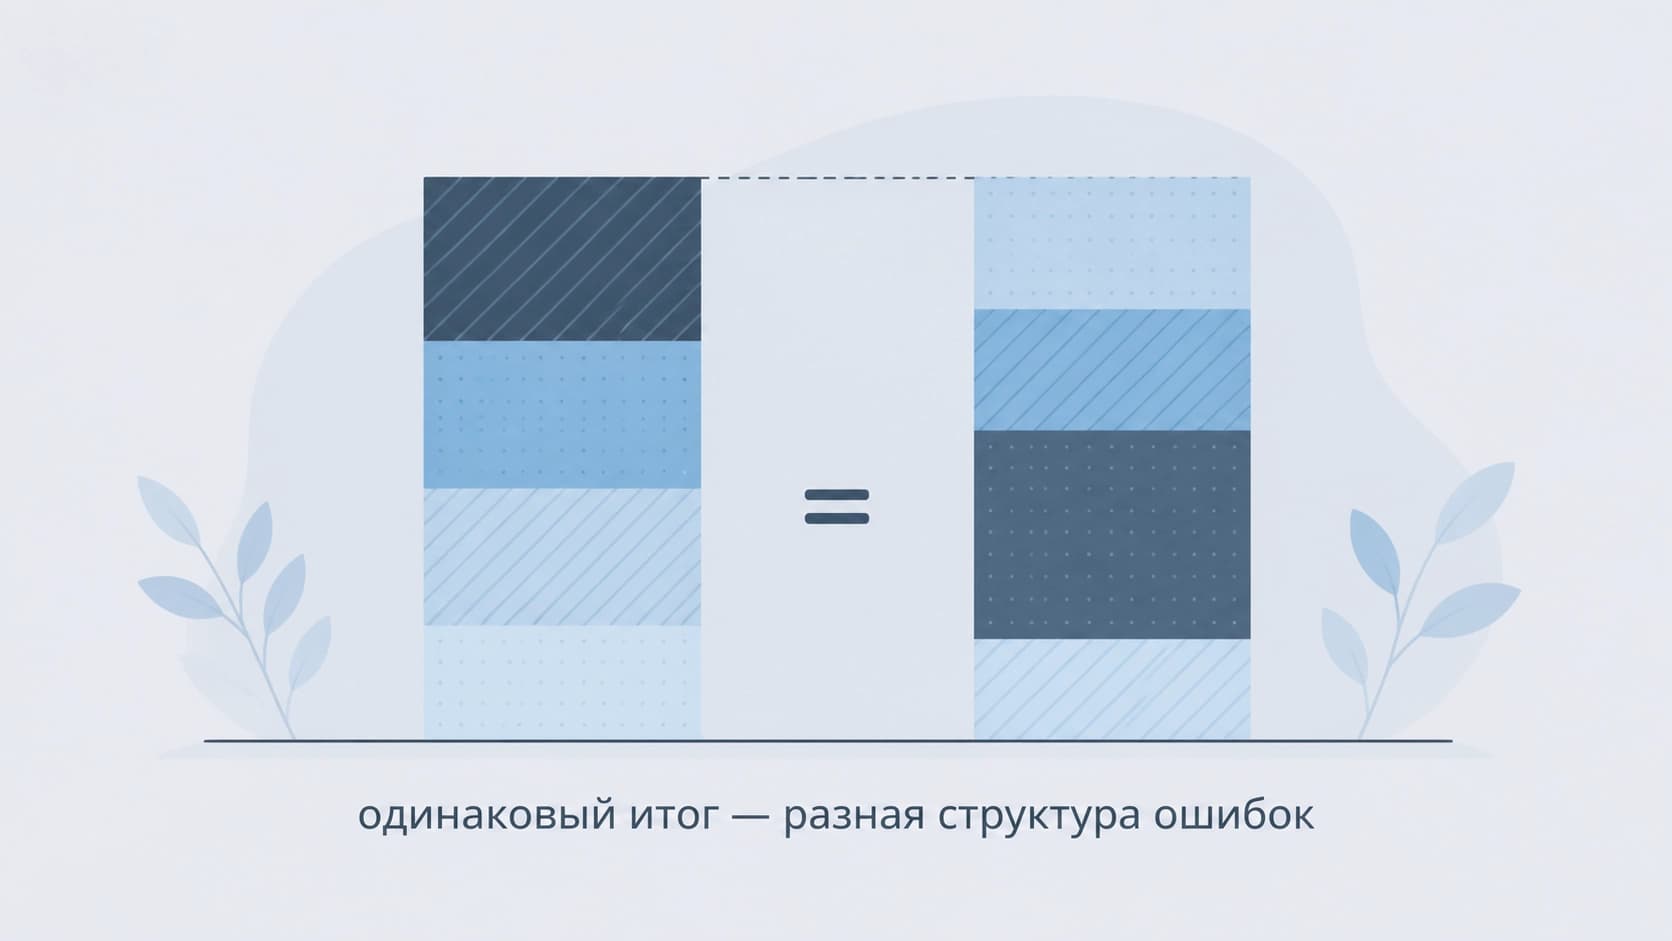
Hasil yang menjadi alasan utama semua ini: dekomposisi bersyarat mengungkap perbedaan perilaku yang mencolok antara sistem-sistem yang tampak setara menurut metrik marginal. Dua pipeline bisa menunjukkan proporsi jawaban benar yang sama, namun berbeda puluhan persen dalam hal di mana tepatnya mereka melakukan kesalahan — pada pencarian, pada kebijakan penolakan, atau pada generasi. Bagi orang yang memilih konfigurasi untuk produk, keduanya adalah sistem yang berbeda; bagi orang yang melihat satu angka di tabel, keduanya sama.
Ke mana anggaran anotasi harus dialokasikan
Bagian tersendiri dari karya ini dikhususkan untuk distribusi anotasi. Anotasi itu mahal, dan wajar untuk bertanya: jika orang hanya bisa diberi satu pertanyaan tentang setiap contoh, pertanyaan mana yang harus dipilih?
Jawaban para penulis: anotasi tentang keberhasilan pencarian lebih informatif daripada anotasi tentang keberhasilan tugas, jika tujuannya adalah menilai kepatuhan sistem terhadap kebijakan (policy adherence). Alasannya bukan soal kemudahan, melainkan struktur model: anotasi pencarian melekat pada variabel yang berada di awal rantai kausal, sehingga lapisan di bawahnya pun "tersorot" olehnya. Anotasi keberhasilan akhir berkaitan dengan variabel di keluaran, dan jauh lebih sedikit berbicara tentang apa yang terjadi di dalam. Para penulis memberikan penjelasan teori-informasi untuk efek asimetris ini.
Kesimpulan praktisnya sederhana: jika anggaran terbatas, yang sebaiknya ditanyakan kepada penganotasi bukanlah "apakah jawabannya benar", melainkan "apakah yang dibutuhkan ditemukan". Yang pertama lebih enak didengar dalam laporan, yang kedua lebih berguna untuk diagnosis.
LLM sebagai hakim sebagai pengamatan yang bising
Bagian ketiga adalah perluasan model ke penilaian otomatis. Skema The RAT memungkinkan menyertakan putusan LLM-as-a-judge bukan sebagai pengganti manusia, melainkan sebagai pengamatan bising yang terkalibrasi: hakim memiliki probabilitasnya sendiri untuk keliru, dan probabilitas itu diestimasi dalam kerangka model probabilistik yang sama.
Hal ini menghapus pertentangan artifisial antara "anotasi manusia yang mahal versus penilaian otomatis yang murah". Dalam satu model, kita bisa menyimpan korpus kecil penilaian ahli yang menetapkan skala dan kalibrasi, serta aliran besar penilaian otomatis yang menyempurnakan parameter. Hakim tidak lagi menjadi oracle, melainkan menjadi salah satu sumber sinyal — dengan galat yang diketahui dan, yang penting, dapat diukur.
Apa yang perlu dibawa ke praktik Anda
- Jangan anggap pipeline sebagai satu simpul. Begitu laporan memuat metrik tersendiri untuk pencarian, tersendiri untuk perilaku generator, dan tersendiri untuk penolakan, perdebatan "apa yang rusak" berubah menjadi diagnosis, bukan penelusuran hipotesis.
- Nilailah perilaku secara bersyarat. Kebenaran jawaban dan kelayakan perilaku pada konteks tertentu adalah dua pertanyaan yang berbeda, dan hasil akhir yang baik tidak membenarkan proses yang buruk.
- Susun laporan berdasarkan irisan, bukan rata-rata. Dua sistem dengan kualitas end-to-end yang sama bisa memerlukan perbaikan yang sama sekali berbeda.
- Pilih apa yang dianotasi. Jika sumber daya manusia terbatas, anotasi tahap awal memberikan lebih banyak informasi tentang sistem secara keseluruhan.
- Kendalikan penilaian otomatis. LLM sebagai hakim berguna sebagai pengamatan dengan model galat, bukan sebagai kebenaran mutlak.
Pandangan Bayesian di sini berharga bukan karena matematikanya semata, melainkan karena disiplin berpikirnya: ia memaksa kita menyebutkan sejak awal besaran mana yang tersembunyi, mana yang teramati, dan bagaimana yang satu berhubungan dengan yang lain. Setelah itu, tabel hasil apa pun berhenti menjadi sekumpulan angka dan menjadi deskripsi tentang bagaimana sistem mengambil keputusan.


