
Singkatnya: apa yang sebenarnya dirilis
Pada akhir Agustus 2026, tim LAION merilis LAION-BVD — korpus video terbuka yang dalam pracetaknya dijelaskan sebagai kumpulan data berskala tak tertandingi untuk pelatihan multimodal. Karya ini muncul di arXiv pada 25 Agustus 2026, dengan kategori — visi komputer, kecerdasan buatan, dan pembelajaran mesin.
Angka-angkanya terlihat seperti ini:
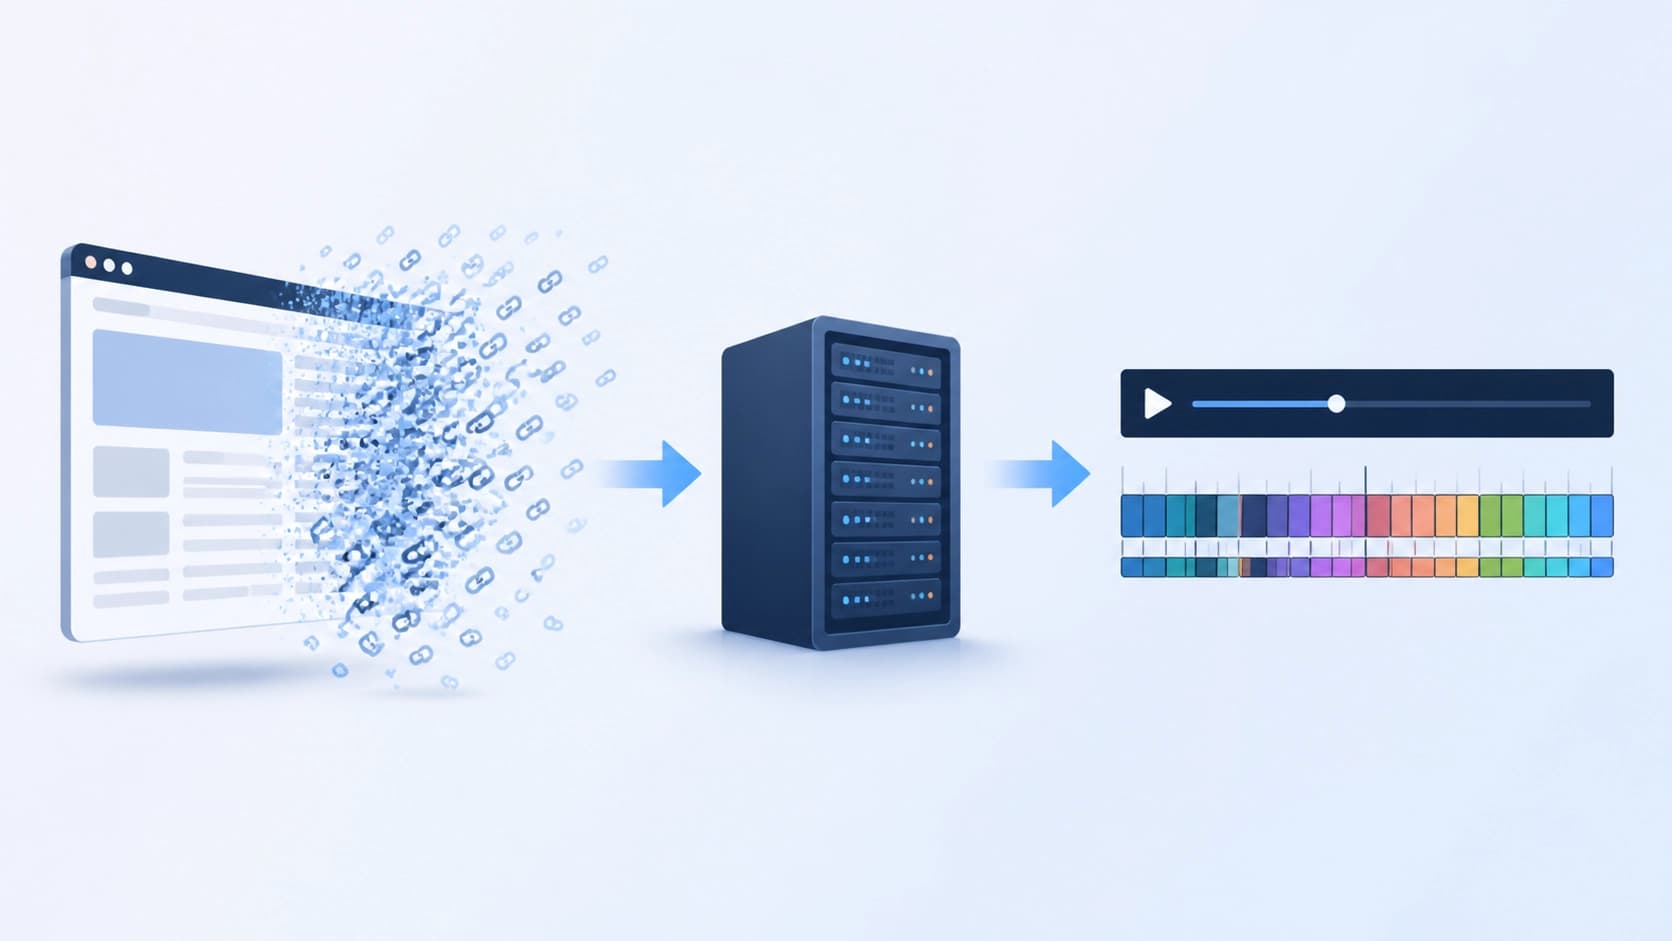
- 1,3 miliar tautan video — titik awal pengumpulan, tautan ditarik dari perayapan web CommonCrawl dan dikaitkan dengan platform tertentu;
- 80 juta klip benar-benar diunduh dari tautan tersebut — tidak semua yang ditemukan di indeks bertahan hingga tahap pengunduhan;
- 10 juta jam total durasi.
Angka terakhir sulit dicerna: itu lebih dari seribu tahun menonton tanpa henti. Itulah sebabnya rilis ini disebut sebagai pergeseran dalam hal apa yang tersedia bagi peneliti tanpa anggaran korporat — sebelumnya korpus video dengan volume sebanding tetap tersimpan di dalam laboratorium tertutup.
Bagaimana ini dikumpulkan
Dari tautan hingga klip siap pakai
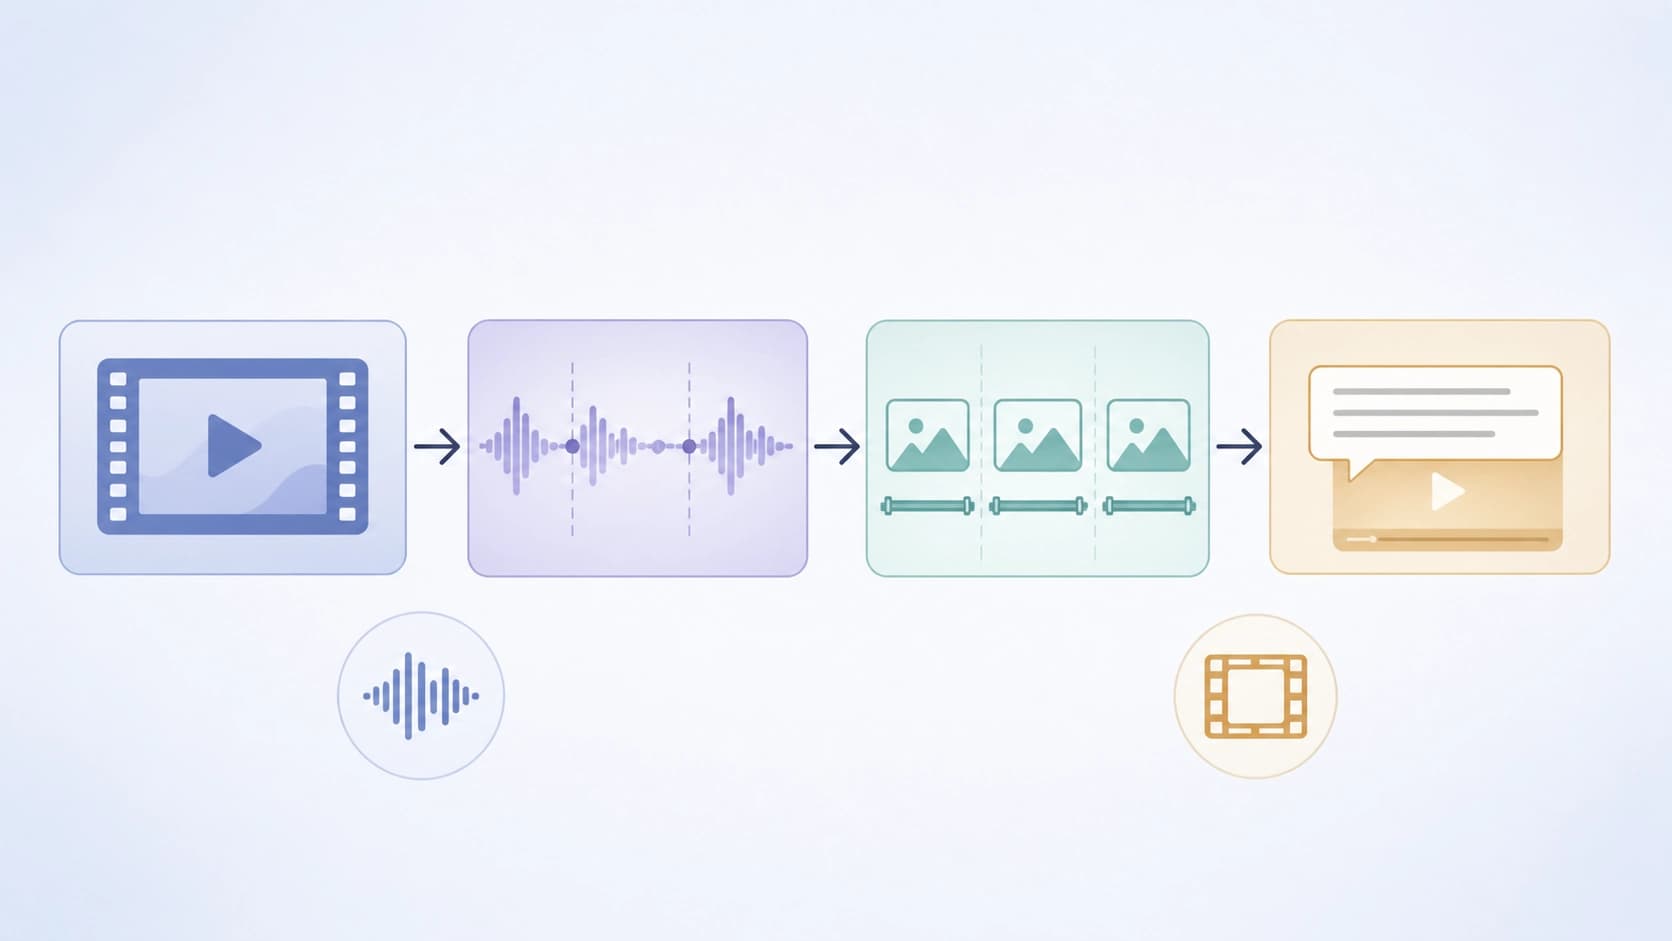
Pipeline terdiri dari beberapa tahap, dan masing-masing penting dengan caranya sendiri. Pertama, tautan dipilih dan diseragamkan formatnya. Lalu dimulai pengunduhan massal. Setelah itu masuklah deteksi adegan yang sensitif terhadap isi bingkai: video panjang dipotong bukan berdasarkan timecode tetap, melainkan berdasarkan sambungan penyuntingan yang sebenarnya.
Selanjutnya — bagian yang paling menarik. Untuk klip yang diperoleh, keterangan dihasilkan secara sintetis, otomatis, dan langsung dalam dua modalitas: pasangan teks untuk rangkaian video dan pasangan terpisah untuk trek audio. Artinya, audio di sini bukan produk sampingan, melainkan sinyal pelatihan yang utuh.
Konstruksi akhirnya dirancang untuk prapelatihan pada tiga jenis data sekaligus: video, audio, dan gambar.
Bingkai sebagai sumber daya tersendiri
Penulis tidak berhenti pada klip saja. Dari adegan, bingkai yang sesuai dengan momen pergantian diekstraksi dan disajikan sebagai sumber pasangan "gambar — teks" yang mandiri. Logikanya sederhana: rangkaian video memberikan irisan dunia visual yang berbeda dari kumpulan gambar web biasa — dengan distribusi alur cerita, sudut pandang, dan detail keseharian yang berbeda. Untuk tugas pencarian berbasis gambar, pergeseran distribusi seperti ini bisa jadi lebih berguna daripada sejuta foto tambahan dari sumber yang sama seperti sebelumnya.
Apa yang ditunjukkan eksperimen
Video dan suara
Model yang dilatih pada korpus baru ini mencapai tingkat kompetitif dalam benchmark standar untuk pasangan "video — teks" dan "audio — teks". Yang lebih penting lagi: ketika volume data atau ukuran model ditingkatkan, kualitasnya tumbuh secara konsisten. Inilah ciri yang membedakan dataset yang "sekadar besar" dari dataset yang layak untuk diskalakan lebih jauh.
Gambar
Lini eksperimen tersendiri — pelatihan pada bingkai yang diekstraksi. Di sini hasilnya juga positif: performa kuat dalam pencarian berbasis gambar. Padahal distribusi bingkainya jauh berbeda dari korpus web yang biasa — artinya keuntungannya bukan berasal dari volume semata, melainkan dari karakter data visual yang berbeda.
Hal yang perlu diingat
- Keterangannya sintetis: menghemat ribuan jam kerja manusia, tetapi membawa noise dan kesalahan sistematis. Kualitas penyaringan di sini lebih penting daripada ukuran korpus.
- Pengumpulannya dimulai dari tautan web, yang berarti muncul pertanyaan-pertanyaan yang biasa bagi proyek semacam ini: keawetan tautan, syarat penggunaan sumber asli, atribusi. Lisensi terbuka dataset tidak menghapus pertanyaan terhadap sumber primernya.
- Korpus ini dinyatakan sebagai rilis riset — dalam praktiknya ini berarti ambang masuknya lebih rendah daripada kumpulan data internal korporat, tetapi reproduksibilitas hasil orang lain tetap harus diverifikasi sendiri.
Mengapa ini penting
Hingga kini, video multimodal terbuka dalam volume sebesar ini lebih merupakan janji daripada kenyataan: kumpulan data akademis diukur dalam ribuan jam, sedangkan semua yang diukur dalam jutaan jam dimiliki perusahaan dan tidak keluar ke publik. LAION-BVD mengubah aritmetika ini — dan bersamanya, standar bagi mereka yang membangun model mereka sendiri.
Ada beberapa konsekuensi praktis. Pertama, muncul dasar untuk perbandingan yang jujur: jika semua orang berlatih pada korpus terbuka yang sama, perdebatan tentang hasil siapa yang lebih baik menjadi lebih bermakna. Kedua, tim kecil dan universitas memiliki alternatif selain menyewa embedding milik orang lain — mereka bisa melatih modelnya sendiri. Ketiga, audio berhenti menjadi pelengkap video dan mendapatkan lini pelatihannya sendiri.
Pertanyaan utama sekarang bukanlah apakah datanya cukup, melainkan siapa yang pertama belajar membersihkannya. Keterangan sintetis, puluhan juta klip, dan sampah yang tak terhindarkan dalam sampel menjadikan penyaringan dan penilaian kualitas sebagai titik sempit dari seluruh upaya ini. Datasetnya terbuka — selanjutnya semuanya bergantung pada komunitas.


