Mengapa agen membutuhkan pengukuran lain
Sebagian besar benchmark agen menjawab pertanyaan yang jelas: apakah model memilih alat yang tepat, apakah ia menyusun argumen dengan benar, apakah ia mencapai hasil yang diinginkan. Hampir semua pengukuran semacam itu dibangun di sekitar eksekusi berurutan — satu panggilan demi satu panggilan, tanpa tergesa-gesa dan tanpa persaingan memperebutkan sumber daya.
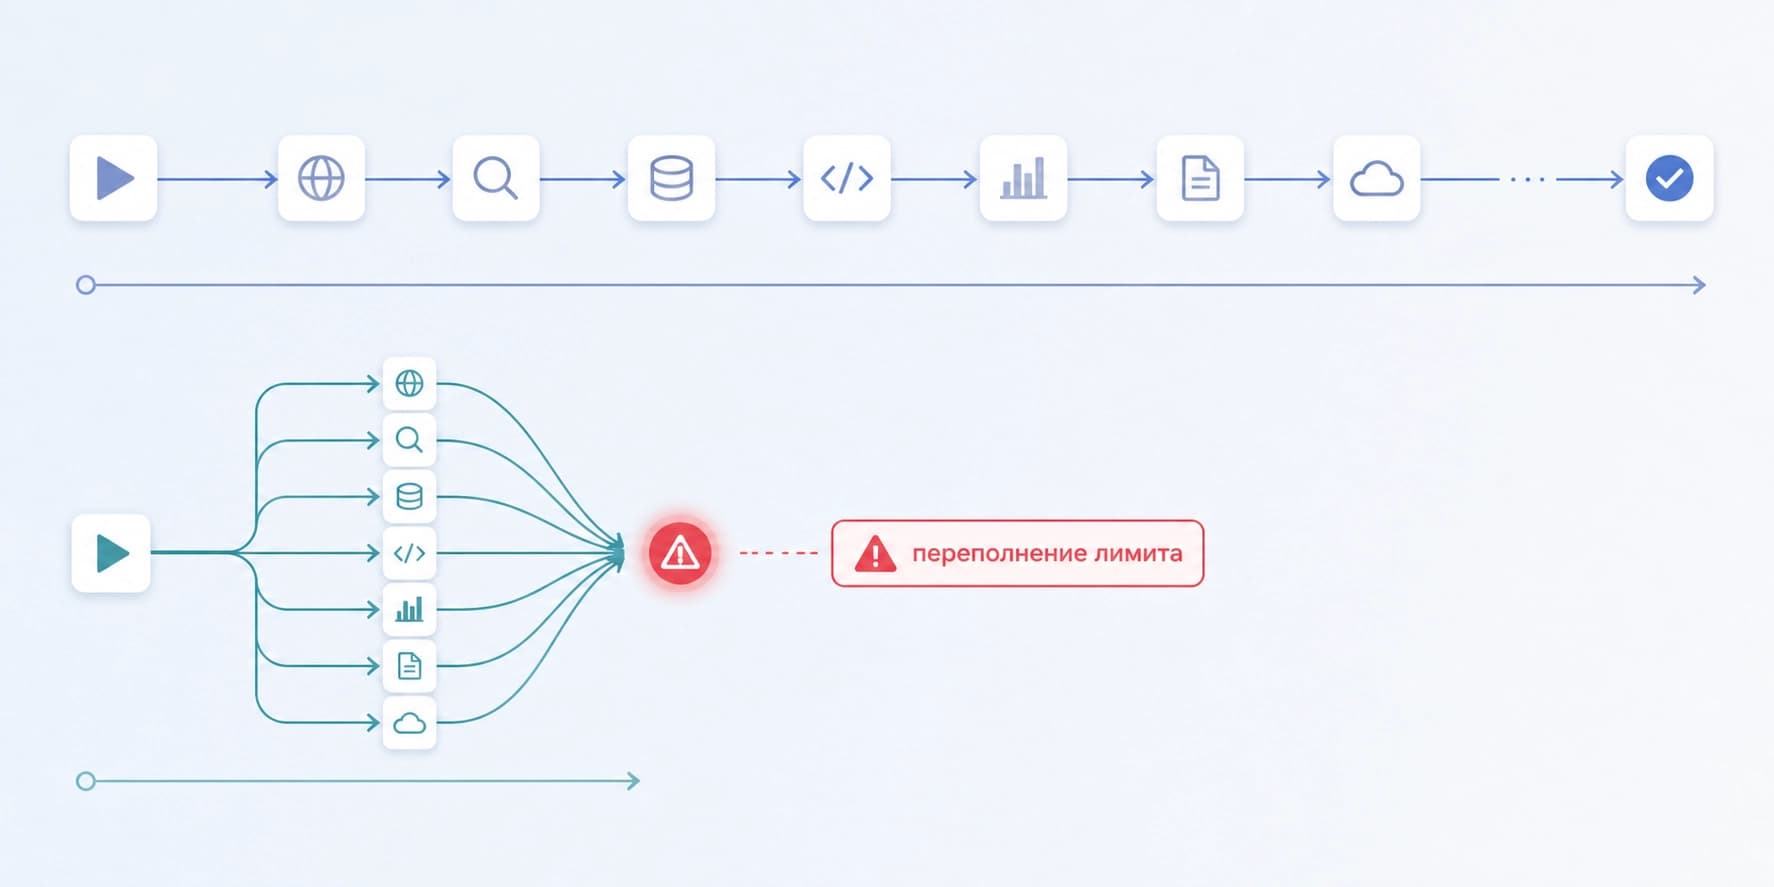
Operasi nyata terlihat berbeda. Agar tetap berada dalam latensi yang dapat diterima, agen harus menjalankan panggilan-panggilan independen secara paralel. Namun paralelisme tanpa memperhatikan batas akan menabrak dinding lain: kuota yang habis, memori yang meluap, layanan eksternal yang tumbang.
PeakBench — justru tentang zona buta ini. Para penulis Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan, dan Han-Jia Ye mendeskripsikannya dalam pracetak arXiv:2608.24509 (v1 tanggal 25 Agustus 2026, kategori cs.AI dan cs.SE); kode dijanjikan akan dirilis bersama artikelnya.
Gagasan kunci yang menjadi akar seluruh karya ini: agen memiliki dua cara untuk gagal, dan keduanya berlawanan. Eksekusi berurutan aman, tetapi lambat — batas tidak terlampaui hanya karena tidak ada yang dilakukan secara bersamaan. Paralel tanpa memperhitungkan sumber daya memang cepat, tetapi menyebabkan luapan yang sebenarnya mudah dihindari. Di antara kedua kutub inilah terletak apa yang belum pernah diukur dengan benar oleh siapa pun.
Apa isi benchmark ini
Alih-alih tugas statis dengan jawaban acuan, di sini digunakan alur kerja multi-alat yang dapat dieksekusi. Masing-masing memiliki dua tambahan penting: anotasi dependensi yang menunjukkan langkah mana yang benar-benar saling terkait, dan profil sumber daya yang terukur — berapa banyak memori, waktu, atau kuota yang dihabiskan oleh panggilan tertentu.
Konstruksi semacam ini mengubah objek penilaiannya sendiri. Pertanyaan "apakah jawabannya benar" bergeser ke latar belakang, dan yang tampil ke depan adalah pertanyaan "bagaimana agen menata pekerjaan dalam waktu dan apakah ia melampaui anggaran".
Perencanaan logis versus fisik
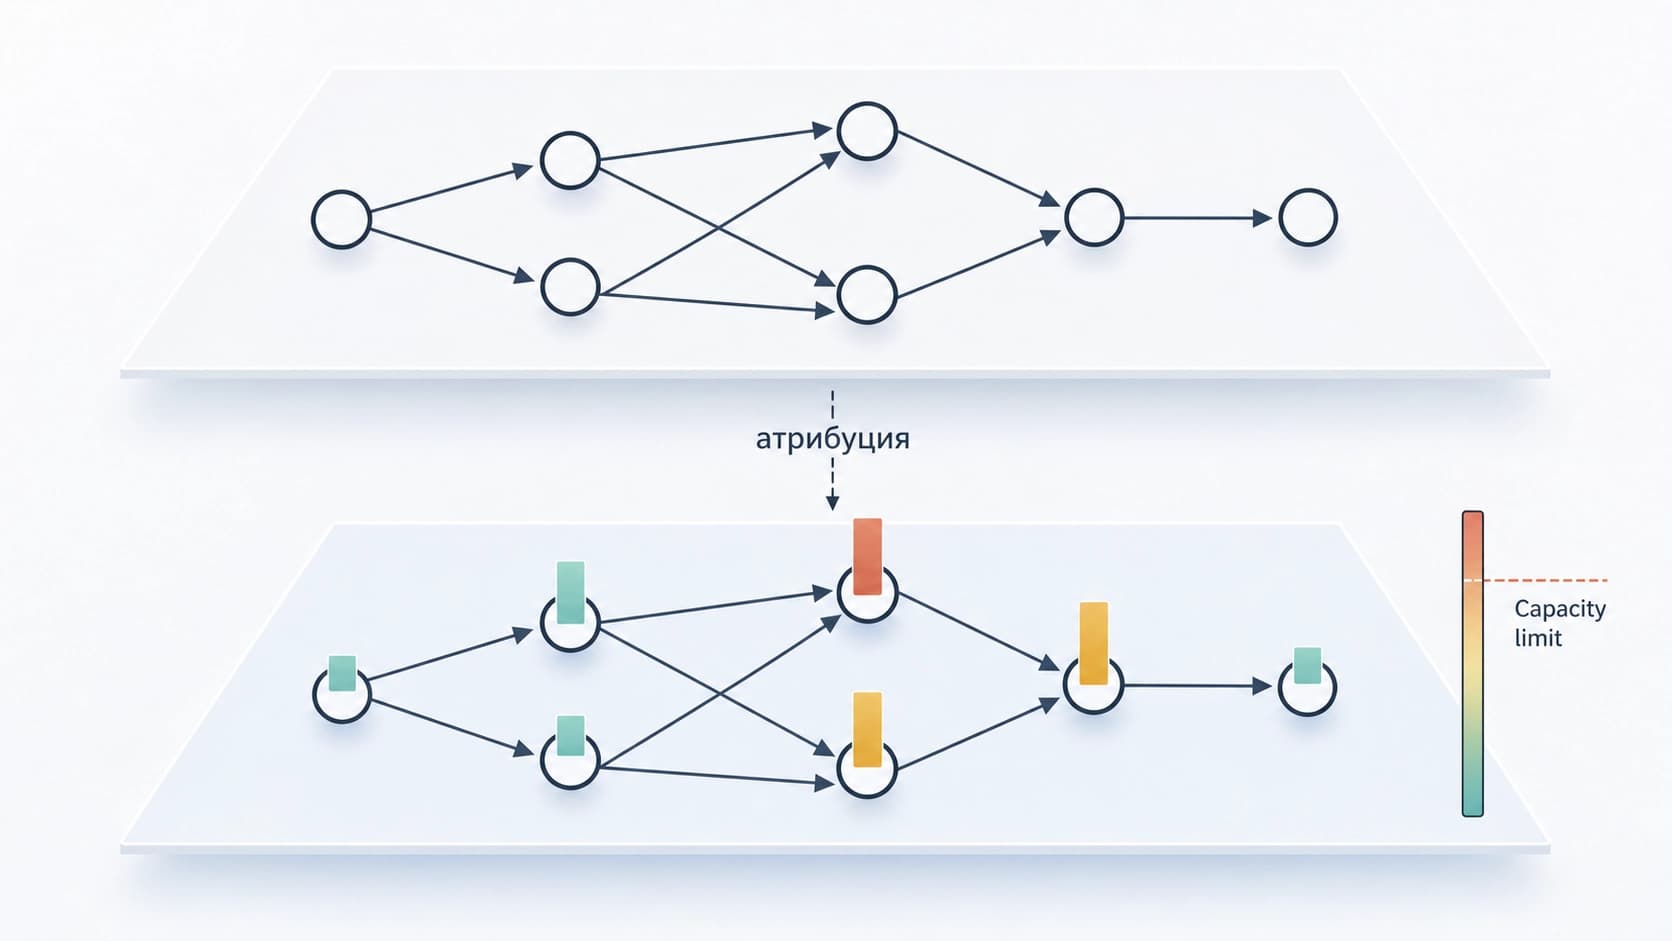
Kompleksitas utama dalam menilai proses semacam ini adalah atribusi. Ketika sebuah eksekusi gagal, tidak jelas apa yang sebenarnya bersalah: agen salah memahami dependensi, atau memahaminya dengan benar tetapi tidak memperhitungkan sumber daya yang tersedia, atau keduanya sekaligus. Menumpuk semuanya ke dalam satu metrik keberhasilan berarti kehilangan hal yang paling berguna.
Karena itu penilaian dibagi menjadi dua bagian. Satu dimensi bertanggung jawab atas perencanaan logis: urutan langkah, kebenaran dependensi, tidak adanya keterkaitan yang dibuat-buat. Dimensi lain — atas perencanaan fisik, yaitu penjadwalan dengan mempertimbangkan batasan nyata. Metrik kedua dimensi ini berbeda, dan kegagalan di satu sisi tidak menutupi keberhasilan di sisi lain.
Urutan yang salah dan anggaran yang salah — penyakit yang berbeda
Skema dua bagian ini diperlukan bukan demi taksonomi yang indah, melainkan demi diagnosis. Jika agen melakukan kesalahan pada tingkat logika, tidak ada gunanya menceritakan kepadanya tentang ukuran kuota — ia tidak memahami apa yang bergantung pada apa. Jika logikanya benar tetapi eksekusinya gagal, masalahnya ada pada penjadwal atau pada cara sumber daya yang tersedia disampaikan kepada agen.
Implikasi praktis bagi mereka yang membangun sistem agen: sebelum memperbaiki apa pun, ada baiknya memahami ke lapisan mana dari kedua lapisan ini kegagalan itu termasuk. Prompt engineering, pelatihan pada trajektori, dan perbaikan alat akan menyembuhkan kerusakan yang sama sekali berbeda.
Hasil utama: logika yang rapi tidak menyelamatkan dari kelebihan beban
Kesimpulan paling tidak menyenangkan dari karya ini berbunyi demikian: perencanaan logis yang kuat tidak menjamin eksekusi yang aman maupun efisien dalam kondisi keterbatasan sumber daya. Agen dapat menyusun graf dependensi dengan sempurna — dan tetap saja menjatuhkan sistem dengan menjalankan sekaligus semua yang tidak terhubung oleh sisi.
Pengungkapan sumber daya menurunkan jumlah luapan yang dapat dicegah
Pengamatan kedua: jika agen diberi informasi tentang sumber daya yang tersedia, jumlah luapan yang dapat dicegah menurun, dan utilisasi meningkat. Ini bukan sihir dan bukan arsitektur baru — hanya saja ke dalam konteks tidak hanya dimasukkan deskripsi alat, tetapi juga anggaran yang harus dipenuhi.
Di sini penting untuk tidak melebih-lebihkan efeknya. Yang dimaksud adalah bahwa transparansi sumber daya merupakan intervensi yang murah dan berfungsi, bukan bahwa hal itu menyelesaikan masalah secara keseluruhan: agen tetap harus memanfaatkan informasi tersebut dengan cermat.
Untuk siapa ini berguna
Benchmark ini dirancang sebagai landasan untuk mendiagnosis perilaku agen yang sadar sumber daya, dan itulah tujuan utamanya. Ia tidak sekadar memberikan skor akhir, melainkan menunjukkan di mana tepatnya model itu patah: pada pemahaman dependensi atau pada disiplin pengeluaran.
Dari sini muncul beberapa skenario penggunaan. Bagi pengembang kerangka kerja agen — cara untuk menguji penjadwal sebelum produksi, bukan setelah insiden. Bagi peneliti — pengaturan yang dapat direproduksi untuk eksperimen dengan anggaran dalam konteks. Bagi mereka yang memilih model untuk tugas dengan batas ketat — kesempatan untuk melihat perbedaan antar model yang tidak ditunjukkan oleh tes keberhasilan biasa.
Apa yang perlu diingat
Pendekatan ini memiliki biaya masuk yang jelas: profil sumber daya perlu diukur, dan dependensi perlu dianotasi. Dalam sistem nyata, batas itu berisik, layanan eksternal mengubah perilaku di bawah beban, dan biaya panggilan tidak selalu diketahui sebelumnya. Ketelitian laboratorium di sini lebih tinggi daripada di medan nyata, dan tidak sepatutnya memindahkan kesimpulan begitu saja ke produksi.
Namun kerangka ini sendiri tetap berguna bahkan tanpa benchmark. Dua pertanyaan — "apakah agen memahami dengan benar apa yang bergantung pada apa" dan "apakah ia memenuhi anggaran" — masuk akal untuk diajukan pada sistem agen mana pun, bahkan jika tidak ada landasan siap pakai untuk mengujinya.