
Rantai penalaran yang pendek tidak selalu lebih baik
Model besar yang dilatih untuk "berpikir keras" unggul berkat rantai penalaran yang panjang. Semakin kompleks tugasnya, semakin banyak langkah perantara yang dituliskan model sebelum memberikan jawaban. Salah satu mekanisme yang dianggap kunci bagi kualitas semacam itu adalah refleksi diri: kemampuan untuk menoleh ke belakang pada langkah-langkah yang sudah dilakukan, menyadari kesalahan, dan menulis ulang alur penyelesaian.
Masalahnya, kemampuan ini ada harganya. Setiap tindakan peninjauan ulang berarti token tambahan saat inferensi — artinya, biaya, waktu, dan sumber daya komputasi. Padahal hingga belum lama ini, belum ada yang benar-benar menjelaskan apa sebenarnya yang mengendalikan keputusan model untuk "berhenti dan memeriksa ulang dirinya". Refleksi diri semacam kotak hitam di dalam kotak hitam: diketahui bahwa ia bekerja, tetapi tidak dipahami bagaimana caranya.
Karya Ge Yan, Chung-En Sun, Linbo Liu, dan Tsui-Wei Weng (arXiv:2512.13979, diterima di COLM 2026) mendekati persoalan ini dari sisi yang tak terduga — bukan melalui prompt dan bukan melalui fine-tuning, melainkan melalui representasi laten model.
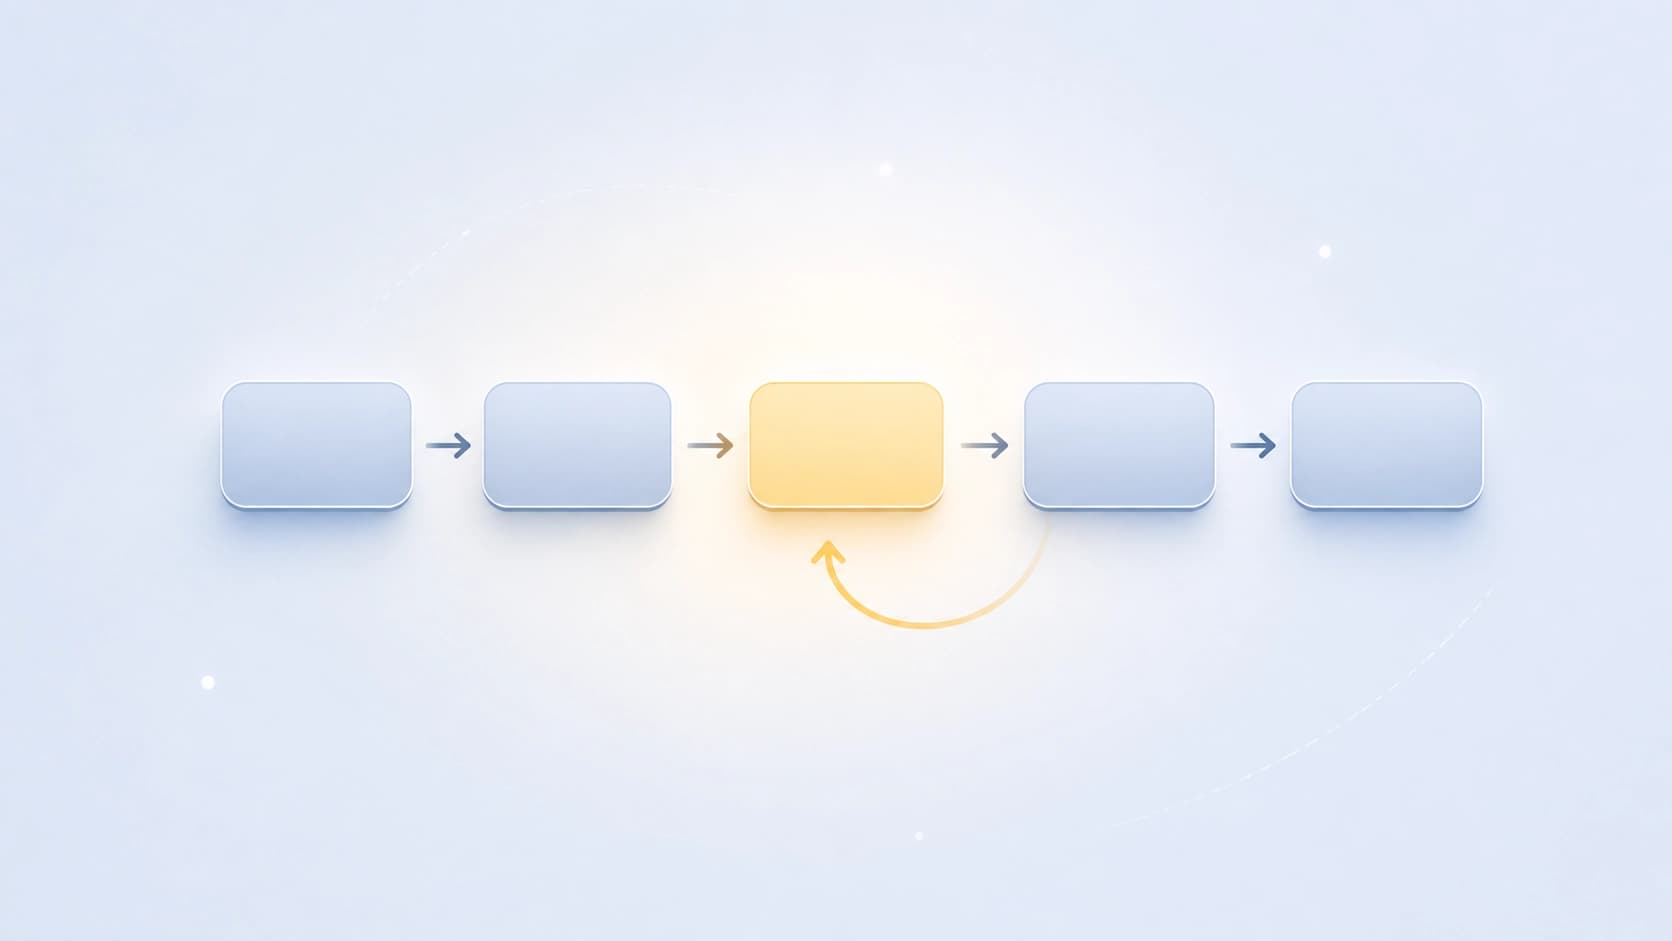
Arah refleksi di dalam model
Apa yang dicari dan apa yang ditemukan
Para peneliti menerapkan perangkat representation engineering pada refleksi diri — sebuah bidang yang mempelajari bukan teks keluaran model, melainkan aktivasi internalnya. Logikanya sederhana: jika model "memutuskan" untuk berefleksi, keputusan itu tercermin di suatu tempat dalam representasinya. Berarti keputusan itu bisa ditemukan, dijelaskan, dan — yang terpenting — dimanfaatkan.
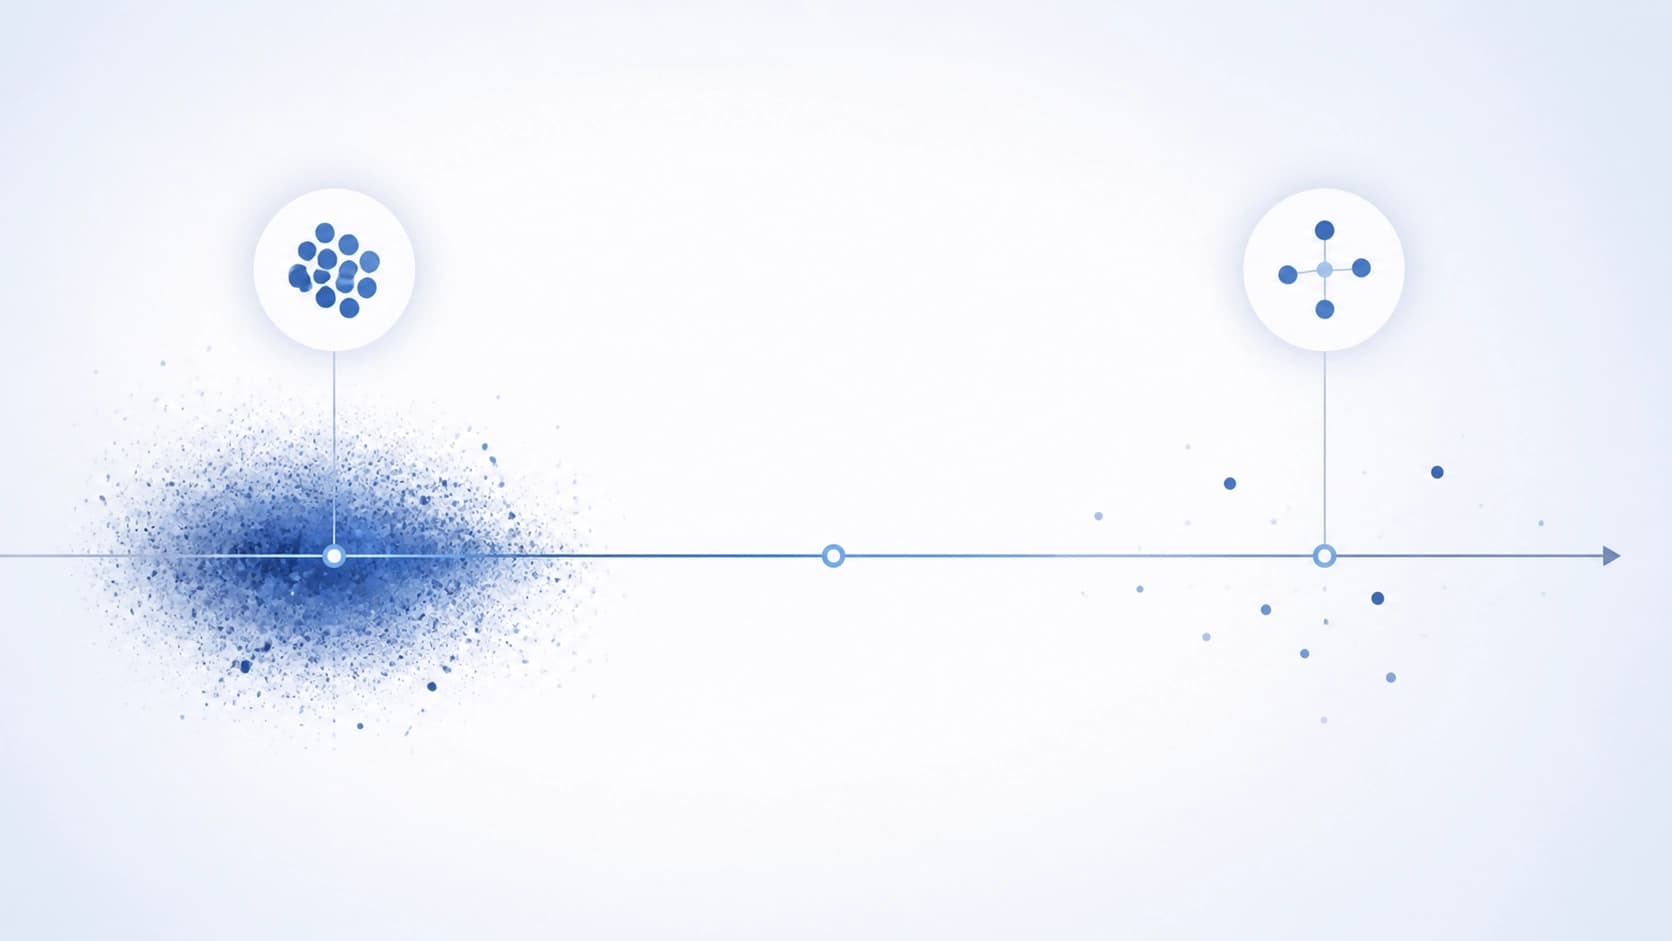
Ternyata memang demikian. Di ruang laten ditemukan sebuah arah khusus yang memisahkan langkah-langkah dengan refleksi dari langkah-langkah tanpa refleksi. Pada dasarnya ini adalah sumbu "periksa ulang / jangan periksa ulang", dan posisi titik pada sumbu ini secara konsisten membedakan kedua jenis langkah tersebut.
Refleksi dikendalikan oleh ketidakpastian
Pengamatan paling menarik dari artikel ini: besarnya aktivasi di sepanjang arah yang ditemukan mampu memprediksi dengan baik apakah jawaban akhirnya akan benar. Dengan kata lain, refleksi tidak aktif secara acak dan tidak berdasarkan jadwal — ia terikat pada ketidakpastian internal model. Ketika model "merasa" bahwa situasinya licin, ia melambat dan meninjau ulang; ketika semuanya jelas, ia melanjutkan.
Ini adalah pergeseran penting dalam cara pandang. Refleksi berhenti menjadi kemampuan tersendiri yang perlu dikembangkan, dan lebih menjadi semacam sinyal — indikator bahwa model sendiri meragukan langkahnya.
Bagaimana ReflCtrl dirancang
Jika keputusan tentang refleksi hidup di dalam aktivasi, maka keputusan itu bisa dipengaruhi secara langsung — dengan mengintervensi representasi, bukan dengan menulis ulang prompt. Di sinilah ReflCtrl dibangun: sebuah framework yang mengendalikan refleksi diri melalui steering — pergeseran aktivasi di sepanjang arah yang ditemukan.
Detail kuncinya — kapan tepatnya harus melakukan intervensi
Pendekatan naif sudah jelas: menambahkan pergeseran yang diinginkan pada setiap token yang dihasilkan. Itulah hal pertama yang terlintas — dan justru itulah yang bekerja dengan buruk. Tekanan terus-menerus pada representasi mengaburkan kualitas generasi: model kehilangan koherensi, karena intervensi juga terjadi di tempat yang tidak ada gunanya.
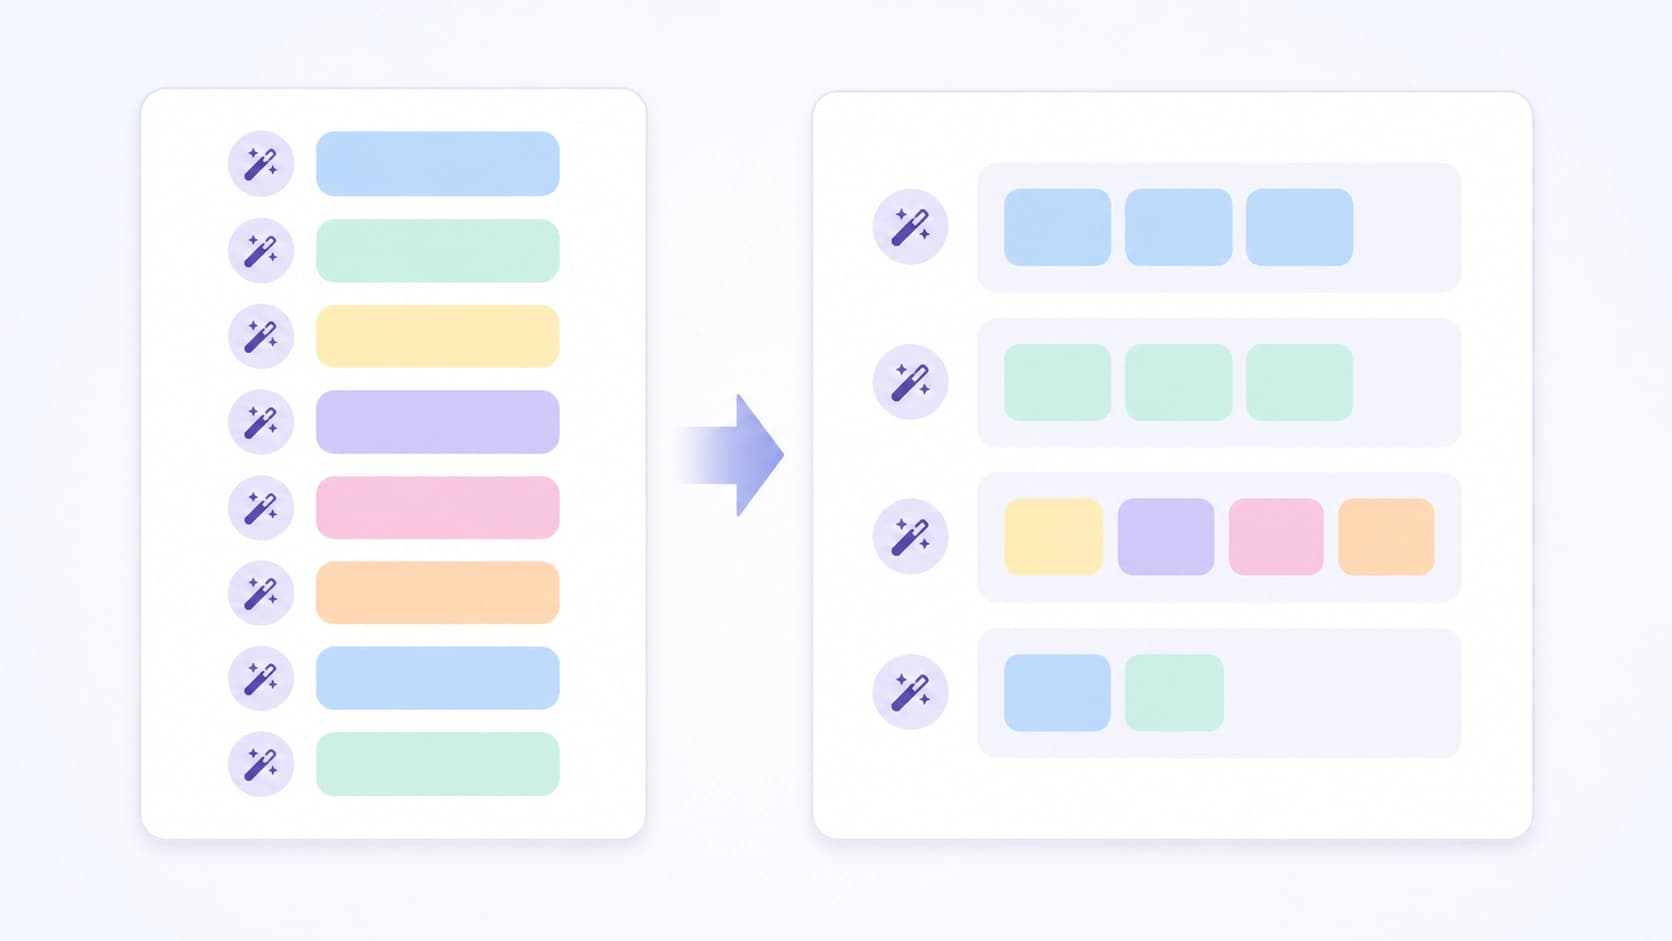
Para penulis mengusulkan varian per langkah (step-level). Intervensi diterapkan tepat satu kali — di awal setiap langkah penalaran yang baru. Setelah itu model menghasilkan token langkah tersebut dengan bebas, tanpa gangguan. Hasilnya adalah penyetelan yang halus: frekuensi refleksi berubah, tetapi alur pemikiran di dalam langkah itu sendiri tetap utuh.
Kombinasi inilah — intervensi yang jarang dan bertitik, bukan yang terus-menerus — yang memberikan keuntungan utama.
Apa yang ditunjukkan eksperimen
Pengujian dilakukan pada benchmark penalaran matematika dan penalaran umum. Hasilnya mengarah pada kesimpulan yang cukup tidak nyaman bagi industri: refleksi sering kali berlebihan.
- Jumlah token penalaran berhasil dipangkas hingga 43,2% dari volume awal — dengan tetap mempertahankan akurasi.
- Efeknya terutama terlihat pada model yang lebih kuat: semakin baik modelnya, semakin sering ia memeriksa ulang dirinya tanpa perlu.
- Steering per langkah secara signifikan mengungguli steering per takt (per-token) tradisional pada anggaran token yang sebanding.
Poin kedua dan ketiga saling berkaitan. Model yang kuat lebih yakin pada langkah-langkahnya, sehingga refleksinya lebih sering menjadi langkah sia-sia — dan steering per takt justru menderita karena tidak mampu berhenti pada waktu yang tepat.
Mengapa ini penting di luar laboratorium
Ekonomi penalaran bukanlah hal yang abstrak. Rantai yang panjang membengkakkan tagihan inferensi, meningkatkan latensi, dan membatasi berapa banyak permintaan yang bisa dilewatkan melalui perangkat keras yang tersedia. Jika hampir separuh "pemikiran" bisa dihilangkan tanpa kehilangan kualitas, itu adalah penghematan langsung pada skala besar.
Ada pula lapisan yang kurang terlihat. Karya ini menunjukkan bahwa perilaku model dapat disetel pada tingkat representasi — lebih halus dan lebih tepat daripada prompt, serta lebih murah daripada fine-tuning. Kemampuan mengendalikan menjadi dimensi rekayasa tersendiri: bukan "apa yang harus ditulis dalam instruksi", melainkan "ke arah mana aktivasi harus digeser dan pada momen apa".
Akhirnya, ini adalah kontribusi bagi interpretabilitas. Kita semakin memahami apa yang sebenarnya terjadi di dalam ketika model berhenti dan berkata pada dirinya sendiri "mari saya tinjau ulang".
Pertanyaan terbuka
Batas penerapannya belum sepenuhnya tergambar. Steering di sepanjang satu arah adalah alat yang sempit: ia menangkap dengan baik sumbu refleksi yang ditemukan, tetapi apa yang harus dilakukan dengan bentuk-bentuk koreksi diri lainnya — belum jelas. Masih ada pula pertanyaan sejauh mana arah yang ditemukan dapat dipindahkan antararsitektur: setiap model memiliki representasinya sendiri, dan belum tentu vektor yang bekerja untuk satu model berguna untuk model lain.
Kompromi antara penghematan dan keandalan pada tugas-tugas yang kesalahannya mahal juga belum sepenuhnya jelas. Memangkas 43,2% token sambil mempertahankan akurasi rata-rata adalah hasil yang kuat, tetapi akurasi rata-rata tidak sama dengan tidak adanya kegagalan katastrofik yang langka. Mencari cara membedakan refleksi yang "berlebihan" dari refleksi tunggal yang menyelamatkan jawaban — kemungkinan besar menjadi tugas berikutnya dalam lini penelitian ini.


