Mengapa RAG agentik terhenti di persimpangan
RAG agentik bekerja sebagai sebuah siklus: model membaca pertanyaan, memutuskan apakah perlu satu kueri pencarian lagi, menerima hasilnya, lalu memilih lagi — mencari lebih jauh atau menjawab. Setiap iterasi tambahan memakan biaya dan waktu, setiap iterasi yang terlewat berisiko menghasilkan jawaban yang tidak lengkap. Artinya, keterampilan utama agen bukanlah mengekstrak dokumen, melainkan kemampuan untuk mengatakan "bukti sudah cukup" pada saat yang tepat.
Pembelajaran penguatan klasik menilai perilaku semacam ini dari luar: jawaban cocok dengan acuan — plus, tidak cocok — minus. Tidak ada yang bertanya tentang apa yang dipikirkan model itu sendiri mengenai kelengkapan fakta yang dikumpulkan. Dari sini muncul dua penyakit yang simetris: kebijakan entah terus menggali ketika di dalam sudah jelas semuanya, atau menghentikan pencarian padahal datanya jelas masih sedikit. Imbalan eksternal tidak membedakan situasi-situasi ini — hasil akhirnya sama, tetapi perilakunya berbeda.
Pergeseran rumusan masalah
Penulis karya MetaRAG mengusulkan untuk melihat bukan hanya tindakan, tetapi juga seberapa jauh tindakan itu selaras dengan keyakinan internal agen tentang kecukupan bukti. Rumusan seperti ini mereka sebut penyelarasan keyakinan dan tindakan — belief-action alignment. Gagasannya sederhana: kualitas keputusan pencarian bukanlah metrik terpisah di atas jawaban, melainkan konsistensi antara apa yang "dipikirkan" model dan apa yang dilakukannya.
Bagaimana MetaRAG disusun
Kerangka kerja ini terdiri dari tiga bagian: verifikasi eksplisit sebelum bertindak, probe keyakinan internal, dan imbalan khusus yang menghubungkan keduanya.
Verifikasi sebelum bertindak
Komponen pertama — Verify-first Action Generation. Alih-alih langsung mengeluarkan langkah berikutnya, kebijakan terlebih dahulu menjalankannya melalui prosedur verifikasi eksplisit: apakah tindakan ini cocok dengan keadaan pencarian saat ini. Idenya adalah menyaring keputusan impulsif sebelum masuk ke dalam trajektori. Pada dasarnya ini adalah "bingkai beku" yang tertanam dalam generasi, yang biasanya tidak dimiliki oleh agen yang cepat.
Probe keyakinan internal
Komponen kedua — Internal Belief Probing. Dari konteks yang sama yang dilihat kebijakan (pertanyaan ditambah riwayat tindakan dan observasi), pendapatnya sendiri dibaca secara terpisah: apakah pertanyaan sudah bisa dijawab sekarang. Yang penting, ini bukan model hakim eksternal dan bukan anotasi dari manusia — sinyalnya diambil dari kebijakan yang sama, hanya saja dengan cara yang berbeda.
Imbalan atas konsistensi dengan pengaman
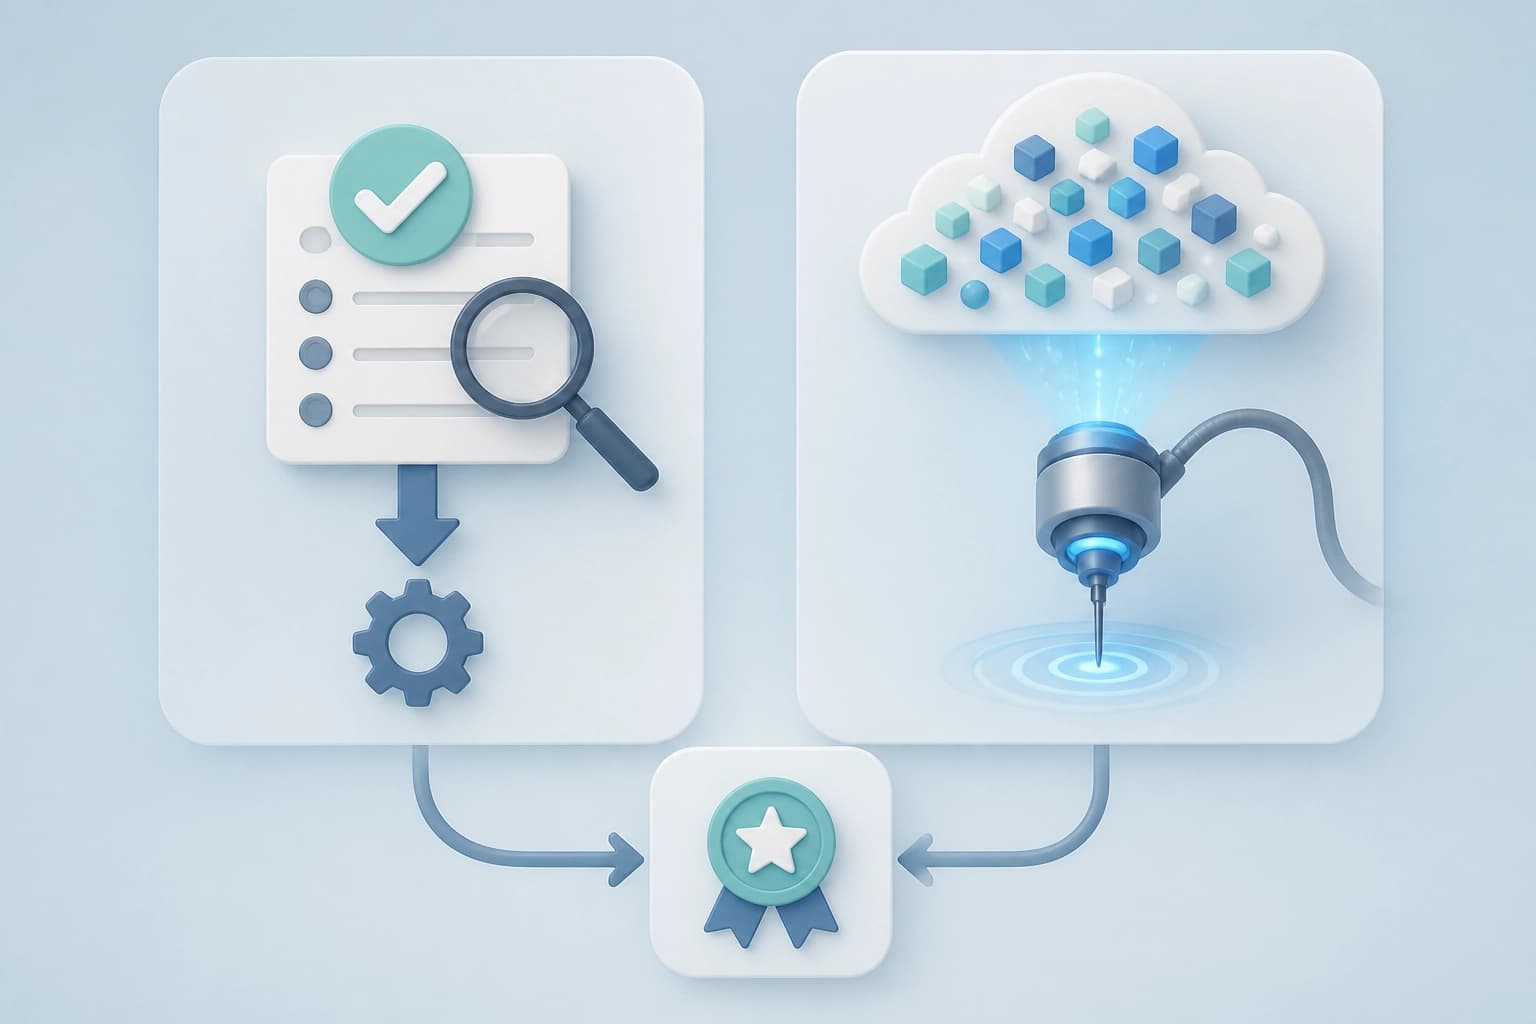
Dari kedua sinyal ini diturunkan consistency reward: agen diberi insentif ketika tindakannya cocok dengan penilaian internalnya tentang kecukupan bukti. Di sini ada jebakan yang jelas — perilaku "salah tapi percaya diri" bisa mulai diberi imbalan jika model melakukan kesalahan secara runtut dan konsisten. Penulis menutupnya dengan gerbang: imbalan atas konsistensi hanya diperhitungkan ketika jawabannya ternyata benar. Dengan kata lain, konsistensi bukanlah tujuan akhir, melainkan pengali terhadap kebenaran.
Satu detail terpisah yang penting bagi praktisi: probe keyakinan hanya hidup pada tahap pelatihan. Pada inferensi ia tidak dipanggil, sehingga tidak ada komputasi tambahan untuk setiap permintaan — biaya overhead tetap nol.
Apa yang ditunjukkan eksperimen
Karya ini diuji pada tujuh benchmark tanya-jawab publik. Hasil yang diklaim adalah peningkatan yang stabil pada kompromi antara akurasi dan efisiensi dibandingkan metode dasar RL yang kuat untuk RAG agentik. Artinya, keuntungannya bukan sekadar menjawab lebih akurat, melainkan tidak membayarnya dengan pencarian tanpa henti.
Selanjutnya penulis menguji seberapa jauh efeknya dapat ditransfer: pada skenario riset mendalam (deep research), pada berbagai optimizer, dan pada berbagai model dasar. Dalam semua konfigurasi ini, menurut data mereka, metode tersebut tetap unggul. Inilah jenis pengujian yang sering kali kurang: peningkatan pada satu model dan satu kumpulan data mudah tertukar dengan penyetelan hyperparameter yang kebetulan berhasil.
Apa artinya dalam praktik
Bagi pengembang sistem pencarian agentik, MetaRAG menunjukkan arah yang lebih murah daripada yang dibayangkan. Jika Anda sudah memiliki pelatihan kebijakan, menambahkan sinyal tentang keyakinan internal tidak memerlukan anotator baru: konteks yang sama yang sudah dilihat kebijakan dapat digunakan sebagai sumber sinyal. Gerbang berdasarkan kebenaran tetap wajib — tanpanya agen bisa belajar untuk salah dengan indah dan percaya diri.
Kesimpulan kedua menyangkut perancangan imbalan secara umum. Metrik eksternal menjawab pertanyaan "apakah berhasil", tetapi hampir tidak mengatakan apa pun tentang "apakah agen sudah tepat pada saat itu". Membedakan kedua hal inilah gagasan utama artikel ini: konsistensi antara keyakinan dan tindakan adalah objek tersendiri yang dioptimalkan secara terpisah, bukan efek samping dari peningkatan akurasi.
Namun, perlu diingat batasannya: eksperimen terbatas pada benchmark QA dan skenario riset mendalam, dan pendekatan ini sendiri dibangun di atas pelatihan RL, sehingga tidak dapat diterapkan "langsung pakai" pada sistem yang kebijakannya tidak dilatih sama sekali. Untuk kasus seperti itu, yang lebih berguna adalah idenya sendiri — memverifikasi tindakan secara eksplisit sebelum dieksekusi dan menilai secara terpisah apakah keputusan itu cocok dengan perasaan internal tentang kecukupan data.
Teks lengkap tersedia sebagai arXiv:2608.24214 (v1, 25 Agustus 2026, bagian cs.AI) — karya ini diterima pada program utama konferensi EMNLP 2026.