
VLA मॉडल VLALight सड़क किनारे के कैमरों के वीडियो से सीधे एंड-टू-एंड एक्शन इन्फ़रेंस के ज़रिए ट्रैफ़िक लाइटों को नियंत्रित करता है
लेखक VLALight प्रस्तुत करते हैं—«विज़न–लैंग्वेज–एक्शन» श्रेणी का एक एंड-टू-एंड मॉडल, जो चौराहे के कैमरों से मिले बहु-दृश्य रिकॉर्डिंग को यातायात प्रवाह की हाथ से निर्धारित अवस्थाओं से गुज़रे बिना सीधे सिग्नल के चरणों में बदलाव में बदलता है। इसकी नींव में जंक्शन की टोपोलॉजी को ध्यान में रखने वाली संयुक्त धारणा, शहरी नेटवर्क स्तर पर सुदृढीकरण अधिगम और तेज़ तथा गहन तर्क के बीच अनुकूली चयन शामिल हैं; तीन शहरों के सात वास्तविक डेटा सेटों पर इस समाधान ने परिवहन मॉडल, सुदृढीकरण अधिगम और LLM/VLM पर आधारित बेसलाइन से बेहतर प्रदर्शन किया।
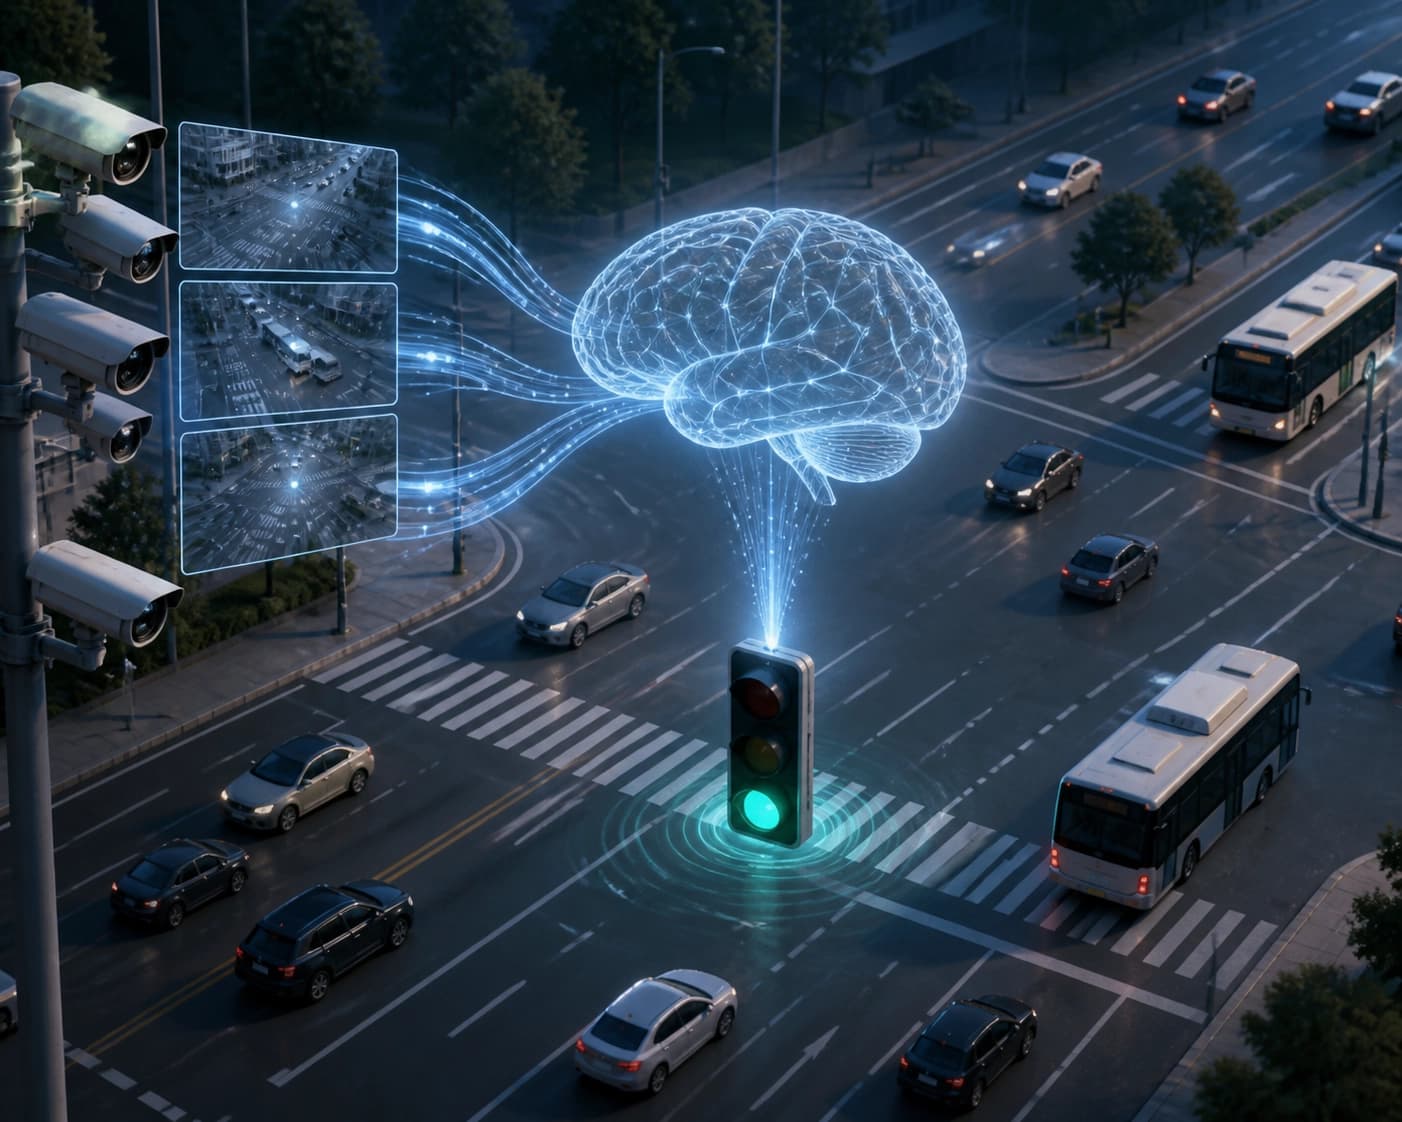
ट्रैफ़िक लाइट नियंत्रण के लिए VLA मॉडल क्या है
VLALight, ट्रैफ़िक लाइट नियंत्रण के लिए एक vision-language-action मॉडल है। लेखक: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu। लेख 29 सितंबर 2026 को प्रस्तुत किया गया। यह सड़क किनारे लगे कैमरों से प्राप्त बहु-दृश्य वीडियो के आधार पर ट्रैफ़िक लाइटों के एंड-टू-एंड नियंत्रण के लिए पहला VLA मॉडल है।
यह मॉडल दृश्य अवलोकनों को सीधे समन्वित ट्रैफ़िक लाइट क्रियाओं में बदलता है। यह कई लक्ष्यों के बारे में स्थानिक-कालिक तर्क का उपयोग करता है। साथ ही, यह चौराहों पर संयुक्त धारणा के लिए टोपोलॉजी को ध्यान में रखता है।
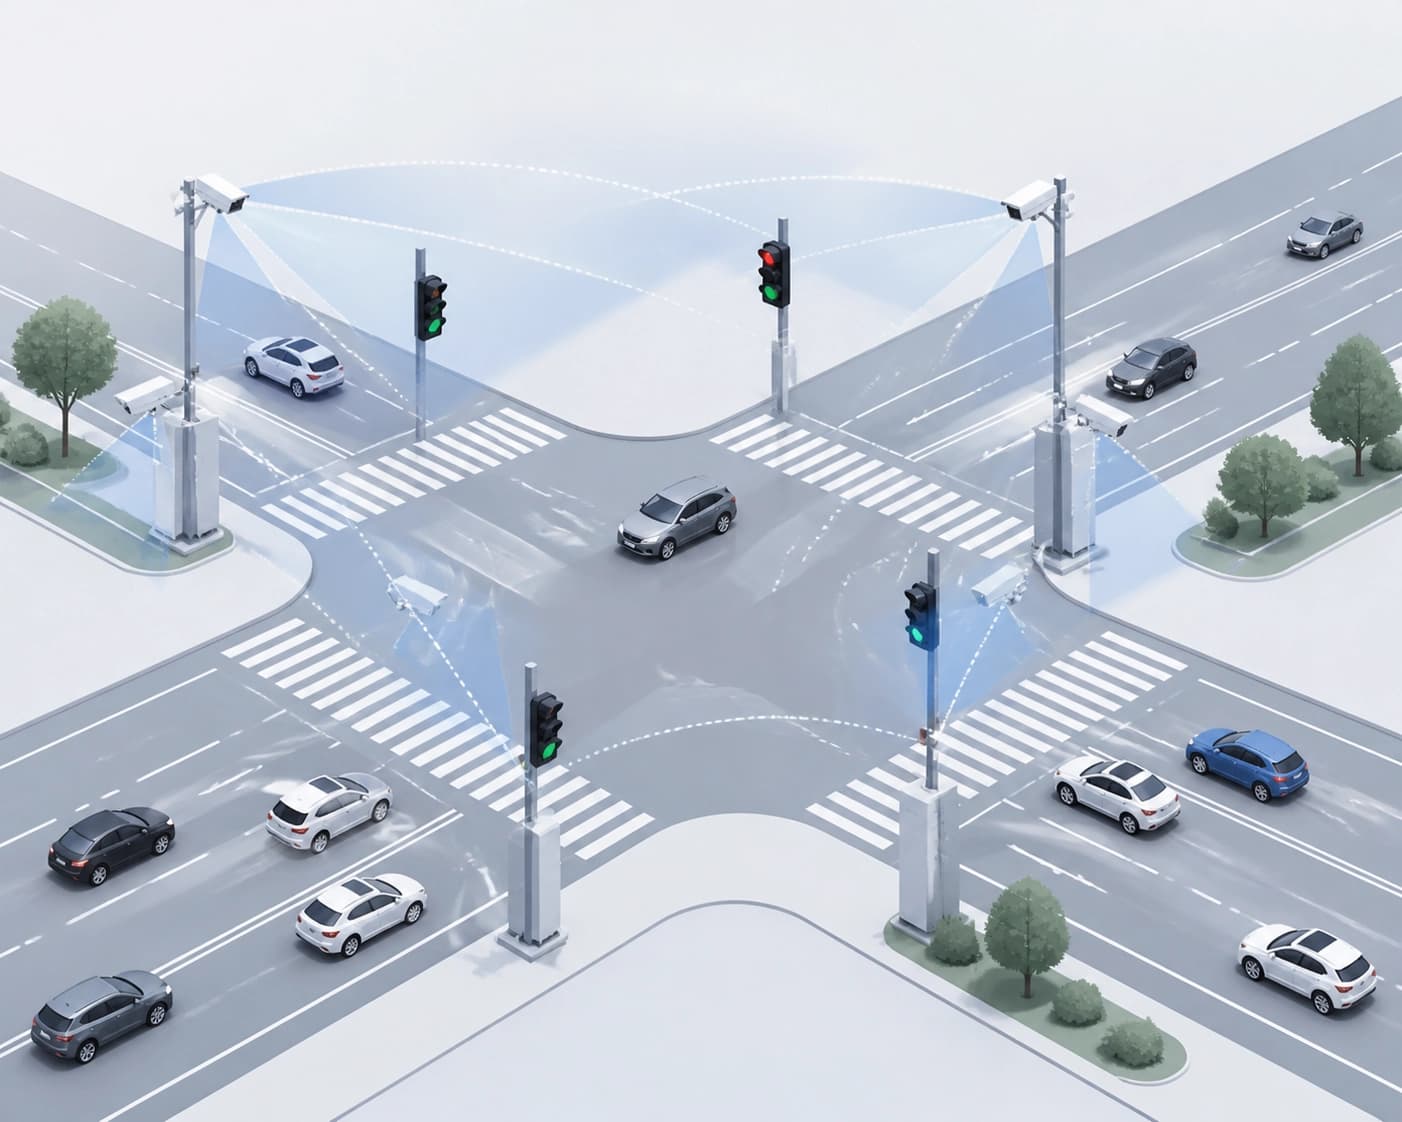
इस दृष्टिकोण की प्रमुख विशेषताएँ:
- एंड-टू-एंड अनुमान: दृश्य अवलोकन ट्रैफ़िक लाइट की क्रियाओं में बदलते हैं।
- बहु-दृश्य वीडियो: डेटा सड़क किनारे लगे कैमरों से आता है।
- स्थानिक-कालिक तर्क: मॉडल कई लक्ष्यों को ध्यान में रखता है।
- टोपोलॉजी को ध्यान में रखना: चौराहों पर संयुक्त धारणा।
चयन का मानदंड: VLA दृष्टिकोण एक ही मॉडल में धारणा और नियंत्रण को जोड़ता है। यह इसे उन प्रणालियों से अलग करता है जिनमें ये कार्य अलग-अलग होते हैं। वीडियो और क्रियाओं के बीच एंड-टू-एंड संबंध मुख्य मानदंड है।
VLALight को कैसे प्रशिक्षित किया जाता है: दो चरण
VLALight के प्रशिक्षण में दो-चरणीय रणनीति शामिल है। पहले supervised cold-start का उपयोग किया जाता है। इससे सड़क की स्थिति की दृश्य समझ और सिग्नल संबंधी निर्णय लेने की क्षमता विकसित होती है। फिर cooperative agentic reinforcement learning लागू किया जाता है।
दूसरा चरण स्थानीय नियंत्रण और समग्र परिवहन नेटवर्क की दक्षता का संयुक्त अनुकूलन करता है। पहला चरण दृश्य और सिग्नल की समझ के लिए है। दूसरा चरण स्थानीय नियंत्रण और नेटवर्क का अनुकूलन करता है।
| चरण | कार्य | किसका अनुकूलन करता है |
|---|---|---|
| Supervised cold-start | सड़क की स्थिति की दृश्य समझ और सिग्नल संबंधी निर्णय लेना | मॉडल के शुरुआती कौशल |
| Cooperative agentic reinforcement learning | संयुक्त अनुकूलन | स्थानीय नियंत्रण और नेटवर्क की दक्षता |
चयन का मानदंड: देखें कि क्या दृष्टिकोण में नेटवर्क-स्तर पर संयुक्त अनुकूलन है। नेटवर्क के संदर्भ के बिना स्थानीय निर्णयों का प्रभाव सीमित रहता है। दो चरणों की प्रक्रिया धारणा के प्रशिक्षण और परस्पर क्रिया को बेहतर बनाने को अलग करती है।
अनुकूली तर्क मोड और अनुमान की लागत
VLALight तेज़ और धीमे तर्क के अनुकूली मोड का उपयोग करता है। अधिक गहन तर्क का उपयोग केवल तभी किया जाता है जब उससे नियंत्रण को पर्याप्त लाभ मिलता हो। मॉडल संतुलित mode-aware rollouts और relative advantage optimization का उपयोग करता है। मॉडल निर्णयों की गुणवत्ता और अनुमान की लागत के बीच संतुलन बनाना सीखता है।
| मोड | सक्रिय होने की शर्त | प्रभाव |
|---|---|---|
| तेज़ | गहन तर्क से पर्याप्त लाभ नहीं मिलता | अनुमान की कम लागत |
| धीमा | गहन तर्क से पर्याप्त लाभ मिलता है | बेहतर गुणवत्ता वाले निर्णय |
चयन का मानदंड: निर्णयों की गुणवत्ता और अनुमान की लागत के बीच संतुलन। मोड नियंत्रण से मिलने वाले लाभ के आधार पर बदलने चाहिए। हर समय अधिकतम गहराई पर काम करने से लागत बढ़ती है।
प्रयोगों से क्या पता चला
प्रयोग वास्तविक ट्रैफ़िक प्रवाह के सात डेटासेट पर किए गए। इनमें तीन शहरी नेटवर्क शामिल हैं। VLALight ने आधारभूत विधियों से बेहतर प्रदर्शन किया। इन आधारभूत विधियों में परिवहन मॉडल, सुदृढीकरण अधिगम, LLM/VLM शामिल हैं।
| आधारभूत विधियों का वर्ग | तुलना में भूमिका |
|---|---|
| परिवहन मॉडल | आधाररेखा |
| सुदृढीकरण अधिगम | आधाररेखा |
| LLM/VLM | आधाररेखा |
एब्लेशन अध्ययन ने संयुक्त धारणा, नेटवर्क-स्तर के अनुकूलन और अनुकूली तर्क की प्रभावशीलता की पुष्टि की। लेखक वास्तविक भौतिक परिवहन प्रणालियों के नियंत्रण के लिए VLA मॉडलों की क्षमता पर ज़ोर देते हैं।
चयन का मानदंड: आधारभूत विधियों की संरचना और एब्लेशन की मौजूदगी जाँचें। प्रयोग वास्तविक ट्रैफ़िक प्रवाह और तीन शहरी नेटवर्क को कवर करते हैं। प्रत्येक घटक के योगदान की अलग से पुष्टि होनी चाहिए।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
हाइब्रिड इमेज एनोटेशन: ऑटोमेशन कंप्यूटर विज़न मॉडल्स के प्रशिक्षण को तेज़ करता है
यह लेख बताता है कि एल्गोरिदम द्वारा पूर्व-लेबलिंग मैन्युअल काम को कैसे कम करती है और प्रशिक्षण डेटासेट की गुणवत्ता कैसे बढ़ाती है, साथ ही यह भी कि इंसानों द्वारा नमूना-आधारित सत्यापन अब भी क्यों ज़रूरी है। इसमें कठिन शूटिंग परिस्थितियों और दुर्लभ प्रकार की वस्तुओं के मामले में इस विधि की सीमाओं पर चर्चा की गई है।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026