
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
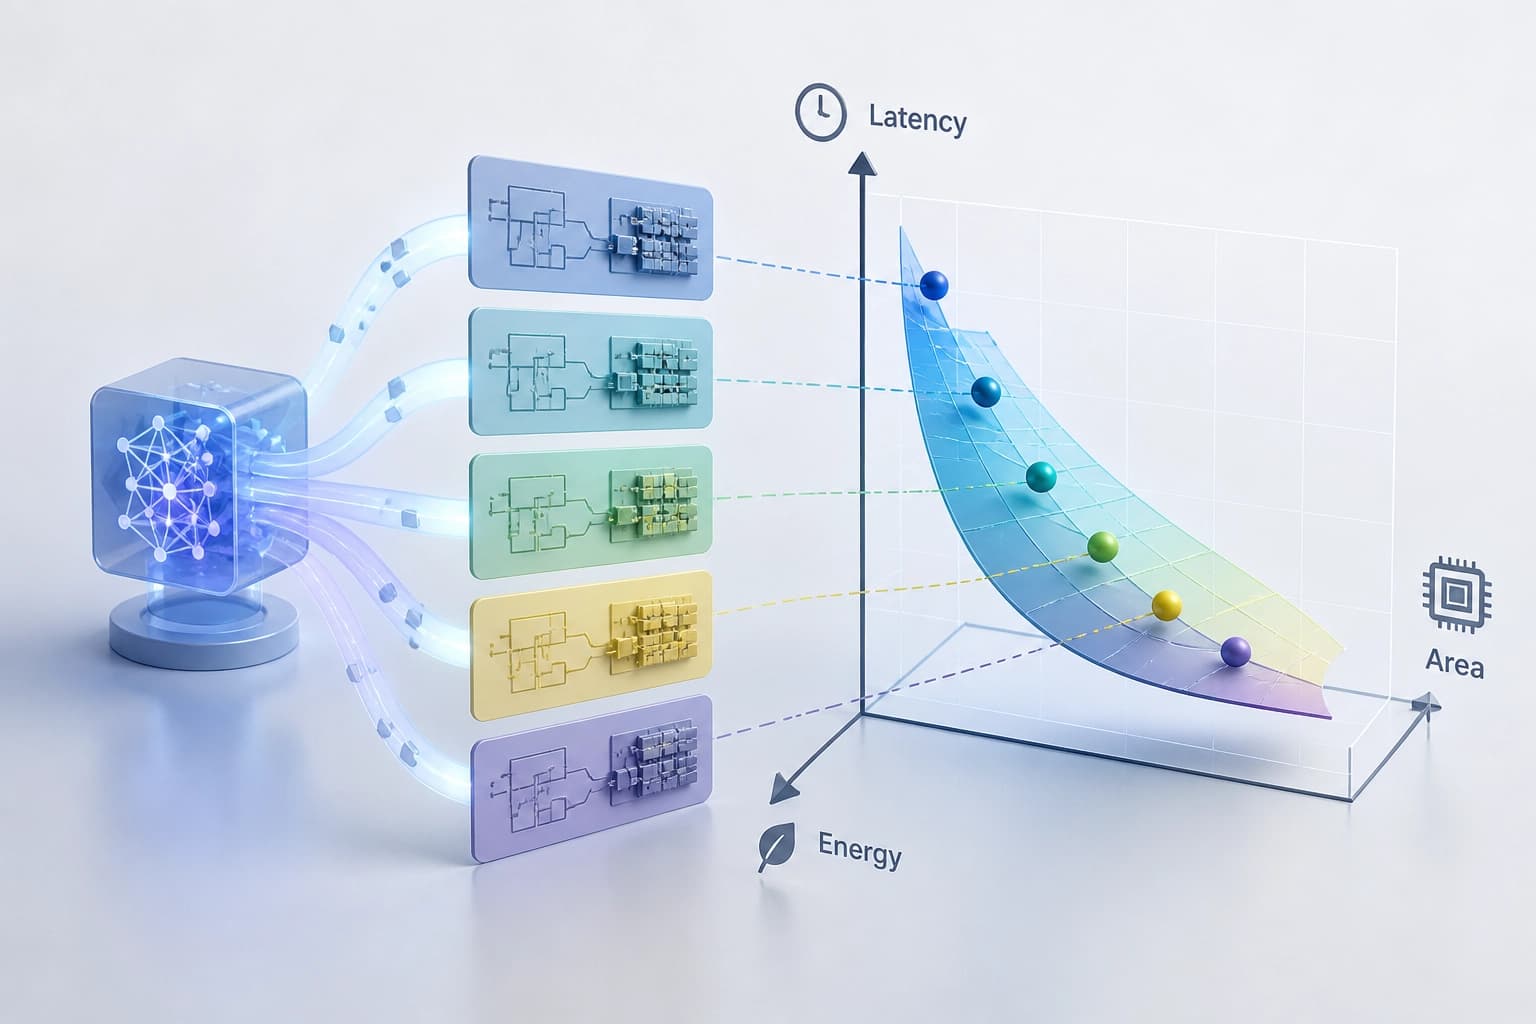
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
कार्य और स्थिति
- शीर्षक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग और बड़े भाषा मॉडल के माध्यम से परेटो-इष्टतम RTL कोड जनरेशन।
- लेखक: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa।
- जमा करने की तारीख: 16 अक्टूबर 2026।
- स्थिति: टिप्पणियों में कहा गया है कि शोधपत्र COLM 2026 में स्वीकार कर लिया गया है।
प्रीप्रिंट arXiv:2610.26904 के रूप में उपलब्ध है। यह शोध बड़े भाषा मॉडलों की मदद से RTL जनरेशन से संबंधित है। इस विधि में मॉडल को एक ही सर्किट के बजाय उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित किया जाता है। इस सेट का मूल्यांकन PPA स्पेस में किया जाता है।
निष्कर्ष: शोधपत्र COLM 2026 में स्वीकार किया गया है और LLM-आधारित RTL संश्लेषण के लिए बहु-उद्देश्यीय दृष्टिकोण प्रस्तुत करता है। दृष्टिकोण चुनने के लिए लक्ष्य में आया बदलाव अहम है—एक सर्किट से उम्मीदवारों के एक सेट तक।
स्केलर रिवॉर्ड की समस्या
मौजूदा दृष्टिकोण कई उद्देश्यों को मिलाकर एक स्केलर रिवॉर्ड बना देते हैं। इससे परेटो-इष्टतम समाधानों के विविध सेट प्राप्त करना मुश्किल हो जाता है। कम बिजली खपत, कम विलंबता और छोटा क्षेत्रफल के बीच अलग-अलग समझौते करना कठिन हो जाता है। स्केलर रिवॉर्ड जनरेशन से पहले ही उद्देश्यों का महत्व तय कर देता है।
उद्देश्यों का सापेक्ष महत्व उत्पाद की आवश्यकताओं और परियोजना की सीमाओं पर निर्भर करता है। पहले से तय किया गया रिवॉर्ड इन आवश्यकताओं के साथ नहीं बदलता। इसलिए अलग-अलग समझौतों वाले उम्मीदवारों का एक सेट आवश्यक है।
| दृष्टिकोण | यह किसे अनुकूलित करता है | समझौता कब चुना जाता है |
|---|---|---|
| स्केलर रिवॉर्ड | उद्देश्यों के योग के आधार पर एक सर्किट | जनरेशन से पहले |
| बहु-उद्देश्यीय दृष्टिकोण | परेटो फ्रंट पर सर्किटों का एक सेट | जनरेशन के बाद |
निष्कर्ष: स्केलर रिवॉर्ड समझौते को जनरेशन से पहले तय कर देता है। बहु-उद्देश्यीय निर्धारण विकल्प को जनरेशन के बाद के चरण तक टाल देता है।
विधि किसे अनुकूलित करती है
यह विधि सर्किटों के पूरे सेट की गुणवत्ता और विविधता को अनुकूलित करती है। यह सेट कई बार जनरेशन करने पर बनता है। मूल्यांकन PPA उद्देश्यों के स्पेस में किया जाता है: Power, Performance, Area। इस विधि का लक्ष्य किसी एक सर्किट की गुणवत्ता नहीं है।
PPA के उद्देश्यों के बीच समझौते होते हैं। अलग-अलग सर्किट कम बिजली खपत, कम विलंबता और छोटे क्षेत्रफल के अलग-अलग संयोजन देते हैं। इसलिए यह विधि मॉडल को परेटो फ्रंट के अलग-अलग बिंदुओं को समेटने के लिए प्रशिक्षित करती है। डिज़ाइनर को कई उम्मीदवार मिलते हैं।
निष्कर्ष: विधि का लक्ष्य फ्रंट को समेटना है, न कि एक सर्वश्रेष्ठ उत्तर देना।
विधि के दो घटक
जनरेशन-आधारित प्रशिक्षण पाइपलाइन
यह पाइपलाइन परेटो समाधानों के पूरे सेट के कवरेज में सुधार को सर्किट जनरेशन के क्रमिक कार्य में बदल देती है। प्रशिक्षण चरणों में होता है। जनरेशन कार्य को क्रमिक संरचना मिलती है।
Hypervolume Contribution पर आधारित रिवॉर्ड
HVC रिवॉर्ड फ़ंक्शन परेटो फ्रंट में जनरेट किए गए सर्किट के योगदान को मापता है। रिवॉर्ड किसी सर्किट की निरपेक्ष गुणवत्ता के बजाय कवरेज में हुई वृद्धि को दर्शाता है। HVC प्रशिक्षण को फ्रंट के कवरेज से जोड़ता है।
निष्कर्ष: पाइपलाइन क्रम निर्धारित करती है, जबकि HVC कवरेज में योगदान के लिए संकेत देता है।
RTLLM v2 पर परिणाम
RTLLM v2 बेंचमार्क पर मूल्यांकन में सापेक्ष Hypervolume में वृद्धि देखी गई। PPA अनुकूलन के बिना आधारभूत संस्करण की तुलना में वृद्धि +13,3 प्रतिशत अंक थी। एकल-उद्देश्यीय RL विधि की तुलना में वृद्धि +14,4 प्रतिशत अंक थी। लेखक सर्किटों की विविधता में बेहतर प्रदर्शन की भी रिपोर्ट करते हैं।
| तुलना | सापेक्ष Hypervolume में वृद्धि |
|---|---|
| PPA अनुकूलन के बिना आधारभूत संस्करण | +13,3 प्रतिशत अंक |
| एकल-उद्देश्यीय RL विधि | +14,4 प्रतिशत अंक |
निष्कर्ष: RTLLM v2 पर यह विधि फ्रंट के कवरेज और विविधता में सुधार करती है। ये आंकड़े सापेक्ष Hypervolume से संबंधित हैं, हर सर्किट की निरपेक्ष गुणवत्ता से नहीं।
व्यावहारिक चयन मानदंड
दृष्टिकोण का चयन इस आधार पर किया जाता है कि समझौता कब तय किया जाए। स्केलर रिवॉर्ड में जनरेशन से पहले PPA का महत्व निर्धारित करना पड़ता है। बहु-उद्देश्यीय दृष्टिकोण इस चयन को जनरेशन के बाद के चरण तक टाल देता है। इससे अलग-अलग समझौतों वाले उम्मीदवारों का एक सेट मिलता है।
इस विधि का मूल्यांकन RTLLM v2 बेंचमार्क तक सीमित है। किसी अन्य डिज़ाइन फ़्लो के लिए अलग से सत्यापन आवश्यक है। बिना जाँच के वृद्धि के आंकड़ों को दूसरी परिस्थितियों पर लागू नहीं किया जा सकता।
निष्कर्ष: यदि PPA की आवश्यकताएँ उत्पाद और परियोजना के अनुसार बदलती हैं, तो बहु-उद्देश्यीय दृष्टिकोण जनरेशन के बाद चयन करने की आवश्यकता के अनुरूप है। यदि उद्देश्यों का महत्व ज्ञात और तय है, तो स्केलर रिवॉर्ड पहले से निर्धारित समझौते वाले मामले के अनुरूप है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026
बंद-स्रोत LLMs पर एजेंटों के लिए विश्व मॉडल: जोखिम-बिंदुओं पर सुधार
PAWM प्रस्तावित किया गया है—एक बाहरी प्रेडिक्टर, जो चरण-दर-चरण अवलोकन को दोहराता नहीं, बल्कि संभावित विफलता के समय सक्रिय होकर एजेंट को गलत कार्रवाई से दूर ले जाता है। सिंथेटिक परिदृश्यों पर SFT और GRPO के साथ सह-प्रशिक्षण के बाद, इस विधि ने Claude Sonnet 4.5 के लिए ScienceWorld में 24,3% और WebArena-Lite में 7,7% का सुधार दिया।
4 नवम्बर 2026