Пथ क्यों एक खराब माप इकाई है
इन्फरेंस के दौरान तर्क करने के आधुनिक तरीके एक ही योजना पर काम करते हैं: मॉडल एक जवाब नहीं, बल्कि उम्मीदवार श्रृंखलाओं का पूरा पूल बनाता है, जिसके बाद एक बाहरी reward-मॉडल सबसे अच्छा चुनता है। तर्क सरल है — जितने अधिक विकल्प, उतनी अधिक संभावना कि उनमें कोई सफल निकलेगा।
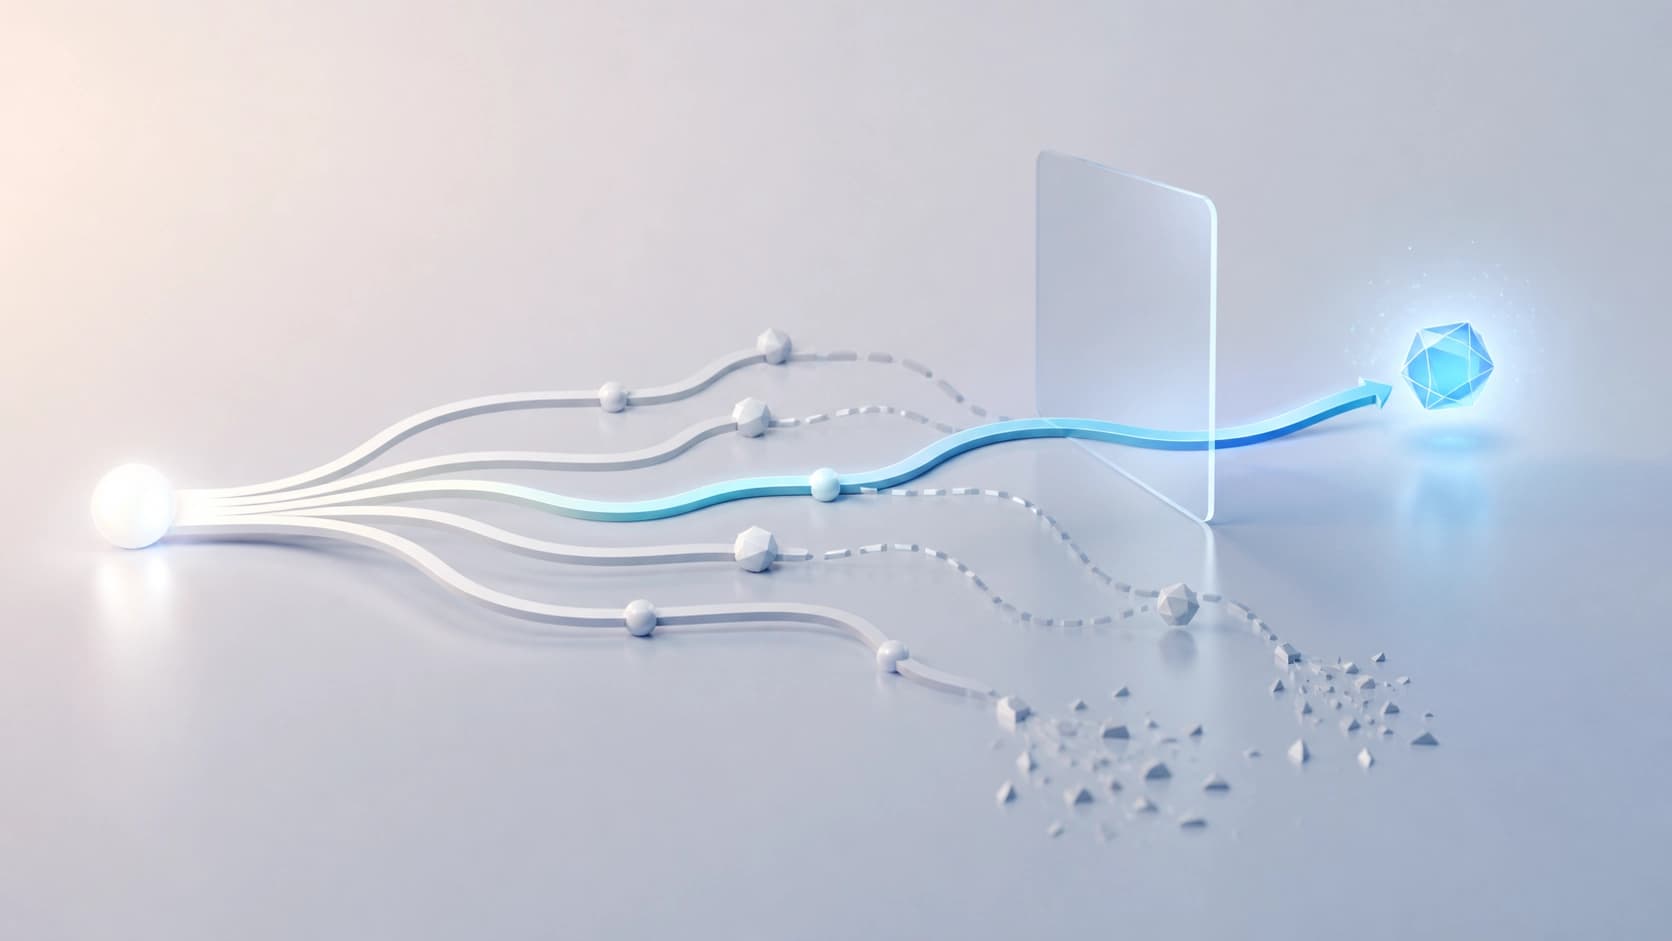
कमजोर बिंदु यहाँ कहीं और है। हर उम्मीदवार को एक अविभाज्य इकाई माना जाता है: या तो उसे पूरी तरह स्वीकार किया जाता है, या पूरी तरह कचरे में फेंक दिया जाता है। लेकिन लंबा तर्क शायद ही कभी एकरूप होता है। आम तस्वीर — आत्मविश्वास से भरी, सही शुरुआत, समस्या का सावधानीपूर्वक निरूपण, सही ढंग से चुना गया तरीका, और फिर चूक: अंकगणितीय गलती, लूप में फँसना, शर्त का बदल जाना। औपचारिक रूप से पूरी श्रृंखला को असफल के रूप में चिह्नित किया जाता है, हालाँकि उसका पहला आधा हिस्सा बिल्कुल काम का था।
नतीजा — बर्बाद हुई गणनाएँ। हम उन टोकनों के जनरेशन का भुगतान करते हैं जो सही थे, और फिर उन्हें खराब हुए पूँछ के साथ फेंक देते हैं। यही अक्षमता Selective Regenerative Decoding नामक शोध का विषय है, जो arXiv:2608.24338 (cs.AI) के रूप में 25 अगस्त 2026 को प्रकाशित हुआ।
SRD: दो के बजाय तीन शाखाएँ
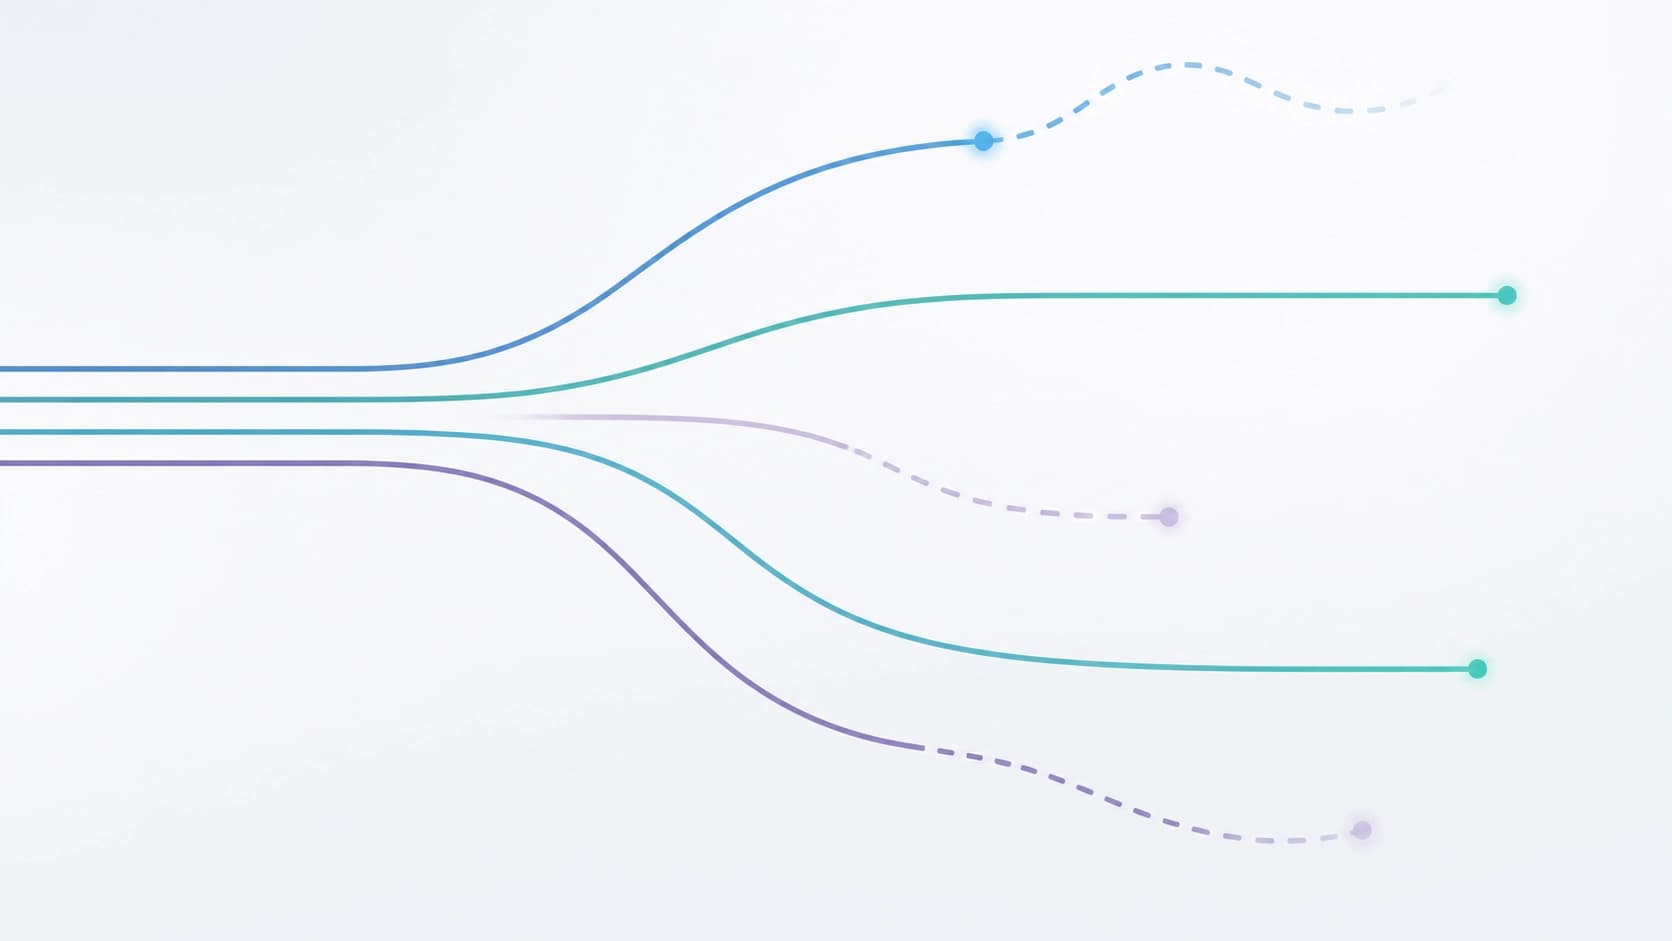
Selective Regenerative Decoding (SRD) द्विआधारी चुनाव को छोड़ने का प्रस्ताव करता है। "स्वीकार करें या अस्वीकार करें" के बजाय हर उम्मीदवार को तीन शाखाओं में से एक में भेजा जाता है:
- अस्वीकार करें — यदि श्रृंखला शुरू से अंत तक बेकार है;
- सुरक्षित रखें — यदि वह पूरी तरह जाँच में खरी उतरती है;
- सुधारें — यदि उपयोगी हिस्सा मौजूद है, लेकिन सफ़िक्स स्पष्ट रूप से खराब हो गया है।
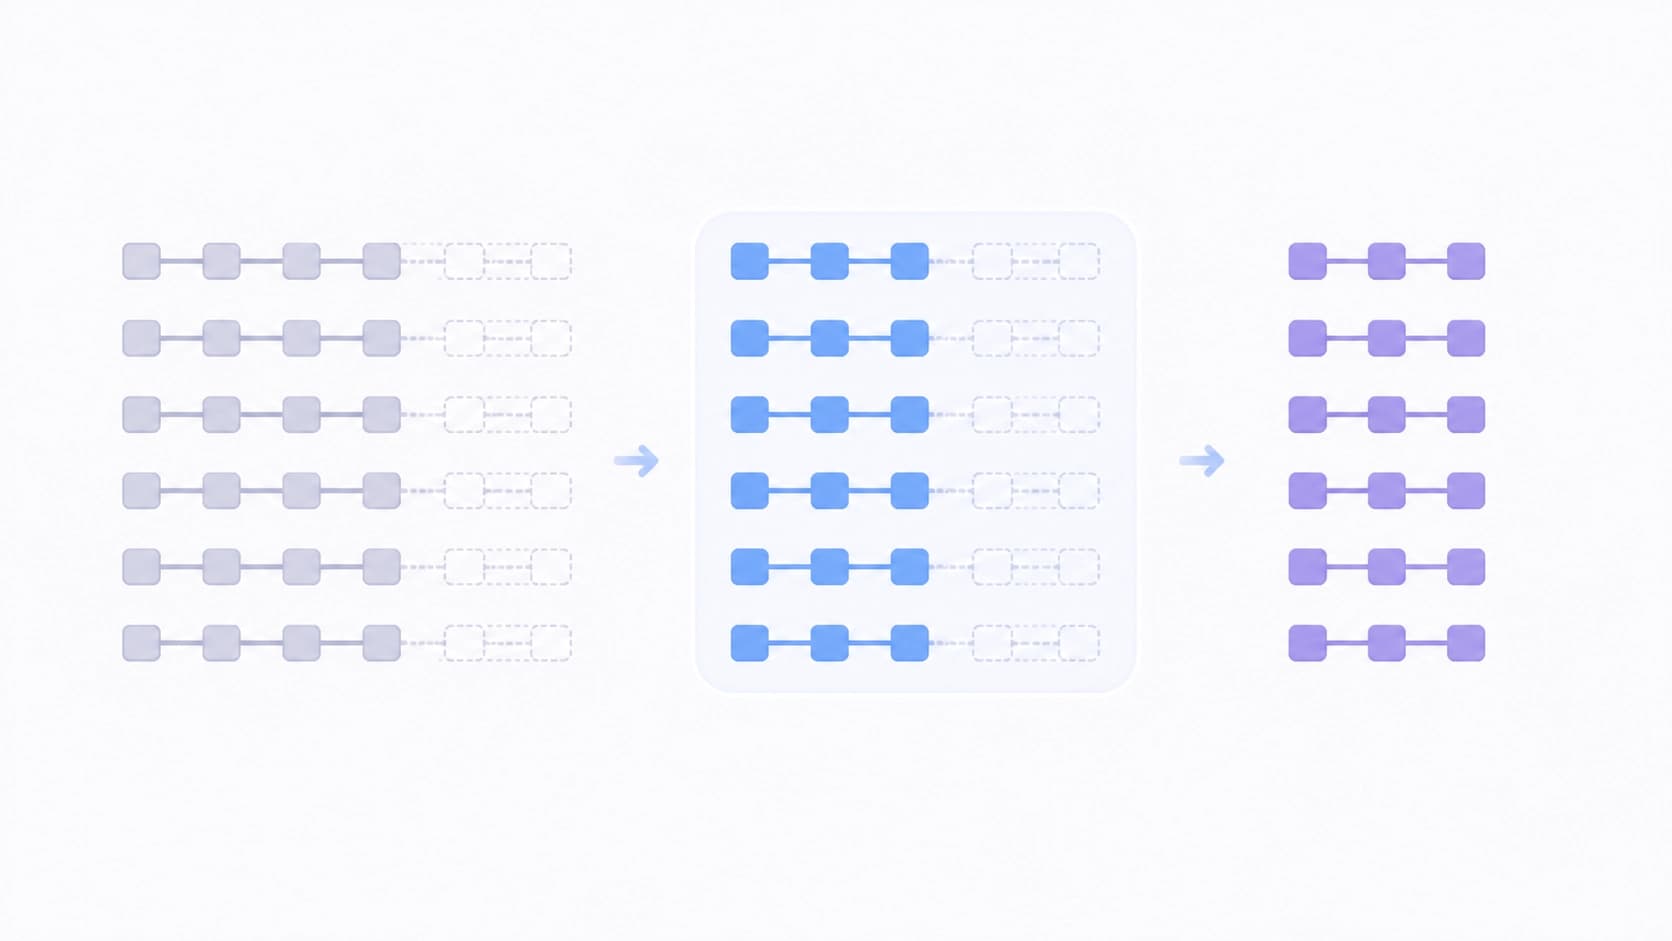
तीसरे मामले में सिस्टम तर्क को शून्य से दोबारा नहीं लिखता, बल्कि गुणवत्तापूर्ण प्रीफ़िक्स को सुरक्षित रखता है और केवल खराब हुए हिस्से को फिर से जनरेट करता है। यह नया पाठ लिखने से ज़्यादा ड्राफ़्ट को संपादित करने जैसा है: आप विफल अंत की वजह से अच्छी शुरुआत को नहीं फेंकते, बल्कि जो टूट गया है उसे ठीक करते हैं।
लेखक अलग से इस बात पर ज़ोर देते हैं कि इस तरह के हस्तक्षेप के लिए किसी बड़े दान मॉडल की आवश्यकता नहीं है। कोई "स्मार्ट शिक्षक" नहीं, जो कमजोर छात्र को ऊपर खींच ले — सारा काम पहले से उपलब्ध गणनात्मक संसाधनों के दायरे में ही होता है। यही इस विधि को व्यावहारिक बनाता है, न कि सैद्धांतिक अभ्यास।
लाभ कहाँ से आता है
शोध में सबसे दिलचस्प बात ह्यूरिस्टिक नहीं, बल्कि उसका औचित्य है। हल्की मान्यताओं के तहत SRD क्लासिकल rejection sampling की तुलना में नमूनाकरण दक्षता में 1.28–1.36 गुना का प्रमाणित वृद्धि देता है, और अंतिम पथ की अपेक्षित गुणवत्ता सख्त रूप से अधिक होती है, न कि केवल "कम नहीं"।
यहाँ अंतर्ज्ञान सूत्रों के बिना भी स्पष्ट है। सफ़िक्स के पुनर्जनन से गुज़रा उम्मीदवार अपने भीतर पहले से भुगतान की गई गणनाएँ समेटे होता है — प्रीफ़िक्स के वे टोकन, जिन्हें दोबारा जनरेट करने की आवश्यकता नहीं है। ऐसे सीमावर्ती उम्मीदवारों को जितना अधिक बचाया जा सके, जनरेट किए गए पाठ का उतना ही कम हिस्सा टोकरी में जाता है। और चूँकि उम्मीदवार पूल बढ़ने के साथ "लगभग सफल" श्रृंखलाओं की संख्या भी बढ़ती है, लाभ स्थिर नहीं रहता — यह जनरेशन बजट के साथ मापन करता है।
इसका परीक्षण कहाँ किया गया
प्रायोगिक भाग चार अलग-अलग प्रकार के भार को कवर करता है: MATH500 (गणितीय समस्याएँ), GPQA Diamond (वैज्ञानिक स्तर के प्रश्न), HotpotQA (दस्तावेज़ों पर आधारित बहु-चरणीय प्रश्न) और AlpacaEval (निर्देशों का पालन और प्राथमिकता मूल्यांकन)। परीक्षण "जनरेटर + reward-मॉडल" के कई संयोजनों पर किया गया, ताकि परिणाम किसी एक सफल जोड़ी पर निर्भर न रहे।
घोषित नतीजे: SRD उस सटीकता तक पहुँचता है जो आमतौर पर Best-of-N मोड से प्राप्त होती है, लेकिन काफी कम जनरेट किए गए टोकन खर्च करता है। और सीमित गणनाओं वाले परिदृश्यों में यह विधि speculative rejection को पीछे छोड़ देती है — यानी वहीं जीतती है जहाँ हर अतिरिक्त टोकन महँगा पड़ता है।
यह मूल रूप से क्या बदलता है
लेखक जो मुख्य बदलाव दर्ज करते हैं, वह पद्धतिगत है। पहले चुनाव पूरे पथ के स्तर पर होता था: reward-मॉडल मूल्यांकन देता था और पूरे तर्क का भाग्य तय करता था। SRD हस्तक्षेप को पथ के भीतर, खंडों के स्तर पर ले जाता है, और इसी कारण सटीकता और गणनाओं के बीच उस समझौते का क्षेत्र खोलता है, जिसका अब तक लगभग अध्ययन ही नहीं हुआ था।
इन्फरेंस-पाइपलाइन बनाने वालों के लिए व्यावहारिक निष्कर्ष: तर्क की गुणवत्ता और उसे प्राप्त करने की लागत ज़रूरी नहीं कि कठोर रूप से जुड़ी मात्राएँ हों। "अतिरिक्त" गणनाओं का एक हिस्सा वापस पाया जा सकता है, यदि मॉडल के ड्राफ़्ट को एक अखंड इकाई मानना बंद कर दिया जाए।
पर्दे के पीछे क्या रह जाता है
खुले प्रश्न काफी हैं। मुख्य — स्वस्थ प्रीफ़िक्स और खराब हुए सफ़िक्स के बीच की सीमा वास्तव में कैसे निर्धारित होती है: इस मानदंड पर निर्भर करता है कि कितने उम्मीदवार तीसरी शाखा में पहुँचेंगे। इसके बाद — पुनर्जनन की कीमत (यह मुफ़्त नहीं है), reward-मॉडल के चुनाव के प्रति संवेदनशीलता, और चार प्रयुक्त बेंचमार्कों के बाहर निष्कर्षों की स्थानांतरणीयता।
शोध 20 पृष्ठों का है और ARR में प्रस्तुत किया गया है, यानी यह अभी पहले संस्करण का प्रीप्रिंट है, समीक्षित परिणाम नहीं। लेकिन दिशा आशाजनक लगती है: अधिक जनरेट करके और सख्ती से छाँटने के बजाय, मॉडल जो पहले ही सोच चुका है उसका अधिक सावधानी से उपयोग किया जा सकता है।