
पाइपलाइन की त्रुटियों को अलग-अलग परतों में बाँटना क्यों ज़रूरी है
RAG सिस्टम को एक ही आँकड़े से आँकना सुविधाजनक तो है, पर लगभग बेकार है। एंड-टू-एंड मेट्रिक इस सवाल का जवाब देती है कि "जवाब अपेक्षा पर खरा उतरा या नहीं", न कि इस सवाल का कि "वह वहाँ पहुँचा क्यों या क्यों नहीं"। जबकि RAG कोई एक अखंड इकाई नहीं, बल्कि एक शृंखला है: पहले बेस में कुछ ढूँढा जाता है, फिर सिस्टम तय करता है कि मिला हुआ काफ़ी है या नहीं, और उसके बाद ही जनरेटर टेक्स्ट लिखता है। किसी भी कड़ी में गड़बड़ी आउटपुट पर एक जैसा "गलत" जवाब देती है, हालाँकि दो ऐसी विफलताओं के कारण बिल्कुल उलटे भी हो सकते हैं।
यही समस्या The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, cs.CL श्रेणी, 25 अगस्त 2026 को प्रस्तुत) अपने ज़िम्मे लेती है। लेखक — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak और Jan Deriu — सुझाव देते हैं कि पूरे कन्वेयर को एक साथ नापने के बजाय उसे एक प्रायिकता-आधारित मॉडल के रूप में वर्णित किया जाए, जहाँ हर चरण अपने संबंधों के साथ एक अलग यादृच्छिक चर है। इसके बाद सिस्टम का मूल्यांकन एक अनुमान समस्या बन जाता है: छिपे हुए चरों के कौन-से मान observed जवाबों और एनोटेशन को सबसे अधिक विश्वसनीय ढंग से समझाते हैं।
बायेसियन फ़्रेमवर्क असल में क्या मॉडल करता है
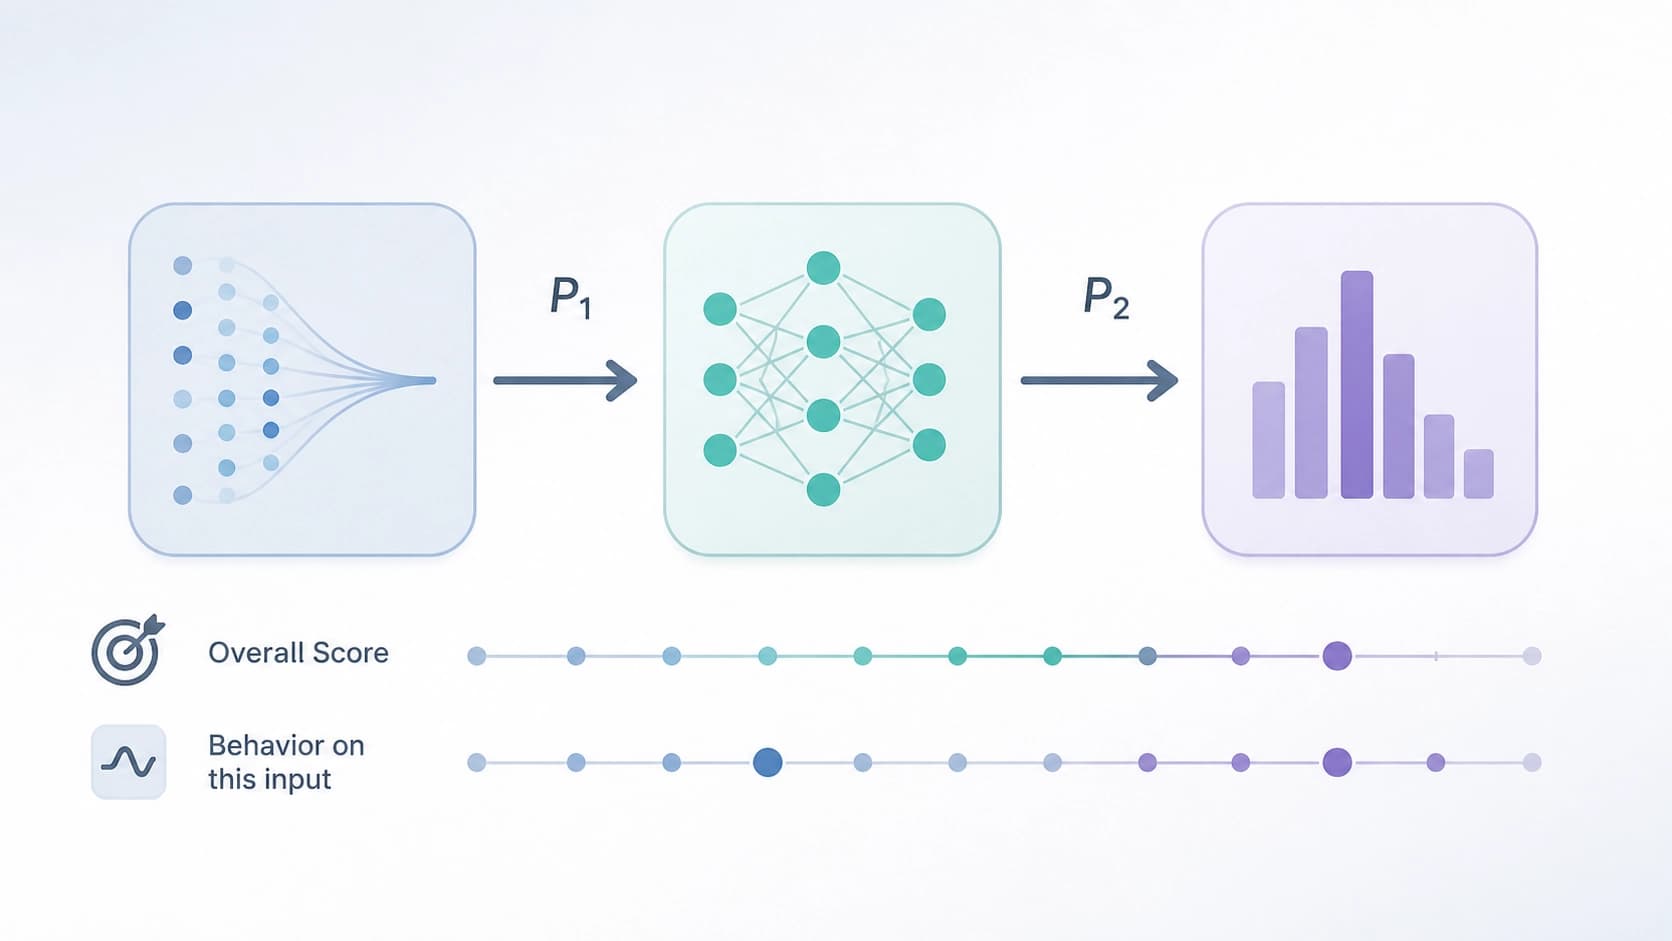
मुख्य विचार — सूचना-प्रवाह के आधार पर गुणनखंडन। चर "पाइपलाइन के घटकों" के अनुसार यांत्रिक रूप से नहीं, बल्कि उसी क्रम में पेश किए जाते हैं जिस क्रम में सूचना वास्तव में सिस्टम से गुज़रती है: खोज की सफलता इस बात को प्रभावित करती है कि जनरेटर को कैसा व्यवहार करना चाहिए, और जनरेटर का व्यवहार खोज के परिणाम के साथ मिलकर जवाब की अंतिम शुद्धता तय करता है। ऐसी संरचना निर्भरताओं को स्पष्ट बनाती है, न कि समग्र मेट्रिक के भीतर छिपी हुई।
इस तरह The RAT मॉडल को तीन सार्थक परतें मिलती हैं, जो आमतौर पर एक ही आँकड़े में विलीन हो जाती हैं।
Task success और generator success — ये अलग-अलग सवाल हैं
पहली परत — task success: उपयोगकर्ता को अंततः सही जवाब मिला या नहीं। दूसरी — generator success: जो इनपुट जनरेटर को मिला, उसके अनुरूप उसने उचित व्यवहार किया या नहीं। औपचारिक रूप से दूसरा सशर्त गुणवत्ता है: मॉडल का व्यवहार दिए गए खोज-परिणाम के अनुरूप कितना उपयुक्त है, न कि सामान्य रूप से।
अंतर मूलभूत है। सिस्टम खराब खोज के बावजूद सही जवाब दे सकता है — जनरेटर ने पैरामीट्रिक मेमोरी से अनुमान लगा लिया। औपचारिक रूप से यह कार्य की सफलता है, पर व्यवहार अनुचित था: सिस्टम ने स्रोतों पर आधारित हुए बिना जवाब दिया, और किसी दूसरे प्रश्न पर यही आदत भ्रम (hallucination) बन जाएगी। और इसके विपरीत: खोज ने सब ज़रूरी ढूँढ लिया, जनरेटर ने सावधानी से जवाब दिया — फिर भी नतीजा गलत, क्योंकि प्रश्न ही गलत समझा गया। एंड-टू-एंड मेट्रिक इन दो स्थितियों में फ़र्क़ नहीं करती, सशर्त मेट्रिक करती है।
संयम — विफलता नहीं, एक निर्णय
मॉडल का तीसरा तत्व — abstention behavior, यानी संयम का व्यवहार। RAG संदर्भ में जवाब देने से इनकार कभी-कभी एकमात्र सही प्रतिक्रिया होती है: अगर बेस में कुछ भी प्रासंगिक नहीं है, तो ईमानदार "मुझे नहीं पता" आत्मविश्वास से भरी मनगढ़ंत से बेहतर है। पर वही इनकार तब गलती बन जाता है जब ज़रूरी दस्तावेज़ मिल गया था और सिस्टम ने उसका उपयोग नहीं किया।
इसलिए संयम को खोज-परिणाम से अलग, केवल सशर्त रूप से आँका जा सकता है। The RAT मॉडल इसे सीधे ध्यान में रखता है: वह देखता है कि इनकार या जवाब का तथ्य उस बात से मेल खाता है या नहीं जो वास्तव में संदर्भ में थी। यह दृष्टिकोण उत्पाद-निर्णयों के लिए भी उपयोगी है: अगर सिस्टम सफल खोज के बावजूद बड़े पैमाने पर संयम बरत रहा है, तो समस्या जनरेटर में नहीं, बल्कि इस बात में है कि उस तक संदर्भ कैसे पहुँचाया जाता है।
सीमांत (marginal) मेट्रिक्स धोखा क्यों देती हैं
लेखकों ने इस फ़्रेमवर्क को 27 कॉन्फ़िगरेशनों पर लागू किया — तीन डेटासेट, तीन रिट्रीवर और तीन जनरेटर, सभी संयोजनों में। यहाँ पूरा संयोजन अपने आप में लक्ष्य नहीं है: यह दिखाता है कि जब ठीक एक कड़ी बदलती है और बाकी जगह पर रहती हैं, तो विघटन कैसे व्यवहार करता है।
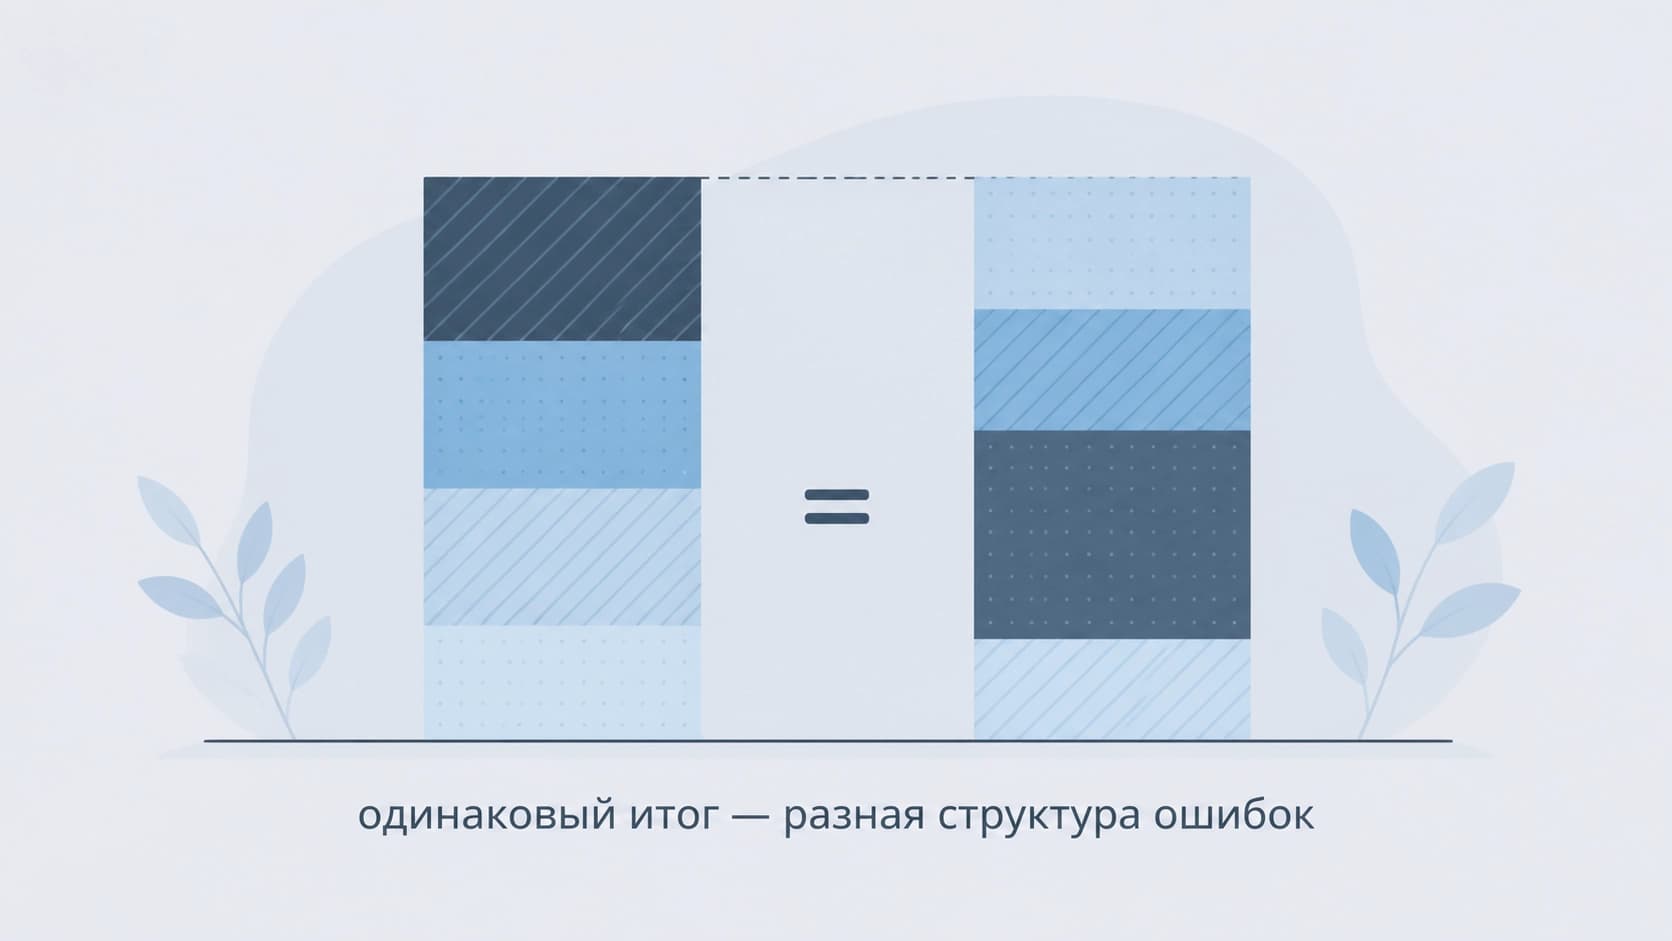
वह नतीजा जिसके लिए यह सब किया गया: सशर्त विघटन उन सिस्टमों के बीच स्पष्ट व्यवहारिक अंतर उजागर करता है जो सीमांत मेट्रिक्स पर समतुल्य दिखते हैं। दो पाइपलाइनें सही जवाबों का एक जैसा अनुपात दिखा सकती हैं और फिर भी इस बात में दसियों प्रतिशत तक भिन्न हो सकती हैं कि वे वास्तव में कहाँ गलती कर रही हैं — खोज में, इनकार की नीति में, या जनरेशन में। जो उत्पाद के लिए कॉन्फ़िगरेशन चुन रहा है, उसके लिए ये अलग-अलग सिस्टम हैं; जो तालिका में एक ही आँकड़ा देख रहा है, उसके लिए एक जैसे।
एनोटेशन का बजट कहाँ लगाएँ
लेख का एक अलग हिस्सा एनोटेशन के वितरण को समर्पित है। एनोटेशन महँगा है, और यह पूछना तर्कसंगत है: अगर लोगों से हर उदाहरण पर केवल एक सवाल पूछा जा सके, तो कौन-सा सवाल चुनें?
लेखकों का जवाब: खोज की सफलता पर एनोटेशन, कार्य की सफलता पर एनोटेशन से अधिक सूचनापूर्ण हैं, अगर लक्ष्य सिस्टम के नीति-पालन (policy adherence) का आकलन करना हो। कारण सुविधा नहीं, बल्कि मॉडल की संरचना है: खोज का एनोटेशन कारण-शृंखला के आरंभ में स्थित चर पर पड़ता है, इसलिए उससे नीचे की परतें भी "प्रकाशित" होती हैं। अंतिम सफलता का एनोटेशन आउटपुट वाले चर के बारे में है, और यह इस बारे में बहुत कम बताता है कि भीतर क्या हो रहा था। लेखक इस असममित प्रभाव की सूचना-सैद्धांतिक व्याख्या देते हैं।
व्यावहारिक निष्कर्ष सरल है: अगर बजट सीमित है, तो एनोटेटरों से "क्या जवाब सही है" नहीं, बल्कि "क्या ज़रूरी चीज़ मिली" पूछना चाहिए। पहला रिपोर्ट में बेहतर लगता है, दूसरा निदान के लिए अधिक उपयोगी है।
LLM-जज एक शोरयुक्त प्रेक्षण के रूप में
तीसरा हिस्सा — स्वचालित मूल्यांकनों तक मॉडल का विस्तार। The RAT की योजना LLM-as-a-judge के निर्णयों को मानव के विकल्प के रूप में नहीं, बल्कि कैलिब्रेटेड शोरयुक्त प्रेक्षणों के रूप में जोड़ने की अनुमति देती है: जज के गलत होने की अपनी प्रायिकता होती है, और वह उसी प्रायिकता-आधारित मॉडल के ढाँचे में आँकी जाती है।
यह "महँगे मानवीय एनोटेशन बनाम सस्ते स्वचालित" के कृत्रिम विरोध को हटा देता है। एक ही मॉडल में विशेषज्ञ निर्णयों का छोटा संग्रह रखा जा सकता है, जो पैमाना और कैलिब्रेशन तय करता है, और स्वचालित मूल्यांकनों की बड़ी धारा, जो पैरामीटरों को परिष्कृत करती है। जज एक ऑरेकल होना बंद कर देता है और एक और संकेत-स्रोत बन जाता है — ज्ञात और, जो महत्वपूर्ण है, मापनीय त्रुटि के साथ।
अपनी प्रैक्टिस में क्या अपनाएँ
- कन्वेयर को एक इकाई मत गिनिए। जैसे ही रिपोर्ट में खोज के लिए अलग मेट्रिक, जनरेटर के व्यवहार के लिए अलग और इनकार के लिए अलग मेट्रिक आ जाती है, "क्या टूटा" की बहस परिकल्पनाओं की छँटाई के बजाय निदान बन जाती है।
- व्यवहार का मूल्यांकन सशर्त रूप से करें। जवाब की शुद्धता और दिए गए संदर्भ में व्यवहार की उपयुक्तता अलग-अलग सवाल हैं, और अच्छा नतीजा खराब प्रक्रिया को सही नहीं ठहराता।
- रिपोर्ट औसत के बजाय स्लाइसों पर बनाएँ। समान एंड-टू-एंड गुणवत्ता वाले दो सिस्टमों को बिल्कुल अलग सुधारों की ज़रूरत हो सकती है।
- तय करें कि क्या एनोटेट करना है। अगर मानव संसाधन सीमित है, तो शुरुआती चरणों का एनोटेशन सिस्टम के बारे में समग्र रूप से अधिक जानकारी देता है।
- स्वचालित मूल्यांकनों को लगाम में रखें। LLM-जज एक त्रुटि-मॉडल वाले प्रेक्षण के रूप में उपयोगी है, अंतिम सत्य के रूप में नहीं।
यहाँ बायेसियन दृष्टिकोण मूल्यवान गणित के रूप में नहीं, बल्कि सोच के अनुशासन के रूप में है: यह पहले से बताने पर मजबूर करता है कि कौन-सी राशियाँ छिपी हैं, कौन-सी प्रेक्षणीय हैं, और एक दूसरे से कैसे जुड़ी हैं। इसके बाद नतीजों की कोई भी तालिका आँकड़ों का समूह होना बंद कर देती है और इस बात का वर्णन बन जाती है कि सिस्टम निर्णय कैसे लेता है।


