
संक्षेप में: क्या जारी किया गया
अगस्त 2026 के अंत में LAION टीम ने LAION-BVD जारी किया — एक खुला वीडियो कॉर्पस, जिसे प्रीप्रिंट में मल्टीमॉडल प्रशिक्षण के लिए अभूतपूर्व पैमाने का डेटासेट बताया गया है। यह काम 25 अगस्त 2026 को arXiv पर आया, श्रेणियाँ — कंप्यूटर विज़न, आर्टिफिशियल इंटेलिजेंस और मशीन लर्निंग।
सूखे आँकड़े इस तरह दिखते हैं:
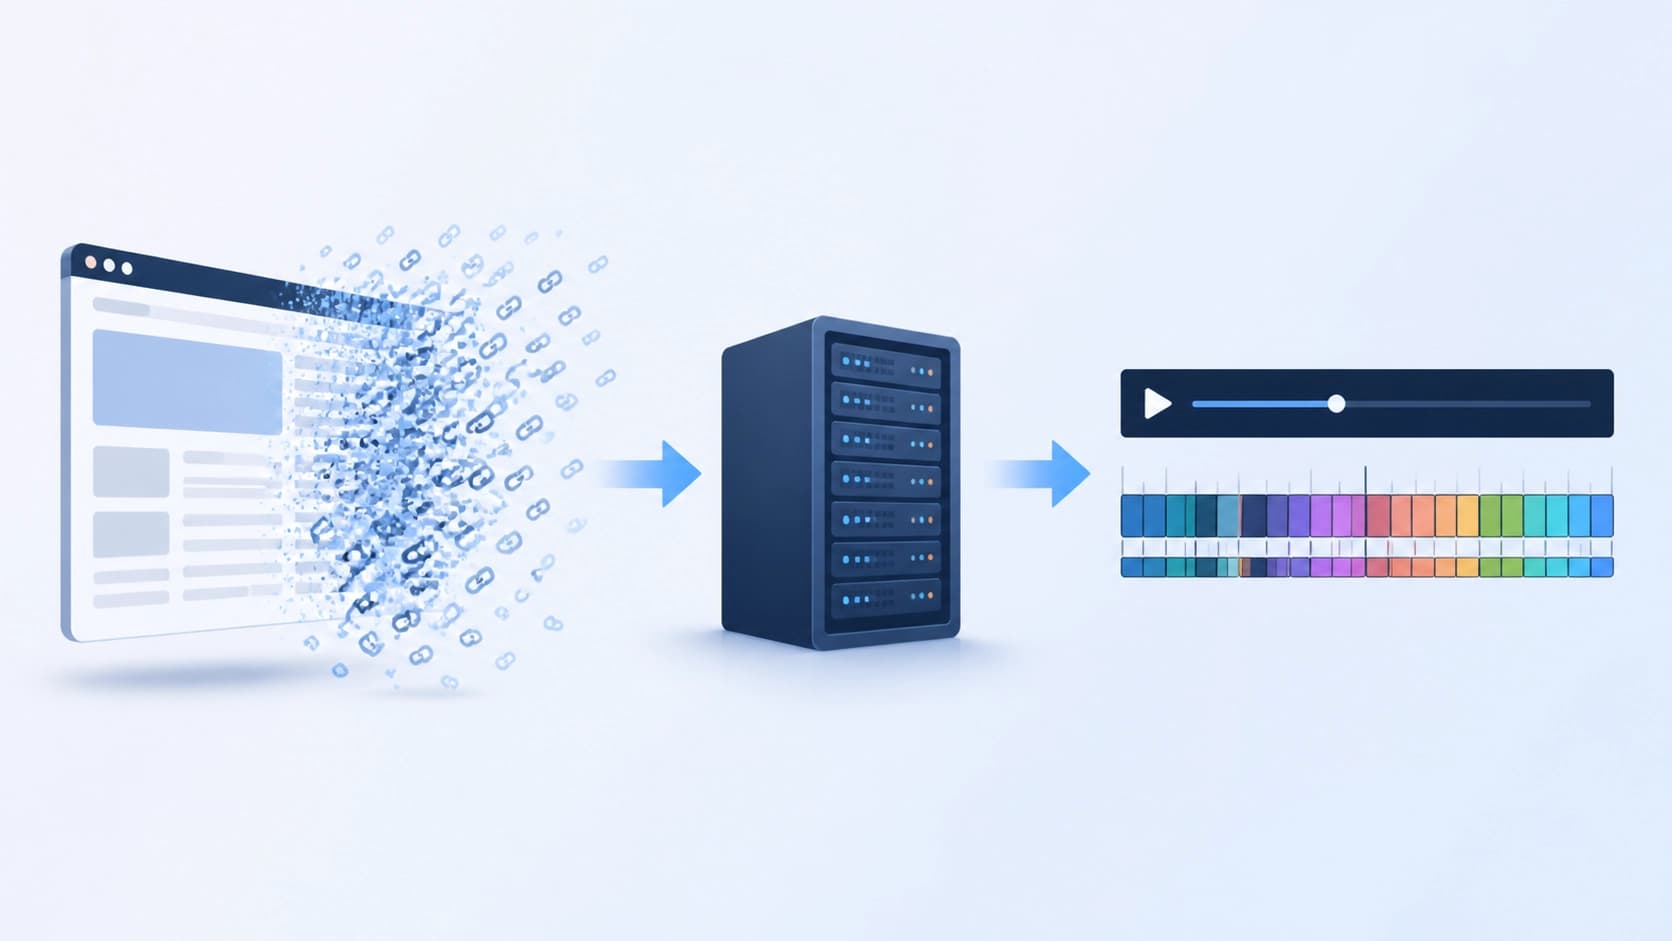
- 1.3 अरब वीडियो लिंक — संग्रह का प्रारंभिक बिंदु, लिंक CommonCrawl के वेब-क्रॉल से निकाले गए और विशिष्ट प्लेटफ़ॉर्म से जोड़े गए;
- 8 करोड़ क्लिप इन लिंक के ज़रिए वास्तव में डाउनलोड हुए — इंडेक्स में जो मिला, वह सब डाउनलोड तक नहीं पहुँचा;
- 1 करोड़ घंटे की कुल अवधि।
आखिरी आँकड़ा दिमाग में ठीक से बैठता नहीं: यह हज़ार साल से ज़्यादा की निरंतर देखने की अवधि है। इसीलिए इस रिलीज़ को इस बात में बदलाव कहा जा रहा है कि कॉर्पोरेट बजट के बिना शोधकर्ताओं के लिए आम तौर पर क्या उपलब्ध है — पहले इस आकार के वीडियो कॉर्पस बंद प्रयोगशालाओं के भीतर ही रहते थे।
यह कैसे बनाया गया
लिंक से तैयार क्लिप तक
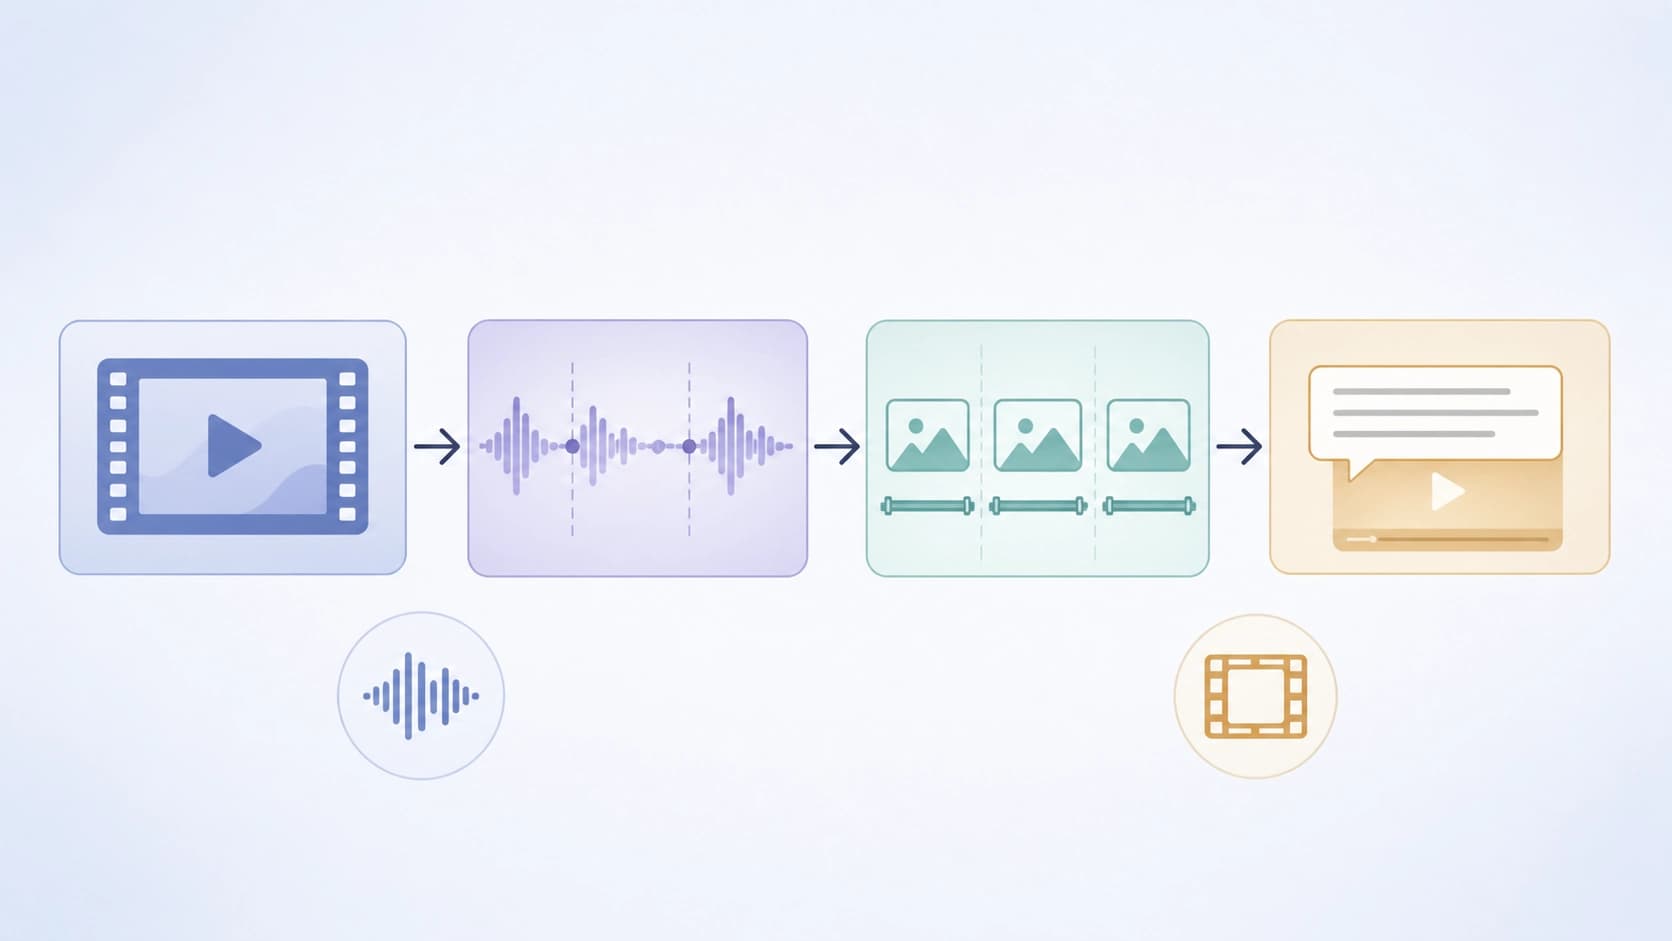
पाइपलाइन कई चरणों में बँटी है, और हर चरण अपने तरीके से ज़रूरी है। पहले लिंक चुने जाते हैं और एक समान रूप में लाए जाते हैं। फिर बड़े पैमाने पर डाउनलोडिंग शुरू होती है। इसके बाद काम में आती है सीन डिटेक्शन, जो फ़्रेम की सामग्री के प्रति संवेदनशील है: लंबा वीडियो किसी तय टाइमकोड पर नहीं, बल्कि असली एडिटिंग कट्स पर काटा जाता है।
इसके बाद — सबसे दिलचस्प हिस्सा। मिले क्लिप के लिए कैप्शन सिंथेटिक रूप से, अपने आप और एक साथ दो मोडैलिटी में बनाए जाते हैं: वीडियो के लिए टेक्स्ट पेयर और ऑडियो ट्रैक के लिए अलग। यानी यहाँ ऑडियो कोई साइड प्रोडक्ट नहीं, बल्कि पूरी तरह एक प्रशिक्षण सिग्नल है।
तैयार ढाँचा एक साथ तीन तरह के डेटा पर प्रीट्रेनिंग के लिए बनाया गया है: वीडियो, ऑडियो और इमेज।
फ़्रेम एक अलग संसाधन के रूप में
लेखकों ने क्लिप तक ही सीमित नहीं रहे। सीन से कट बदलने के क्षण वाले फ़्रेम निकाले जाते हैं और उन्हें "इमेज — टेक्स्ट" जोड़ियों के स्वतंत्र स्रोत के रूप में इस्तेमाल किया जाता है। तर्क सीधा है: वीडियो दृश्य दुनिया का एक अलग कट देता है, आम वेब इमेज संग्रहों की तुलना में — विषयों, एंगल और रोज़मर्रा की बारीकियों के अलग वितरण के साथ। इमेज सर्च जैसे कामों के लिए यह वितरण-बदलाव पहले जैसे ही स्रोतों से दस लाख और फ़ोटो जोड़ने से ज़्यादा उपयोगी साबित हो सकता है।
प्रयोगों ने क्या दिखाया
वीडियो और ऑडियो
नए कॉर्पस पर प्रशिक्षित मॉडल "वीडियो — टेक्स्ट" और "ऑडियो — टेक्स्ट" के मानक बेंचमार्क में प्रतिस्पर्धी स्तर पर पहुँचते हैं। ज़्यादा ज़रूरी बात अलग है: डेटा का आकार या मॉडल का साइज़ बढ़ाने पर गुणवत्ता लगातार बढ़ती है। यही वह संकेत है जो "बस बड़े" डेटासेट को उस डेटासेट से अलग करता है जिसे आगे स्केल करना बनता है।
इमेज
प्रयोगों की एक अलग शाखा — निकाले गए फ़्रेम पर प्रशिक्षण। यहाँ भी नतीजा सकारात्मक है: इमेज सर्च में मज़बूत प्रदर्शन। और यह तब, जब फ़्रेम का वितरण आम वेब कॉर्पस से साफ़ अलग है — यानी फ़ायदा अपने आप में आकार नहीं देता, बल्कि दृश्य डेटा का अलग स्वरूप देता है।
किन बातों का ध्यान रखना चाहिए
- कैप्शन सिंथेटिक हैं: ये हज़ारों मानव-घंटे बचाते हैं, लेकिन शोर और व्यवस्थित गलतियाँ लाते हैं। यहाँ फ़िल्टरिंग की गुणवत्ता कॉर्पस के आकार से ज़्यादा मायने रखती है।
- संग्रह वेब लिंक से शुरू होता है, यानी ऐसे प्रोजेक्ट्स के आम सवाल उठते हैं: लिंक की टिकाऊपन, स्रोतों की उपयोग शर्तें, एट्रिब्यूशन। डेटासेट का खुला लाइसेंस मूल स्रोतों के सवाल खत्म नहीं करता।
- कॉर्पस को शोध-रिलीज़ के रूप में पेश किया गया है — व्यवहार में इसका मतलब है कि प्रवेश की सीमा आंतरिक कॉर्पोरेट सेटों से कम है, लेकिन दूसरों के नतीजों की पुनरुत्पादकता फिर भी अपने हाथों से जाँचनी पड़ेगी।
यह क्यों ज़रूरी है
अब तक इतने आकार का खुला मल्टीमॉडल वीडियो वास्तविकता से ज़्यादा एक वादा था: अकादमिक सेट हज़ारों घंटों में मापे जाते थे, और जो लाखों में मापा जाता था वह कंपनियों का होता था और बाहर नहीं आता था। LAION-BVD इस गणित को बदलता है — और साथ ही उन लोगों के लिए मानक भी बदलता है जो अपने मॉडल बनाते हैं।
व्यावहारिक नतीजे कई हैं। पहला, ईमानदार तुलनाओं का आधार बनता है: अगर सब एक ही खुले कॉर्पस पर प्रशिक्षण लें, तो किसका नतीजा बेहतर है इसकी बहस ज़्यादा सार्थक हो जाती है। दूसरा, छोटी टीमों और विश्वविद्यालयों के पास दूसरों के एम्बेडिंग किराए पर लेने का विकल्प आता है — अपना प्रशिक्षण किया जा सकता है। तीसरा, ऑडियो वीडियो का परिशिष्ट बनना बंद कर देता है और अपनी अलग प्रशिक्षण शाखा पा लेता है।
अब मुख्य सवाल यह नहीं है कि डेटा काफ़ी है या नहीं, बल्कि यह है कि उसे सबसे पहले साफ़ करना कौन सीखेगा। सिंथेटिक कैप्शन, करोड़ों क्लिप और सैंपल में अपरिहार्य कचरा फ़िल्टरिंग और गुणवत्ता मूल्यांकन को पूरी योजना की अड़चन बना देते हैं। डेटासेट खुला है — आगे सब समुदाय पर निर्भर है।


