
समस्या: परीक्षण कम हैं, और उनका इनाम सब कुछ है
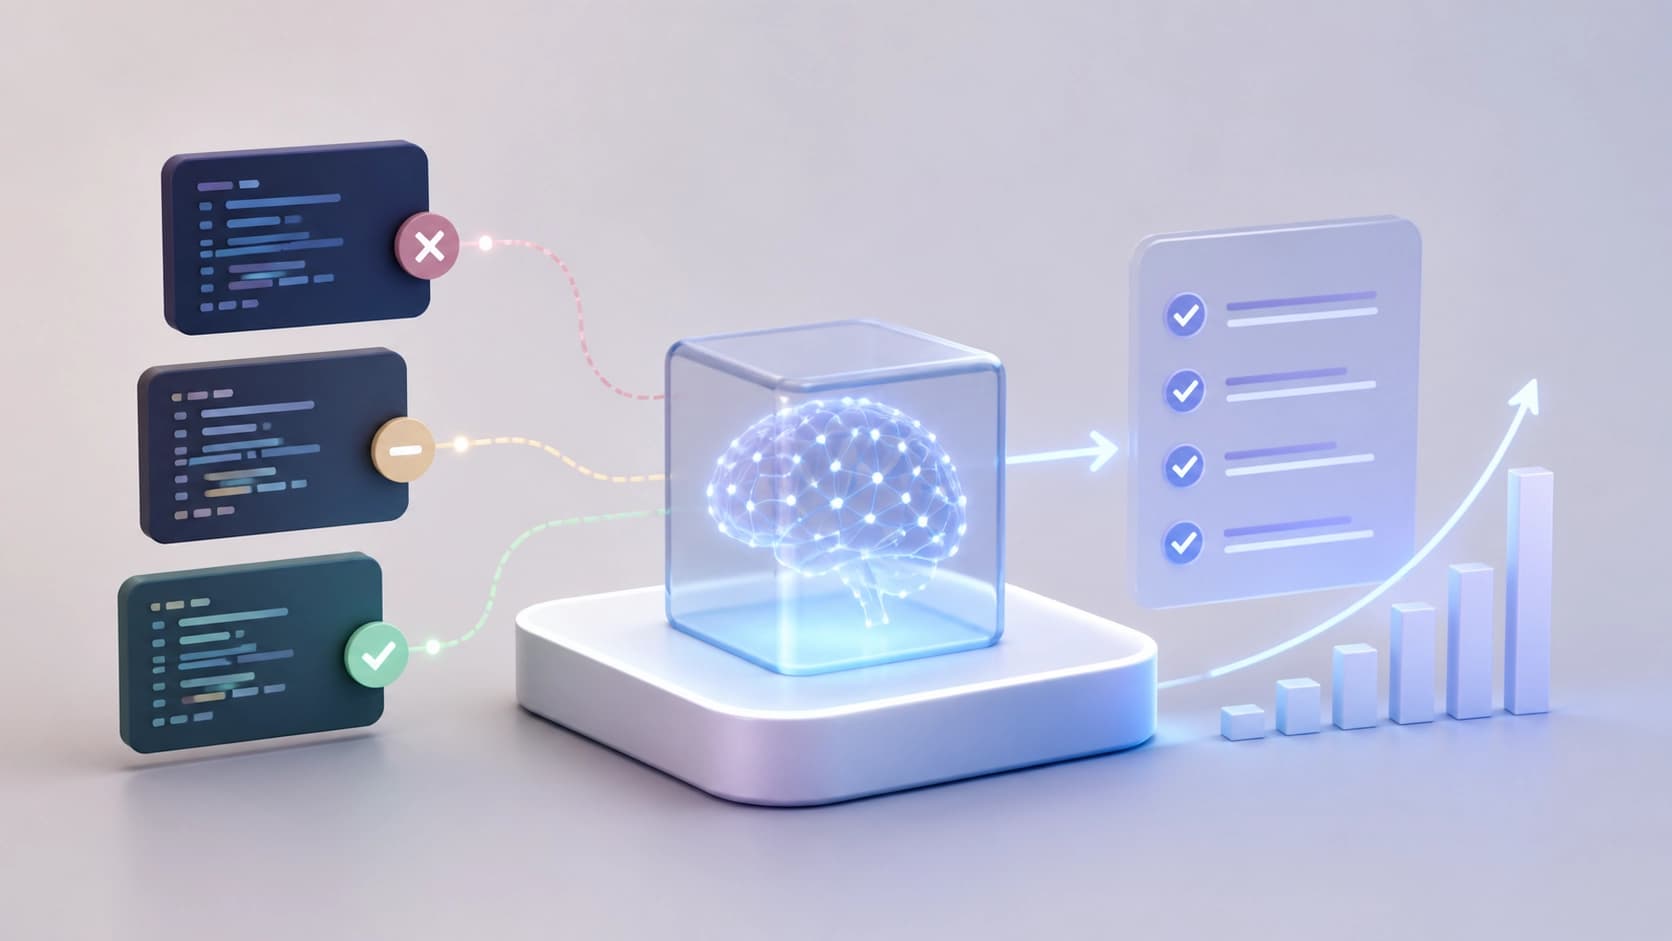
सत्यापनीय इनामों के साथ सुदृढ़ीकरण अधिगम (RLVR) भाषा मॉडलों को कोड जनरेशन में सभ्य स्तर तक पहुँचाने का मुख्य तरीका बन गया है। योजना सरल है: मॉडल एक समाधान लिखता है, एक विशेष जाँच उसे परीक्षणों से गुज़ारती है, और परिणाम के आधार पर मॉडल को इनाम दिया जाता है। सब कुछ एक ही मान्यता पर टिका है — कि परीक्षण वास्तव में कार्य का पूरा वर्णन करते हैं।
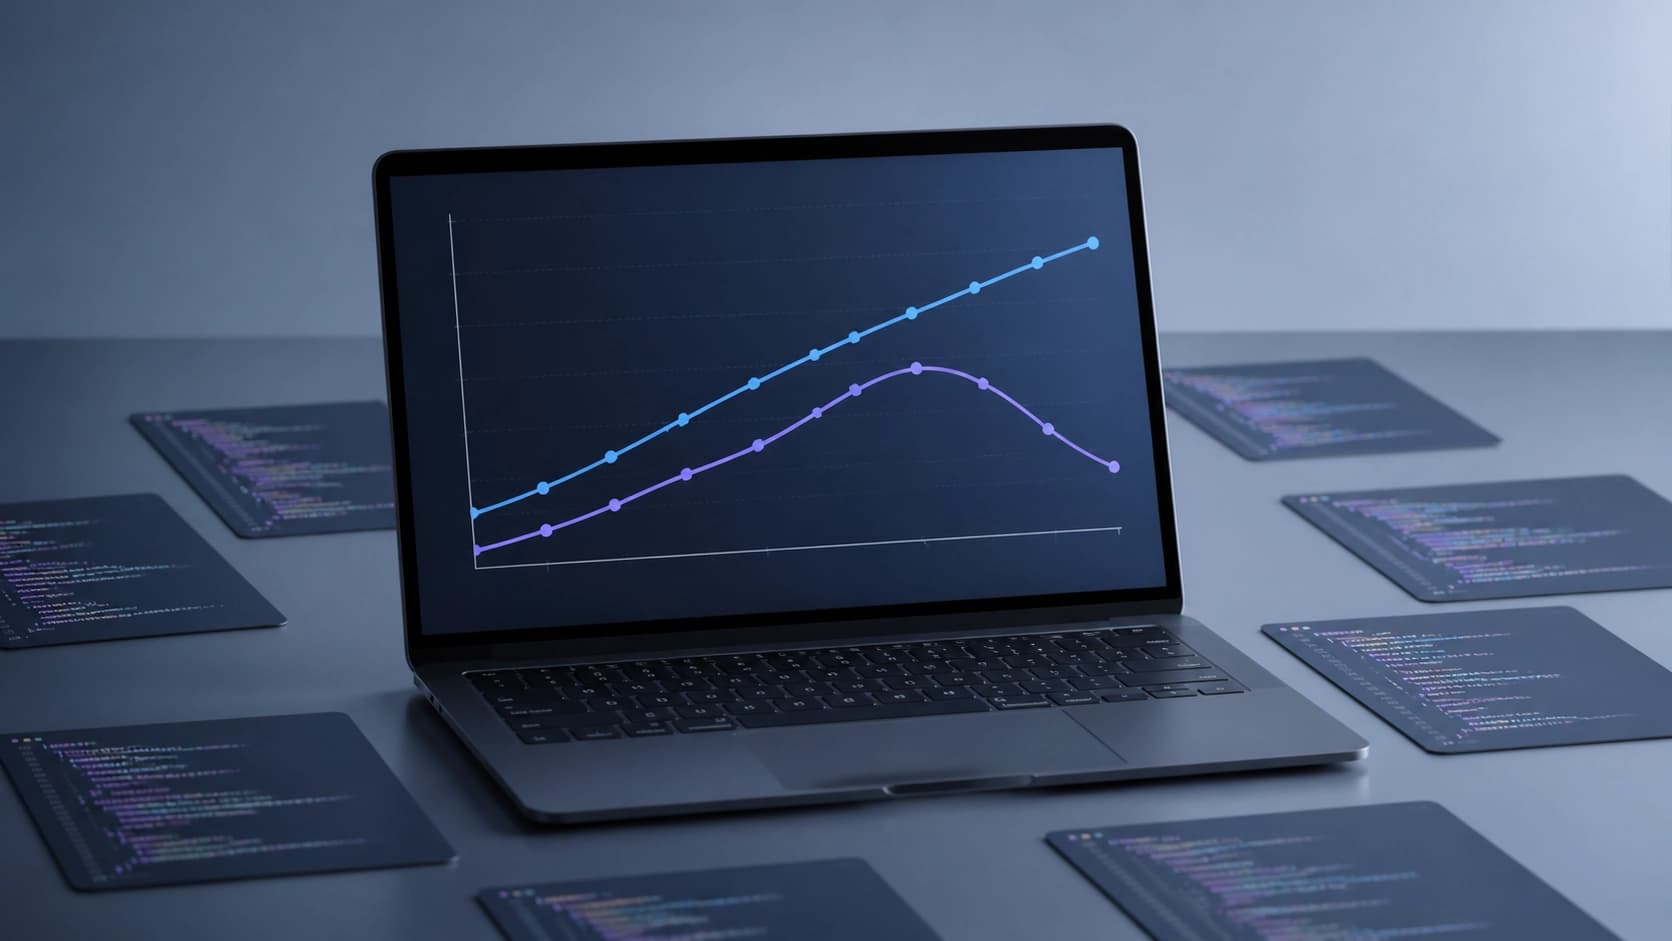
व्यवहार में यह मान्यता लगभग हमेशा टूट जाती है। परीक्षण मामलों का समूह संकीर्ण है, कवरेज में छेद हैं, और मॉडल जल्दी ही कार्य नहीं, बल्कि एक खोखला रास्ता खोज लेता है: यह समान कार्यों के वर्ग को हल करना सीखने के बजाय कोड को विशिष्ट जाँचों के अनुरूप ढाल देता है। फिर परिचित चक्र शुरू होता है — reward hacking, जिसके बाद नीति का ह्रास होता है। मॉडल सामान्य कौशलों में ठीक उतना ही खोता है जितना संकीर्ण चालाकी में हासिल करता है।
एक मोटी उपमा: दो प्रश्नों वाली परीक्षा। जो छात्र इन दो प्रश्नों के उत्तर रट लेता है, उसे पूरे अंक मिलते हैं, पर विषय वह नहीं जानता। और ऐसा प्रशिक्षण जितना लंबा चलता है, वह बाकी सब चीज़ों में उतना ही खराब होता जाता है।
RobustTests का विचार: त्रुटियाँ परीक्षणों के जनरेटर के रूप में
आम तौर पर परीक्षण कार्य की शर्तों से प्रेरित होकर सोचे जाते हैं: कैसे इनपुट होते हैं, श्रेणियों के किनारे कहाँ हैं, खाली इनपुट पर क्या होगा। तर्कसंगत है, पर यही रास्ता संकीर्ण कवरेज देता है — परीक्षणों का लेखक और समाधान का लेखक कार्य को एक ही दृष्टिकोण से देखते हैं और एक ही जगहों के प्रति समान रूप से अंधे होते हैं।
RobustTests इस प्रक्रिया को उलट देता है। फ्रेमवर्क का आधार है त्रुटिपूर्ण कोड-निर्देशित परीक्षण मामला संश्लेषण (faulty-code-driven test case synthesis)। बात किसी यादृच्छिक टूटे कोड की नहीं, बल्कि «लगभग सही» समाधानों की है: वे जो सही समाधान से तर्क में एक छोटे बदलाव से भिन्न होते हैं — उलटा तुलना चिह्न, गलत लूप सीमा, छूटी हुई शाखा। ऐसा प्रत्येक समाधान लगभग काम करता है, और इसीलिए वह मूल्यवान है।
फिर एक ऐसा इनपुट खोजा जाता है जिस पर लगभग सही कोड संदर्भ समाधान से भिन्न हो जाता है। मिला हुआ इनपुट ही परीक्षण बन जाता है। ऐसे परीक्षण में उच्च नैदानिक शक्ति होती है: यह केवल «कुछ जाँचता» नहीं, बल्कि दो निकट व्यवहारों में अंतर करता है — वह जो हम मॉडल से चाहते हैं, और वह जो विश्वसनीय दिखता है पर गलत है।
यह कार्य arXiv प्रीप्रिंट 2608.24135 में वर्णित है (Yiwen Zhang और आठ अन्य लेखक, जिनमें Xiaodong Yan, Zhenyu Huang, Deng Zhao और अन्य शामिल हैं; v1 — 25 अगस्त 2026, v2 — 27 अगस्त 2026, DOI 10.48550/arXiv.2608.24135, EMNLP 2026 के लिए स्वीकृत)। लेखक सामग्री को एक साथ दो श्रेणियों — cs.AI और cs.SE — में रखते हैं, जो तर्कसंगत है: यह मॉडल प्रशिक्षण और परीक्षण इंजीनियरिंग दोनों से जुड़ा है।
निस्पंदन: सत्यापनकर्ता एजेंट और क्लस्टरिंग
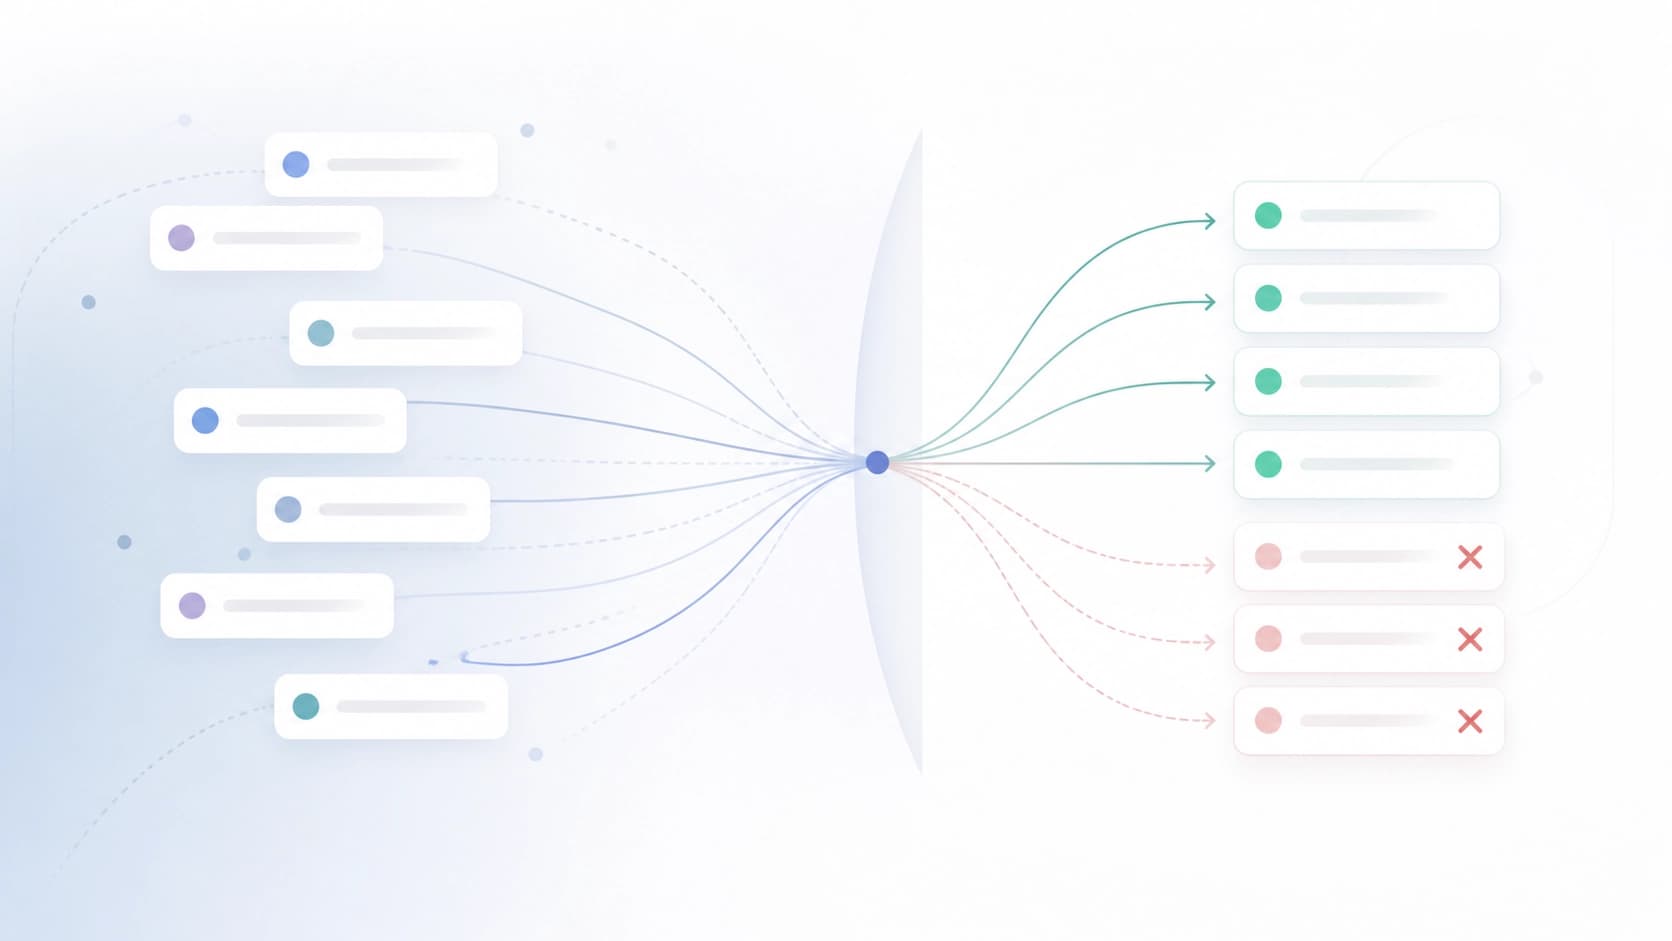
कोई भी स्वचालित परीक्षण संश्लेषण आसानी से कचरे का जनरेटर बन सकता है। सोचे गए इनपुट में से कुछ अमान्य निकलेंगे, कुछ एक-दूसरे की नकल करेंगे, कुछ एक ही व्यवहार को अलग-अलग कोणों से जाँचेंगे। ऐसे समूह से उपयोगी संकेत कम मिलता है और शोर बहुत होता है।
इसलिए पाइपलाइन में एक दूसरी परत रखी गई है — सत्यापनकर्ता एजेंट, जो गलत और अनावश्यक परीक्षण मामलों को छान देते हैं। इनके साथ व्यवहारिक विशेषताओं पर आधारित क्लस्टरिंग जोड़ी गई है: परीक्षणों को इस आधार पर समूहित किया जाता है कि वे कोड के किस व्यवहार में अंतर करते हैं, और समूह के भीतर दोहराव समेट दिए जाते हैं। अंत में एक संक्षिप्त समूह बचता है, जहाँ प्रत्येक तत्व नई जानकारी जोड़ता है, पड़ोसी को दोहराता नहीं।
दुर्लभ संकेत के बजाय सघन इनाम
फ्रेमवर्क का दूसरा घटक परीक्षणों से नहीं, बल्कि इससे जुड़ा है कि उनसे इनाम कैसे निकाला जाता है। पारंपरिक द्विआधारी दृष्टिकोण — «सब पास हुआ या कुछ नहीं» — तब खराब काम करता है जब परीक्षण बहुत हो जाएँ और अलग-अलग कठिनाई के हों: मॉडल लगभग सब हल कर लेता है, एक किनारे वाले मामले पर ठोकर खाता है, और उसे वही शून्य मिलता है जो पूरी तरह टूटे समाधान को मिलता। प्रशिक्षण संकेत टूट जाता है, और उससे सीखने को लगभग कुछ नहीं बचता।
RobustTests चरणबद्ध सघन इनाम फलन (stepwise dense reward) पेश करता है, जो पास की गई जाँचों के अनुपात — pass rate — पर आधारित है। मॉडल को आंशिक संकेत मिलता है और दिशा समझ आती है: «असफलता» नहीं, बल्कि «तीस में से दो परीक्षण बाकी हैं»। यह एक साथ दो समस्याएँ हल करता है। पहला, यह झूठे नकारात्मक परिणामों (false negatives) की संख्या घटाता है, जब किसी सही समाधान को बहुत कड़े या महज़ गलत परीक्षण के कारण अस्वीकार कर दिया जाता है। दूसरा, यह प्रशिक्षण को अधिक स्थिर बनाता है: इनाम एक दुर्लभ घटना होना बंद कर एक पैमाना बन जाता है।
इन दो विचारों के जोड़ पर अलग से ज़ोर देना चाहिए। सघन इनाम का अर्थ तभी है जब परीक्षण वास्तव में विभिन्न प्रकार की त्रुटियों में अंतर करते हों — वरना आप महज़ शोर का औसत निकाल रहे होते हैं। और लगभग सही समाधानों से परीक्षण संश्लेषण सघन इनाम के बिना वही संकेत-विच्छेद छोड़ देगा। घटक जोड़ी में काम करते हैं।
डेटासेट और परिणाम
इस पाइपलाइन पर लेखकों ने CodeContests+ डेटासेट का विस्तारित संस्करण तैयार किया — काफ़ी अधिक नैदानिक उपयोगिता के साथ: परीक्षण समूह अब अधिक सटीकता से बताते हैं कि मॉडल समाधान के किस चरण में गलती करता है।
मुख्य मापदंड डेटासेट का आकार नहीं, बल्कि फ़ाइन-ट्यूनिंग के बाद मॉडल का व्यवहार है। RobustTests का उपयोग करके Qwen3-32B का RL प्रशिक्षण LiveCodeBench पर 3% का पूर्ण लाभ देता है। कोड और डेटा लेखकों ने खुले रूप में उपलब्ध कराए हैं।
यहाँ संयम बनाए रखना चाहिए। एक मॉडल की फ़ाइन-ट्यूनिंग पर एक बेंचमार्क पर तीन प्रतिशत अंक क्षेत्र में क्रांति नहीं, बल्कि स्पष्ट तंत्र वाला सावधान सुधार है। कार्य का मूल्य बल्कि कार्यप्रणाली में है: यह एक पुनरुत्पादनीय नुस्खा प्रस्तुत करता है कि परीक्षणों की संख्या हाथ से बढ़ाए बिना उनसे अधिक संकेत कैसे निकाला जाए। सीमाएँ भी स्पष्ट हैं — परिणाम का अन्य मॉडलों, भाषाओं और कार्य प्रकारों पर स्थानांतरण अभी जाँचा जाना बाकी है।
इसमें से अपनी प्रैक्टिस में क्या लेना चाहिए
भले ही आप RL पाइपलाइन न बना रहे हों और केवल कोड जनरेशन की गुणवत्ता का मूल्यांकन कर रहे हों, यह तर्क लगभग बिना बदलाव के लागू होता है:
- परीक्षण त्रुटियों से लिखें, केवल शर्तों से नहीं। एक ऐसा समाधान लें जो लगभग काम करता है, और वह इनपुट खोजें जहाँ वह टूटता है। ऐसा परीक्षण लगभग हमेशा सीधे-सीधे सोचे गए दस परीक्षणों से अधिक जानकारीपूर्ण होता है।
- पास हुई जाँचों का अनुपात गिनें, पास होने का तथ्य नहीं। आंशिक अंक प्रशिक्षण और गुणवत्ता विश्लेषण दोनों में ग्रेडिएंट देता है — दिखता है कि मॉडल वास्तव में कहाँ असफल होता है।
- संश्लेषित परीक्षणों को छानें। सत्यापन और विरूपण-हटान के बिना स्वचालित रूप से उत्पन्न समूह जल्दी ही एक-दूसरे से मिलती-जुलती जाँचों के ढेर में बदल जाता है।
- ध्यान रखें कि इनाम वास्तव में किसे प्रोत्साहित करता है। सघन पैमाना शॉर्टकट की प्रवृत्ति घटाता है, पर उसे खत्म नहीं करता: यदि परीक्षण व्यवहार में अंतर नहीं करते, तो कोई भी इनाम देर-सबेर हैक हो जाएगा।
RobustTests जो विचार लेकर आता है, वह मानवीय रूप से सरल है: कठिन परीक्षणों का सबसे अच्छा स्रोत लेखक की कल्पना नहीं, बल्कि सिस्टम की अपनी लगभग-त्रुटियाँ हैं। जो मॉडल लगभग सही कर ही रहा था, वही सबसे ईमानदार संकेतक है कि «समाधान जैसा» और «समाधान» के बीच की सीमा कहाँ है।


