
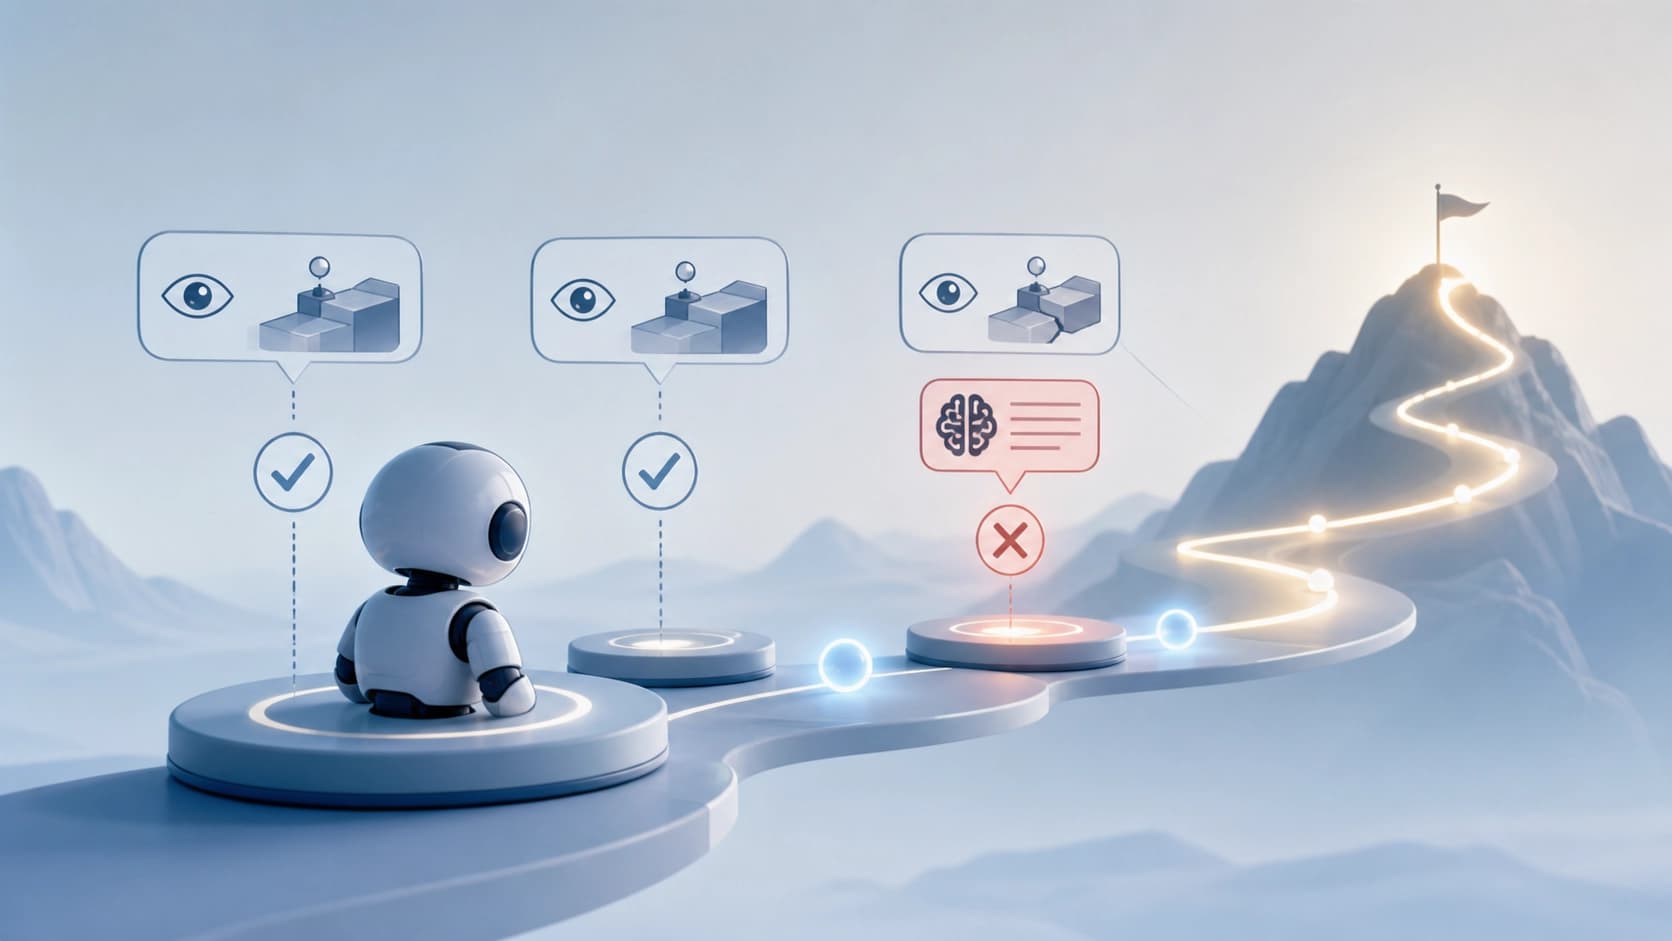
समस्या: पूरी ट्रैजेक्टरी के लिए एक ही इनाम
LLM-आधारित मल्टी-स्टेप एजेंट परीक्षण और त्रुटि से सीखते हैं: वे क्रियाओं की एक श्रृंखला निष्पादित करते हैं, अंतिम मूल्यांकन प्राप्त करते हैं और उसके आधार पर अपने व्यवहार को समायोजित करते हैं। दिक्कत यह है कि यह मूल्यांकन आमतौर पर पूरी ट्रैजेक्टरी पर एक साथ लागू होता है। एजेंट को पता चल जाता है कि कार्य पूरा हुआ या विफल रहा, लेकिन यह नहीं पता चलता कि किस चरण में कुछ गलत हो गया।
इसके बाद वह गणित शुरू होता है, जो सामान्य विवेक से मेल नहीं खाता। समान लाभ सभी चरणों पर समान रूप से बिखेर दिया जाता है — चाहे वह उपकरण का सफल चयन हो, क्वेरी में कोई आकस्मिक टाइपो हो, या नियमित "क्रिया की पुष्टि करें"। नतीजतन, यदि अंतिम परिणाम सफल रहा, तो मॉडल एक साथ आकस्मिक चूकों और सामान्य कार्य-चरणों दोनों को पुरस्कृत करता है। सफलता का श्रेय सभी को समान रूप से मिलता है, और विफलता का दोष भी सभी को।
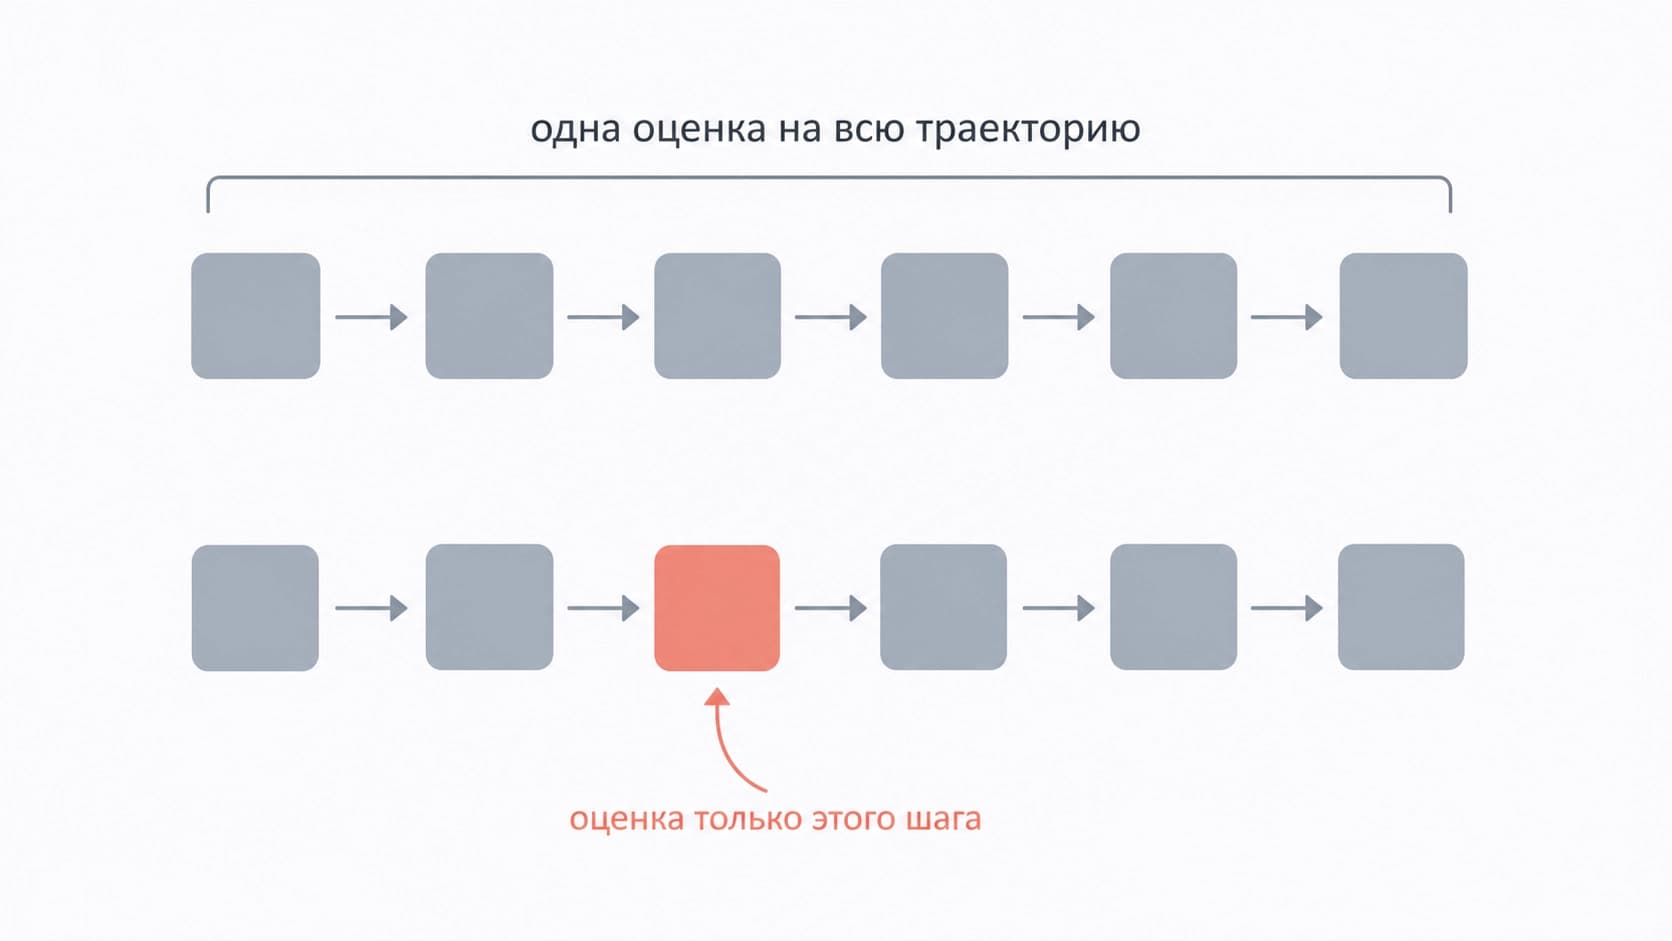
पारंपरिक उपचार है — विशेषाधिकार प्राप्त जानकारी के साथ स्व-आसवन। शिक्षक शिष्य से अधिक जानता है: उसके पास पर्यावरण तक पहुंच, मध्यवर्ती संकेतों तक पहुंच और सही उत्तर तक पहुंच होती है। वह केवल अंत में ही नहीं, बल्कि हर चरण पर मार्गदर्शन दे सकता है। सुनने में अच्छा लगता है, लेकिन इस दृष्टिकोण में एक छिपी हुई लापरवाही है: एक ही संकेत बिना किसी भेदभाव के सभी चरणों को दिया जाता है।
चरणों की विषमता: नियमित कार्यों और त्रुटियों को अलग-अलग चीज़ें चाहिए
AHEAD शोध का मुख्य विचार यह है कि ट्रैजेक्टरी में चरण समान मूल्य के नहीं होते, और उनके लिए सुपरविज़न भी अलग-अलग होना चाहिए।
- नियमित चरण — पृष्ठ खोलना, नेविगेशन की पुष्टि करना, आवश्यक उपकरण को कॉल करना — इन्हें संकेतों की लगभग आवश्यकता नहीं होती। मॉडल स्वयं ही संभाल लेता है। यहां अनावश्यक मार्गदर्शन केवल प्रशिक्षण में शोर बढ़ाता है और बजट खर्च करता है।
- त्रुटि वाले महत्वपूर्ण चरण — जहां एजेंट गलत मुड़ गया और सफलता का अवसर खो दिया — इन्हें केवल "यहां गलत है" कहने की नहीं, बल्कि ठोस दिशा की आवश्यकता होती है: इसके बजाय क्या करना चाहिए था।
- पर्यावरण से प्रतिक्रिया घटनाओं को अच्छी तरह जमीन पर टिकाती है: यह बताती है कि वास्तव में क्या हुआ। लेकिन यह यह समझाने में सक्षम नहीं है कि क्या करना चाहिए था। संकेत "दरवाजा नहीं खुला" यह नहीं बताता कि चाबी कहां रखी थी।
इससे पता चलता है कि सुपरविज़न के दो स्रोत एक-दूसरे के पूरक हैं, लेकिन एक-दूसरे के विकल्प नहीं। पर्यावरण की प्रतिक्रिया हर चरण पर सघन और ईमानदार संकेत देती है; मॉडल द्वारा उत्पन्न सुधारात्मक संकेत वह देते हैं जो पर्यावरण की प्रतिक्रिया में मूल रूप से नहीं है — आशय और विकल्प। उन्हें पूरी ट्रैजेक्टरी पर बिना सोचे-समझे मिलाना — दोनों की ताकत खोने के बराबर है।
AHEAD कैसे काम करता है
लेखक — Xiaolong Jin, Dingmin Wang, Vijay Lingam और Varun Kumar — एक ऐसा फ्रेमवर्क प्रस्तावित करते हैं जो चरण के प्रकार को पहचानता है और उसके अनुसार सुपरविज़न का स्रोत चुनता है। यह शोध अगस्त 2026 के अंत में arXiv पर प्रकाशित हुआ, श्रेणी cs.AI; आकार — 22 पृष्ठ, 15 चित्र और 7 तालिकाएं, यानी विवरण के लिए पर्याप्त सामग्री है।
वह शिक्षक जो पर्यावरण को देखता है
शिक्षक मॉडल को सभी चरणों पर पर्यावरण की प्रतिक्रिया मिलती है — यह एक जमीन पर टिका और सघन संकेत है, जो सफल और विफल दोनों हिस्सों में समान रूप से उपलब्ध है। ऐसा शिक्षक कल्पना नहीं करता: वह उस पर निर्भर करता है जो वास्तव में पर्यावरण में हुआ।
सुधारात्मक संकेत — लक्षित रूप से
इसके ऊपर शिक्षक को LLM द्वारा उत्पन्न संकेत मिलते हैं, लेकिन सभी चरणों पर नहीं, बल्कि विशेष रूप से त्रुटिपूर्ण चरणों पर। तर्क सरल है: जहां एजेंट ने गलती की, वहां पर्यावरण से मिले तथ्य मात्र पर्याप्त नहीं है, यह समझाने की आवश्यकता है कि किस दिशा में बढ़ना चाहिए था। जहां सब कुछ सुचारू रूप से चल रहा है, वहां अतिरिक्त मार्गदर्शन बिल्कुल नहीं जोड़ा जाता।
यही नाम में मौजूद "लक्षित संकेत" है: ट्रैजेक्टरी पर बिखरा हुआ नहीं, बल्कि समस्याग्रस्त बिंदुओं पर केंद्रित। क्रियाओं की पूरी श्रृंखला के लिए एकल संकेत के बजाय सुपरविज़न स्रोतों का चरण-जागरूक मिलान।
GRPO में न्यूनतम संशोधन
इस पद्धति की इंजीनियरिंग-विनम्रता अलग से उल्लेखनीय है। GRPO — एक लोकप्रिय रीइन्फोर्समेंट लर्निंग एल्गोरिदम — को शून्य से नहीं लिखा जाता: मानक योजना के ऊपर लक्षित रूप से बदलाव किए जाते हैं। व्यवसायियों के लिए यह महत्वपूर्ण है, क्योंकि इसके लिए एजेंट के प्रशिक्षण पाइपलाइन को पूरी तरह से फिर से बनाने की आवश्यकता नहीं होती।
प्रयोगों ने क्या दिखाया
मूल्यांकन तीन प्रकार के कार्यों पर किया गया: ALFWorld — टेक्स्ट वातावरण में मल्टी-स्टेप परिदृश्य, WebShop — ऑनलाइन स्टोर के साथ इंटरैक्शन, और खोजपूर्ण प्रश्न-उत्तर। तीन अलग-अलग पैमानों के मॉडलों का परीक्षण किया गया, इसलिए निष्कर्ष किसी एक आकार से बंधे नहीं हैं।
सामान्य GRPO की तुलना में परिणाम:
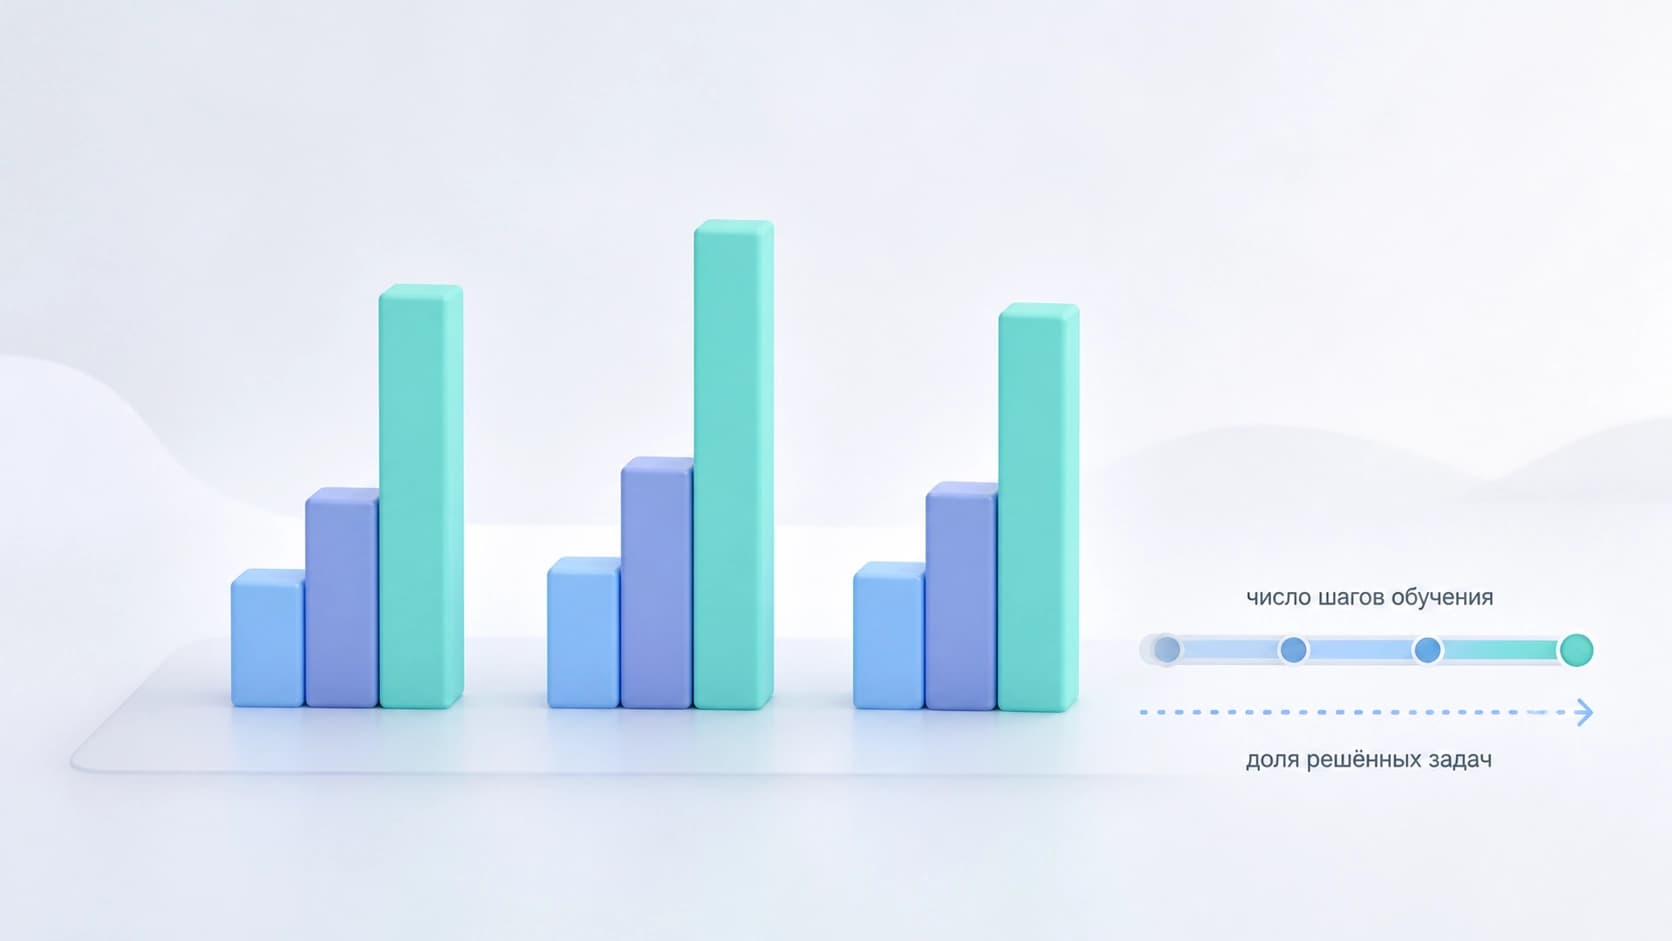
- ALFWorld पर 7B मॉडल के साथ सफलता दर में +13.3 अंक;
- उसी पैमाने पर WebShop पर +11.0 अंक।
पूर्ण संख्याओं के अलावा, दो समान रूप से रोचक प्रभाव भी हैं। पहला, निर्धारित सफलता स्तर कम प्रशिक्षण चरणों में प्राप्त होता है — यानी यह पद्धति न केवल सीमा में बेहतर है, बल्कि कार्यशील स्थिति तक तेजी से पहुंचती है। दूसरा, एजेंट अधिक संकीर्ण इंटरैक्शन बजट में कार्यों को हल करता है, की तुलना में केवल अंतिम इनाम पर आधारित दृष्टिकोण और पिछली स्व-आसवन विधियां।
दूसरा बिंदु, मेरे विचार से, कम आंका गया है। इंटरैक्शन चरणों की बचत — यह केवल सुंदरता का मीट्रिक नहीं है। वास्तविक परिदृश्यों में प्रत्येक उपकरण कॉल में पैसा, समय और जोखिम लगता है। जो एजेंट दस के बजाय पांच क्रियाओं में लक्ष्य तक पहुंचता है, वह 13 प्रतिशत नहीं, बल्कि कई गुना अधिक उपयोगी है — खासकर वहां जहां गलती की कीमत अधिक होती है।
यह क्यों काम करता है और क्या पर्दे के पीछे रह जाता है
इस पद्धति की व्याख्या लगभग शैक्षणिक है। एक अच्छा शिक्षक छात्र की हर गतिविधि पर टिप्पणी नहीं करता — जब तक छात्र उचित काम कर रहा हो तब वह चुप रहता है, और ठीक वहीं हस्तक्षेप करता है जहां छात्र रास्ते से भटक गया हो। यदि हर चीज़ पर टिप्पणी की जाए, तो छात्र स्वयं सोचना बंद कर देता है और संकेतों की प्रतीक्षा करने लगता है। यदि कुछ भी टिप्पणी न की जाए, तो वह वही गलतियां दोहराता रहेगा।
AHEAD इस अंतर्ज्ञान को रीइन्फोर्समेंट लर्निंग की शब्दावली में औपचारिक रूप देता है: अलग चरण प्रकार — अलग संकेत स्रोत। सघन जमीन पर टिकी प्रतिक्रिया — पृष्ठभूमि के रूप में, सुधारात्मक दिशा — जोर के रूप में। कोई जादू नहीं, बस इस विचार का त्याग कि सभी चरण समान हैं।
क्या प्रश्न बने रहते हैं। सुधारात्मक संकेतों का उत्पादन स्वयं एक मॉडल की आवश्यकता रखता है, और इसलिए यह कंप्यूटेशनल लागत जोड़ता है और उसकी गुणवत्ता पर निर्भर करता है — यदि शिक्षक गलत समझाता है, तो शिष्य को आत्मविश्वासपूर्ण लेकिन गलत दिशा मिलेगी। यह भी खुला प्रश्न है कि यह पद्धति उन कार्यों पर कितनी स्थानांतरित होती है जहां मध्यवर्ती चरण की कीमत ALFWorld या WebShop की तरह स्पष्ट नहीं है, और जहां चरण की "त्रुटिपूर्णता" को हमेशा तुरंत निर्धारित नहीं किया जा सकता, बल्कि केवल विलंबित परिणामों से।
फिर भी दिशा स्वस्थ दिखती है। हाल के वर्षों में एजेंट पद्धतियों के विकास की मुख्य रेखा — मॉडल को बड़ा करना नहीं, बल्कि प्रशिक्षण संकेत का अधिक समझदारी से उपयोग करना है। AHEAD ठीक इसी रेखा से है: सर्वव्यापी नियंत्रण के बजाय लक्षित हस्तक्षेप।


