
कच्चा डेटा, तैयार तालिकाओं के बजाय
मॉडल अब तेज़ी से कोड एजेंट की भूमिका निभा रहे हैं: उन्हें डेटा प्रोसेसिंग के लिए स्क्रिप्ट लिखने, ग्राफ़ बनाने, मेट्रिक्स की गणना करने और इंजीनियरिंग डेटा एक्सपोर्ट को संभालने का काम सौंपा जाता है। लेकिन कार्यों की एक श्रेणी ऐसी है, जिसकी अब तक लगभग जाँच नहीं हुई है — भौतिक स्तर के "कच्चे माल" के साथ काम करना। यही क्षेत्र EMRB (Electromagnetic Reasoning Benchmark) बेंचमार्क भरता है, जिसका वर्णन arXiv:2608.24086 प्रीप्रिंट में किया गया है (अनुभाग cs.AI, cs.CE, cs.SE)।
मुख्य विचार सरल है और इसीलिए ठोस भी। इनपुट में केवल कच्ची I/Q रिकॉर्डिंग होती है, यानी सिग्नल के क्वाडरेचर सैंपल, जैसे वे रिसीवर से आते हैं। कोई पूर्व-प्रोसेस किए गए फ़ीचर नहीं, लेबल वाले स्पेक्ट्रोग्राम तो बिल्कुल नहीं, और तैयार मानों वाली तालिकाएँ तो कहिए ही नहीं। जिस राशि से प्रश्न संबंधित है, मॉडल को उसे पहले डेटा में खोजना होता है — उस कोड के ज़रिए जो वह खुद लिखेगा और चलाएगा।
यह सामान्य मापों से कैसे अलग है
पिछले कुछ वर्षों में ऐसे कई कार्य-संग्रह सामने आए हैं जिनमें मॉडलों से रेडियो सिग्नल पर विचार करने को कहा जाता है। लेकिन अक्सर वहाँ मॉडल का काम पहले ही किया जा चुका होता है: रिकॉर्डिंग से फ़ीचर निकाल लिए गए, स्पेक्ट्रम की गणना कर ली गई, शोर का स्तर आँक लिया गया, और सब कुछ एक संरचित तालिका में सजा दिया गया। ऐसी स्थिति में केवल अंकगणित और संख्याओं की तुलना बचती है — कौशल उपयोगी हैं, पर रेडियोभौतिकी से उनका कोई संबंध नहीं।
अंतर मूलभूत है। जब राशियाँ पहले से दी गई हों, तो शुरुआती चरण की त्रुटि दिखती ही नहीं: बैंडविड्थ या आवृत्ति का गलत अनुमान उठता ही नहीं, क्योंकि ये मान शर्त में दे दिए गए। जब डेटा अनप्रोसेस्ड हो, तो सिग्नल की खोज के चरण में हुई कोई भी त्रुटि अपने साथ पूरी आगे की गणना खींच ले जाती है। इसीलिए EMRB शब्दावली का ज्ञान नहीं, बल्कि एक श्रृंखला बनाने की क्षमता जाँचता है: सैंपलों को देखना, समझना कि वहाँ कौन-सा सिग्नल है, आवश्यक विशेषता अलग करना, उसकी सही गणना करना और आयाम न खोना।
बेंचमार्क कैसे बना है
लेखक — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang और Shan Huang — ने 200 कार्य तैयार किए। कार्यों को पाँच कठिनाई स्तरों और 27 प्रश्न प्रकारों में बाँटा गया है: साधारण सिग्नल डिटेक्शन से लेकर OFDM सिस्टम के डिज़ाइन तक। सामग्री का स्रोत 11 प्रकार के सिग्नल हैं, और हर एक के लिए सत्यापित संदर्भ सत्य तैयार किया गया है।
पाँच स्तर
स्तर मॉडल की बढ़ती स्वायत्तता के क्रम में बनाए गए हैं। सबसे नीचे बुनियादी मापदंडों का मापन है: सिग्नल खोजना, उसकी विशेषताओं का अनुमान लगाना। ऊपर व्याख्या और तुलना है, फिर कई चरणों वाला विश्लेषण, उसके बाद निदान, और अंत में सिस्टम डिज़ाइन, जहाँ मॉडल से मापने के बजाय दी गई आवश्यकताओं के अनुरूप समाधान डिज़ाइन करने की अपेक्षा होती है।
27 प्रश्न प्रकार और 11 सिग्नल प्रकार
इतनी विविधता इसलिए ज़रूरी है ताकि परिणाम किसी एक सफल या असफल शब्दावली पर निर्भर न हो। अलग-अलग सिग्नल प्रकार अलग-अलग जाल बिछाते हैं: कहीं शोर परेशान करता है, कहीं स्पेक्ट्रम में ओवरलैप, और कहीं सैंपलिंग के साथ सावधानी से निपटना पड़ता है। प्रश्न और सिग्नल प्रकार मिलकर एक ऐसा क्षेत्र बनाते हैं जिसमें संयोग से सही अनुमान लगाना मुश्किल है।
खुला डेटा
सभी सामग्री और कोड एक सार्वजनिक GitHub रिपॉज़िटरी में रखे गए हैं, इसलिए परिणाम को स्वतंत्र रूप से दोबारा जाँचा जा सकता है। बेंचमार्क के लिए यह सामान्य से अधिक महत्वपूर्ण है: यदि कार्य फ़ील्ड रिकॉर्डिंग से हाथ से जोड़े जाने के बजाय जनरेट किए गए हैं, तो संदर्भ सत्य की सटीकता का प्रश्न केंद्रीय हो जाता है — और यहाँ खुलापन ही एकमात्र कारगर उत्तर है।
मॉडलों ने क्या दिखाया
14 भाषा मॉडलों की जाँच की गई: प्रोप्राइटरी, खुले वज़न वाले, और अलग से तर्क-केंद्रित मॉडल। कुल विस्तार — 24.1% से 78.9% तक। यह दायरा अपने आप में बहुत कुछ कहता है: सर्वश्रेष्ठ और सबसे खराब मॉडल के बीच का अंतर यहाँ प्रतिशत में नहीं, गुणकों में मापा जाता है।
लेकिन इससे भी दिलचस्प बात और है। स्तर जैसे-जैसे कठिन होता जाता है, औसत परिणाम तेज़ी से गिरता है: बुनियादी मापों पर 84.9% से लेकर सिस्टम डिज़ाइन पर 21.2% तक। यानी जब किसी मापी जा सकने वाली राशि की गणना करनी हो तो मॉडल ठीक-ठाक काम करते हैं, और जब इन राशियों से एक काम करने वाला समाधान जोड़ना हो तो लगभग बिखर जाते हैं।
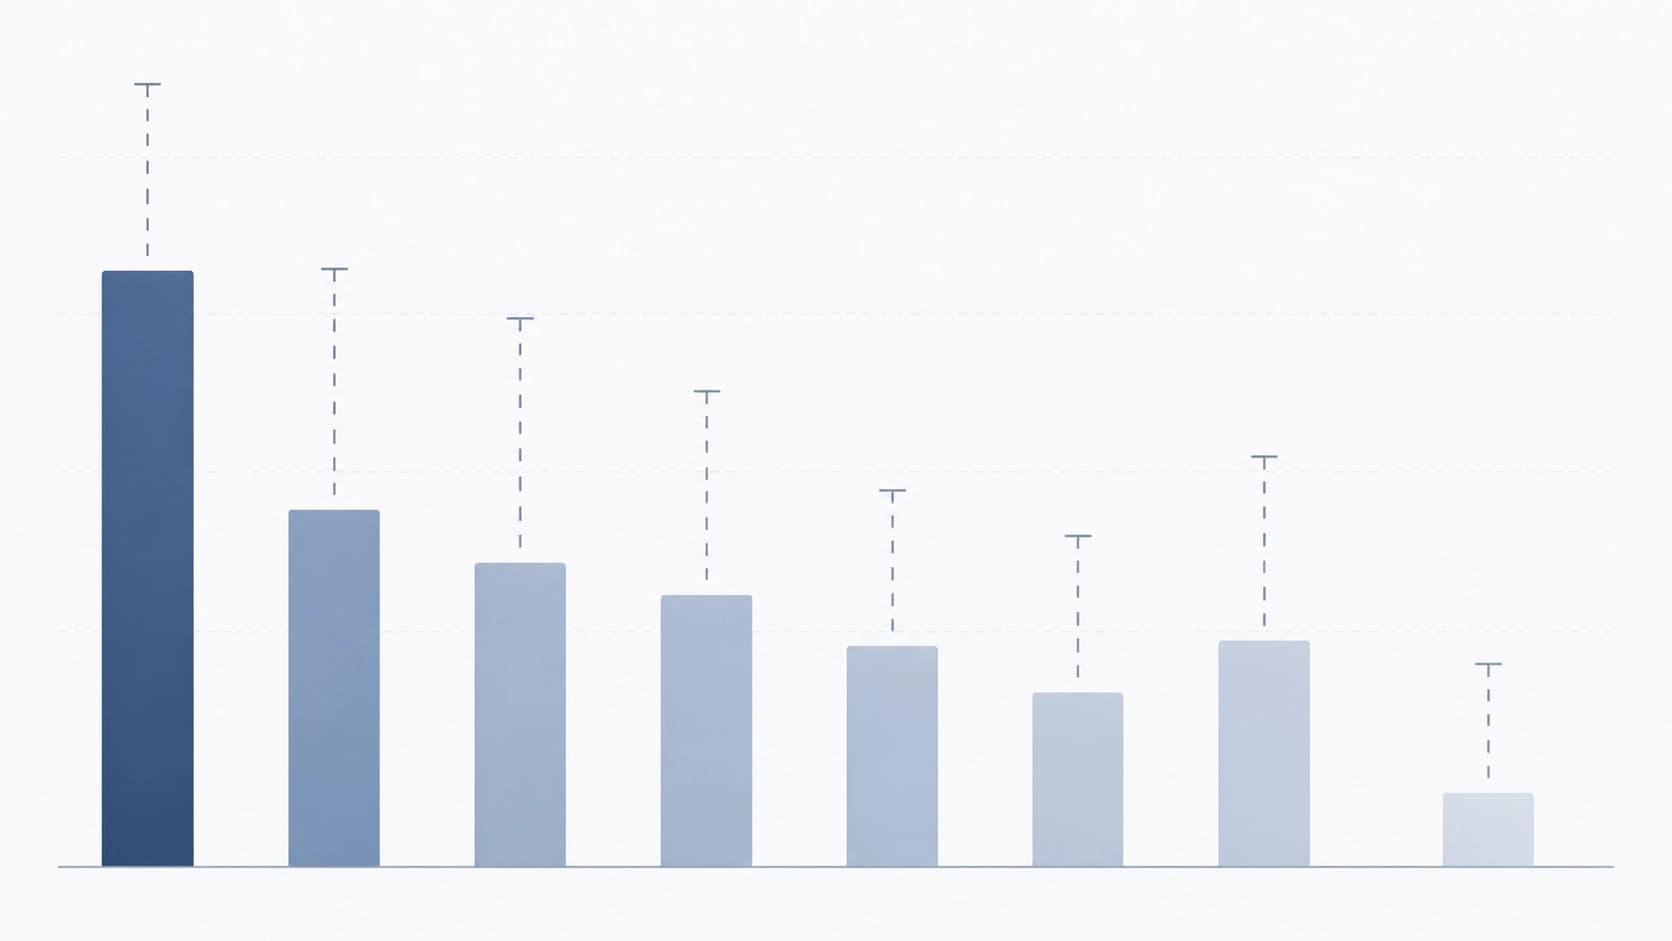
इसे रैंकिंग के बजाय निदान की तरह पढ़ना चाहिए। आज के मॉडलों की ताकत कोड का निष्पादन और ज्ञात समस्या-रचना पर अंकगणित है। कमज़ोरी है इंजीनियरिंग कार्य को मापे जा सकने वाले चरणों की भाषा में बदलना: यह समझना कि कौन-सी राशियाँ चाहिए, किस क्रम में खोजनी हैं, और यह कैसे जाँचना है कि जो मिला वह सच जैसा भी लगता है या नहीं। यही खाई बेंचमार्क को उपयोगी बनाती है।
ReconPilot: खोज, विश्लेषण, जाँच
लेखक केवल मापन तक सीमित नहीं रहे। उन्होंने ReconPilot प्रस्तावित किया — एक संरचित दृष्टिकोण, जिसमें काम तीन चरणों में बाँटा गया है: सिग्नल की खोज, लक्षित विश्लेषण और स्व-जाँच। पहले मॉडल रिकॉर्डिंग का अध्ययन करता है और यह समझ बनाता है कि उसका सामना किससे है। फिर वह विशिष्ट कार्य हल करता है। इसके बाद अपने परिणाम पर लौटता है और उसकी संगति जाँचता है।
तीन बुनियादी मॉडलों पर यह विधि कुल स्कोर में 3.8 से 17.6 अंक जोड़ती है। परीक्षण किए गए 15 में से 13 "बैकबोन + स्तर" संयोजनों में सुधार हासिल हुआ। शब्दावली पर ध्यान दें: लाभ एक समान नहीं है, और दो मामलों में तो बिल्कुल भी नहीं है। यह ईमानदार प्रयोग का सामान्य लक्षण है — कोई सर्वव्यापी रामबाण नहीं मिला, पर प्रवृत्ति स्थिर है।
यह संकेतक है कि मदद ठीक चरणों के स्पष्ट विभाजन से मिलती है। जिस मॉडल से बस "सिग्नल का विश्लेषण करो" कहा जाए, वह यह सुनिश्चित किए बिना कि उसने डेटा समझा है, गणना की ओर कूद जाता है। एक अलग अनिवार्य चरण के रूप में खोज मॉडल को पहले देखने पर और फिर गिनने पर मजबूर करती है।
इससे क्या निकलता है
इंजीनियरिंग अभ्यास के लिए निष्कर्ष काफ़ी सीधा है: वास्तविक मापों पर एजेंट की गणनाओं पर भरोसा करने से पहले, उसे बिना संकेतों वाले डेटा पर जाँच लेना चाहिए। सुविधाजनक इंटरफ़ेस और चैट में चिकना जवाब यह नहीं बताते कि मॉडल रिसीवर से आए अनप्रोसेस्ड एक्सपोर्ट से टकराकर टिकेगा या नहीं।
एक और व्यापक विचार भी है, जो रेडियो की सीमाओं से आगे जाता है। किसी भी ऐसे क्षेत्र में जहाँ तर्क कच्चे मापों पर टिकता है — जलध्वनिकी, कंपन, टेलीमेट्री — एजेंट को पहले डेटा में राशि खोजनी आनी चाहिए, और फिर उस पर काम करना। फ़ीचर वाली तालिकाएँ काम का यह हिस्सा छिपा देती हैं, और उसके साथ त्रुटियाँ भी छिप जाती हैं।
सीमाएँ और आगे क्या
प्रश्न को पूरी तरह बंद नहीं कहा जा सकता। 200 कार्य एक ठीक-ठाक आकार है, पर असीमित नहीं, और 11 सिग्नल प्रकारों पर आधारित जनरेशन का मतलब है कि अपने सभी आर्टिफ़ैक्ट्स के साथ वास्तविक फ़ील्ड रिकॉर्डिंग वहाँ फिर भी मौजूद नहीं हैं। 14 मॉडलों का मूल्यांकन क्षण की एक तस्वीर है, फ़ैसला नहीं: इस क्षेत्र में अग्रणियों की सूची तेज़ी से बदलती है।
फिर भी कार्य की रचना सही लगती है। अगर हम चाहते हैं कि LLM डेटा के पुनर्कथन के बजाय डेटा के साथ ही काम करें, तो उन्हें ठीक वहीं जाँचना चाहिए जहाँ संकेत समाप्त हो जाते हैं। EMRB यही करता है — और दिखाता है कि सिग्नल की खोज में मॉडलों के पास बढ़ने की गुंजाइश अभी बहुत बड़ी है।


