एजेंटों को एक और माप की ज़रूरत क्यों पड़ी
अधिकांश एजेंटिक बेंचमार्क स्पष्ट सवालों का जवाब देते हैं: मॉडल ने सही टूल चुना या नहीं, आर्गुमेंट सही तरीके से जुटाए या नहीं, मनचाहे नतीजे तक पहुँचा या नहीं। ऐसे लगभग सभी माप अनुक्रमिक निष्पादन के इर्द-गिर्द बने हैं — एक के बाद एक कॉल, बिना जल्दबाज़ी और संसाधनों के लिए मुकाबले के।
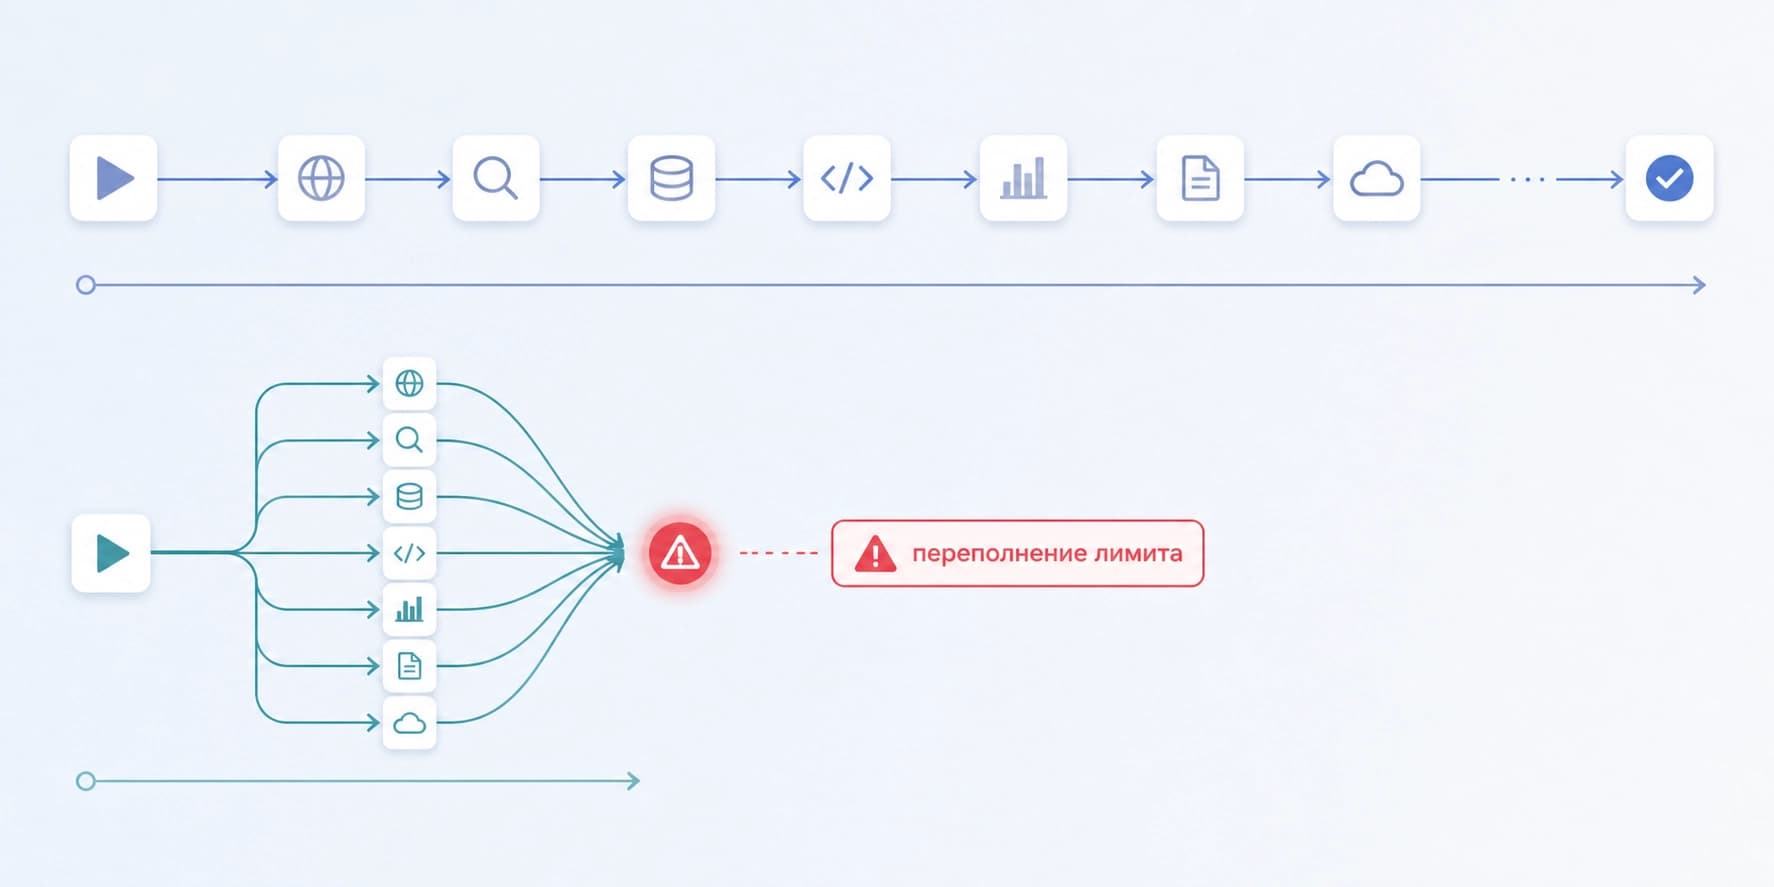
उत्पादन में तस्वीर अलग होती है। स्वीकार्य विलंबता के भीतर रहने के लिए एजेंट को स्वतंत्र कॉल समानांतर रूप से चलाने पड़ते हैं। लेकिन सीमाओं की परवाह किए बिना समानांतरता एक और दीवार से टकराती है: खत्म हो चुके कोटे, भर चुकी मेमोरी, गिर चुकी बाहरी सेवा।
PeakBench ठीक इसी अंधे क्षेत्र के बारे में है। लेखक Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan और Han-Jia Ye इसे प्रीप्रिंट arXiv:2608.24509 (25 अगस्त 2026 का v1, श्रेणियाँ cs.AI और cs.SE) में बताते हैं; कोड लेख के साथ जारी करने का वादा है।
वह मुख्य विचार जिससे पूरा काम निकलता है: एजेंट के पास विफल होने के दो तरीके हैं, और वे एक-दूसरे के विपरीत हैं। अनुक्रमिक निष्पादन सुरक्षित है, पर धीमा — सीमाएँ इसलिए नहीं टूटतीं कि एक साथ कुछ हो ही नहीं रहा। संसाधनों की गिनती किए बिना समानांतरता तेज़ है, पर ऐसे ओवरफ़्लो की ओर ले जाती है जिनसे आसानी से बचा जा सकता था। इन दो ध्रुवों के बीच ही वह क्षेत्र है जिसे किसी ने ठीक से नहीं मापा।
बेंचमार्क क्या है
यहाँ संदर्भ उत्तरों वाले स्थिर कार्यों की जगह निष्पादन-योग्य बहु-उपकरण वर्कफ़्लो इस्तेमाल होते हैं। हर एक में दो अहम जोड़ हैं: निर्भरता एनोटेशन, जो दिखाते हैं कि कौन-से चरण वाकई एक-दूसरे से जुड़े हैं, और मापे गए संसाधन प्रोफ़ाइल — कोई ख़ास कॉल कितनी मेमोरी, समय या कोटा खाती है।
ऐसी बनावट मूल्यांकन के विषय को ही बदल देती है। सवाल "सही जवाब मिला या नहीं" पीछे चला जाता है, और सामने आता है सवाल "एजेंट ने काम को समय में कैसे बाँटा और क्या वह बजट से बाहर निकला"।
तार्किक योजना बनाम भौतिक योजना
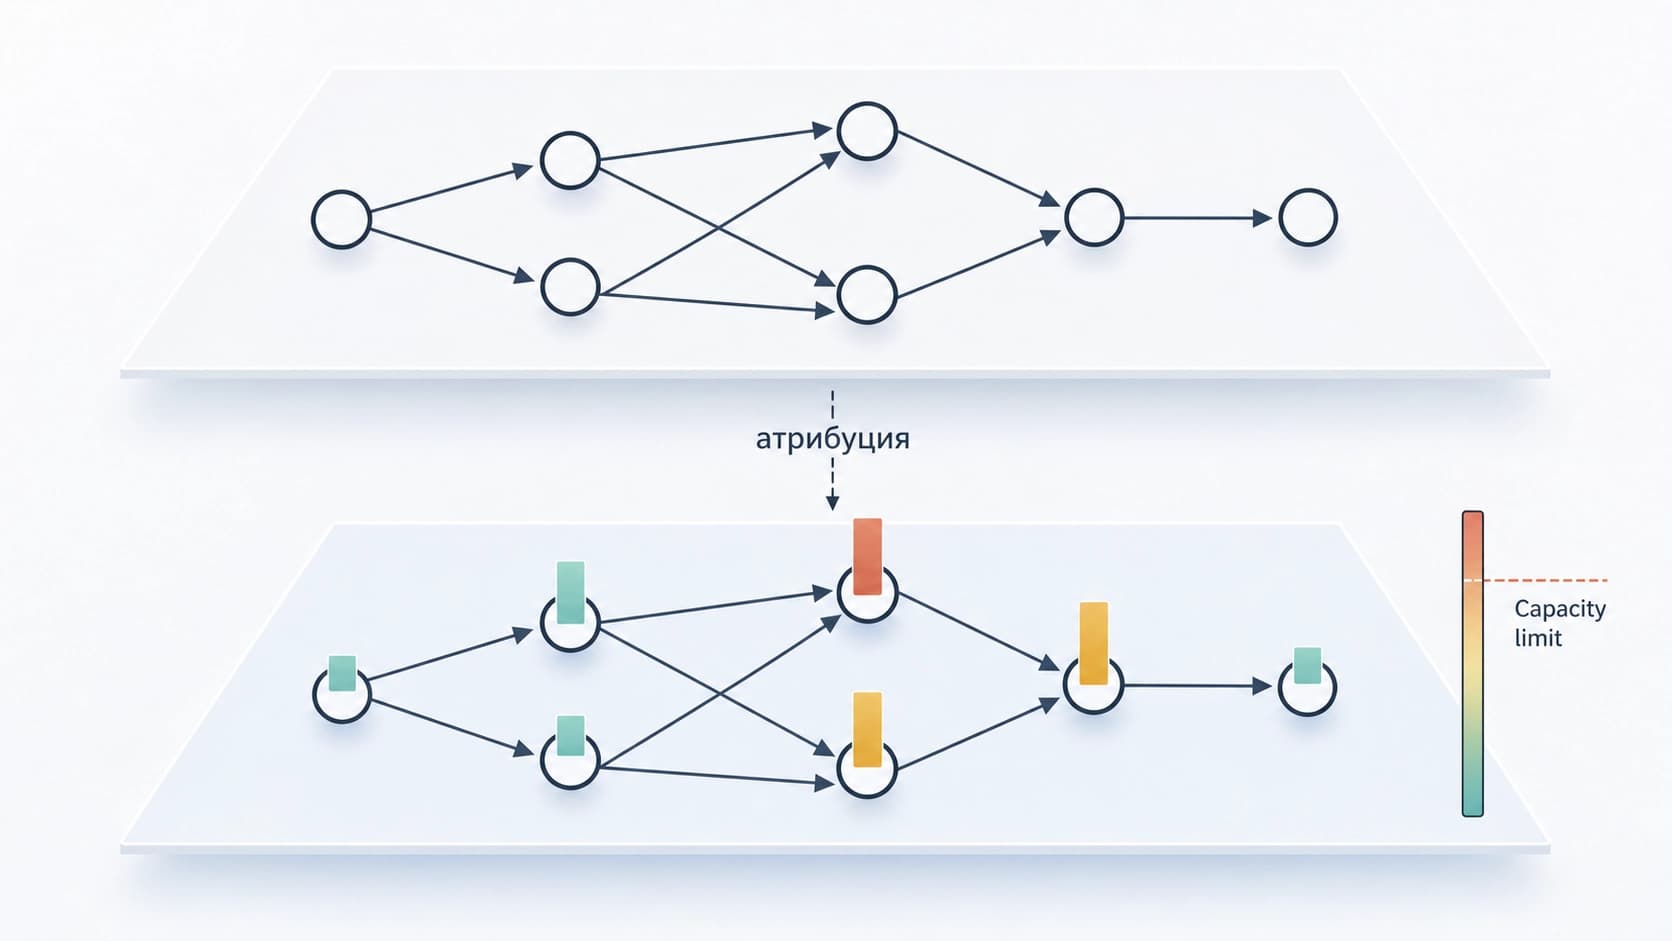
ऐसी प्रक्रियाओं के मूल्यांकन में केंद्रीय कठिनाई है — एट्रिब्यूशन। जब कोई रन बिखर जाता है, तो साफ़ नहीं होता कि दोष किसका है: एजेंट ने निर्भरताएँ गलत समझीं, या सही समझीं पर उपलब्ध संसाधनों की गिनती नहीं की, या दोनों एक साथ। सब कुछ एक ही सफलता मेट्रिक में डाल देना — सबसे उपयोगी चीज़ गँवा देना है।
इसलिए मूल्यांकन दो हिस्सों में बाँटा गया है। एक माप तार्किक योजना के लिए ज़िम्मेदार है: चरणों का क्रम, निर्भरताओं की सहीता, गढ़े हुए संबंधों का अभाव। दूसरा — भौतिक योजना के लिए, यानी असली बंदिशों को ध्यान में रखते हुए शेड्यूलिंग। इन मापों की मेट्रिक्स अपनी-अपनी हैं, और एक में विफलता दूसरे की सफलता को नहीं छिपाती।
गलत क्रम और गलत बजट — अलग-अलग बीमारियाँ
दो-हिस्सों वाली योजना किसी सुंदर वर्गीकरण के लिए नहीं, बल्कि निदान के लिए चाहिए। अगर एजेंट ने तर्क के स्तर पर गलती की है, तो उसे कोटे के आकार के बारे में बताना बेकार है — उसने समझा ही नहीं कि क्या किस पर निर्भर है। अगर तर्क ठीक है और निष्पादन गिरता है, तो समस्या शेड्यूलर में है या उस तरीके में जिससे एजेंट को उपलब्ध संसाधनों की जानकारी दी गई।
एजेंटिक सिस्टम बनाने वालों के लिए व्यावहारिक निष्कर्ष: कुछ ठीक करने से पहले यह समझना चाहिए कि ख़राबी इन दो परतों में से किससे जुड़ी है। प्रॉम्प्ट-इंजीनियरिंग, ट्रैजेक्टरी पर प्रशिक्षण और टूल्स में सुधार बिल्कुल अलग-अलग ख़राबियाँ ठीक करेंगे।
मुख्य नतीजा: साफ़-सुथरा तर्क ओवरलोड से नहीं बचाता
काम के सबसे अप्रिय निष्कर्षों में से एक यह है: मज़बूत तार्किक योजना संसाधन-सीमाओं के तहत न सुरक्षित और न ही कुशल निष्पादन की गारंटी देती है। एजेंट निर्भरता का ग्राफ़ बेदाग़ बना सकता है — और फिर भी जो कुछ किनारों से नहीं जुड़ा है, वह सब एक साथ चलाकर सिस्टम गिरा सकता है।
संसाधनों का खुलासा preventable ओवरफ़्लो की संख्या घटाता है
दूसरा अवलोकन: अगर एजेंट को उपलब्ध संसाधनों की जानकारी दी जाए, तो रोके जा सकने वाले ओवरफ़्लो की संख्या घटती है और उपयोग बढ़ता है। यह कोई जादू या नई आर्किटेक्चर नहीं है — बस संदर्भ में टूल्स के विवरण के साथ-साथ वे बजट भी आ जाते हैं जिनमें रहना है।
यहाँ असर को ज़्यादा नहीं आँकना चाहिए। बात यह है कि संसाधनों पर पारदर्शिता एक सस्ता और काम करने वाला हस्तक्षेप है, यह नहीं कि वह समस्या पूरी तरह हल कर देता है: एजेंट को अब भी इस जानकारी का समझदारी से इस्तेमाल करना होगा।
यह किसके काम आएगा
बेंचमार्क को एजेंटों के संसाधन-जागरूक व्यवहार के निदान के लिए एक स्टैंड के रूप में सोचा गया है, और यही इसका मुख्य उद्देश्य है। यह ज़्यादा अंतिम स्कोर देता है, कम यह दिखाता है कि मॉडल में दरार ठीक कहाँ पड़ती है: निर्भरताओं की समझ में या खर्च के अनुशासन में।
यहाँ से कई उपयोग-परिदृश्य निकलते हैं। एजेंटिक फ़्रेमवर्क बनाने वालों के लिए — शेड्यूलर को प्रोडक्शन से पहले परखने का तरीका, घटना के बाद नहीं। शोधकर्ताओं के लिए — संदर्भ में बजट के साथ प्रयोगों के लिए पुनरुत्पाद्य सेटअप। जो कड़ी सीमाओं वाले काम के लिए मॉडल चुनते हैं, उनके लिए — मॉडलों के बीच वह फ़र्क़ देखने का मौक़ा, जो सफलता के सामान्य परीक्षण बस नहीं दिखाते।
क्या ध्यान में रखना चाहिए
इस दृष्टिकोण की एक साफ़ प्रवेश-क़ीमत है: संसाधन प्रोफ़ाइल मापनी पड़ती हैं, और निर्भरताएँ अंकित करनी पड़ती हैं। असली सिस्टमों में सीमाएँ शोर करती हैं, बाहरी सेवाएँ लोड के तहत व्यवहार बदल देती हैं, और कॉल की क़ीमत हमेशा पहले से पता नहीं होती। यहाँ प्रयोगशाला की सफ़ाई मैदान से ज़्यादा है, और निष्कर्षों को जस का तस प्रोडक्शन पर लागू नहीं करना चाहिए।
लेकिन यह ढाँचा बेंचमार्क के बिना भी उपयोगी है। दो सवाल — "एजेंट ने सही समझा कि क्या किस पर निर्भर है" और "क्या वह बजट में रहा" — किसी भी एजेंटिक सिस्टम से पूछना समझदारी है, भले ही उन्हें जाँचने के लिए कोई तैयार स्टैंड हाथ में न हो।